Comprendre ce que le modèle a appris
Importances par gain, permutation et SHAP, dépendance partielle, et une analyse d'erreurs qui trouve pourquoi le modèle rate un balayage jamais vu, puis en corrige une partie avec une feature.
Mastering AI · Phase technique · Semaine 2 · Partie 19
Objectif de l’étape
La partie 18 nous a donné une mesure honnête : LightGBM réglé par Optuna, folds temporels, et un leave-one-workload-out qui montre que le modèle perd 3 points d’AUC sur un workload contenant un comportement jamais vu (le balayage). Un score dit à quel point le modèle fonctionne. Il ne dit pas ce qu’il regarde, ni pourquoi il échoue.
À la fin de cet article, tu sauras :
- calculer et distinguer trois importances de features : gain, nombre de coupes et permutation ;
- expliquer ce qu’est une valeur de Shapley, calculer les valeurs SHAP d’un modèle d’arbres, et les vérifier ;
- lire une courbe de dépendance partielle sans la surinterpréter ;
- mener une analyse d’erreurs structurée qui trouve le coupable, puis tester une nouvelle feature sans toucher au test.
Notions clés
1. Trois façons de dire « cette feature compte »
Intuition. Demander « quelle feature compte le plus ? », c’est comme demander « quel joueur compte le plus ? » : la réponse dépend de ce qu’on compte, les buts, les minutes sur le terrain, ou ce que l’équipe perd quand ce joueur reste sur le banc.
| Importance | Ce qu’elle compte | Calculée sur | Biais principal |
|---|---|---|---|
| Nombre de coupes (split) | combien de fois la feature sert à couper | l’entraînement | favorise les features continues, qui offrent beaucoup de seuils |
| Gain | réduction totale de la perte apportée par ses coupes | l’entraînement | mesure ce que le modèle a utilisé, pas ce qui généralise |
| Permutation | de combien le score chute quand on mélange la colonne | des données mises de côté | sous-estime les features corrélées |
L’importance par permutation est la plus honnête des trois, parce qu’elle se mesure sur des données que le modèle n’a pas vues, avec la métrique qui t’intéresse. Mais elle a un piège : si deux features portent la même information (ici acces_t, depuis_dernier et phase, à égalité en partie 17), mélanger l’une ne coûte presque rien, puisque le modèle retrouve l’information dans l’autre. Une importance par permutation faible ne veut pas dire « information inutile », elle veut dire « information disponible ailleurs ».
2. Les valeurs de Shapley : partager une prédiction équitablement
Intuition. Une équipe de joueurs gagne un prix. Comment le partager équitablement ? On fait entrer les joueurs un par un dans un ordre au hasard, et chacun reçoit le gain qu’il apporte au moment où il arrive. On fait la moyenne sur tous les ordres possibles : c’est la valeur de Shapley (1953).
Pour un modèle et un exemple , les « joueurs » sont les features et le « prix » est la prédiction. Avec la prédiction attendue quand on ne connaît que les features de :
Le poids est simplement la probabilité que, dans un ordre au hasard, ce soient exactement les joueurs de qui arrivent avant . La propriété clé est l’efficacité : les contributions s’additionnent exactement pour redonner la prédiction.
est la sortie moyenne du modèle, une espérance au sens de Required Maths M7. Chaque dit de combien la feature pousse cette prédiction au-dessus ou en dessous de cette moyenne. Pour LightGBM, est le log-odds (la marge avant la sigmoïde) : les s’additionnent en log-odds, pas en probabilité.
Avec
features, la formule a
termes par feature. TreeSHAP (Lundberg et al., 2018) les calcule exactement pour les arbres, en temps polynomial, en descendant les branches. LightGBM l’implémente nativement : predict(..., pred_contrib=True). La bibliothèque shap donne les mêmes valeurs.
SHAP en tire deux lectures :
- locale : les
d’un exemple expliquent une décision (« cette région est prédite froide surtout parce que
moy_100est nulle ») ; - globale : la moyenne des sur beaucoup d’exemples classe les features.
3. La dépendance partielle
Intuition. « Que prédit le modèle, en moyenne, si je force phase à 0,9 partout ? » On recommence pour une grille de valeurs : c’est la courbe de dépendance partielle.
C’est la forme de la courbe que les importances cachent : croissante, bosse, seuil. La précaution : forcer une valeur crée des lignes impossibles quand les features sont liées. Ici phase = depuis_dernier / periode_estimee : forcer phase à 0,9 en gardant depuis_dernier = 0 n’a aucun sens physique. Lis la DP comme « ce que fait le modèle », jamais comme « ce que fait le monde ».
4. L’analyse d’erreurs structurée
Intuition. Un score global fait la moyenne des bons et des mauvais cas. Il faut découper pour trouver où le modèle se trompe, et comparer à une référence pour savoir si l’erreur est évitable.
La démarche :
- Découper les erreurs selon un axe qui a un sens : le comportement de la région, le workload, la période (avant/après le changement de régime).
- Comparer à une référence qui pourrait faire mieux : ici, le modèle qui a vu le workload. La différence de perte, la perte en excès, sépare les erreurs évitables des erreurs dues au bruit.
- Expliquer la tranche coupable avec SHAP : quelles features poussent dans le mauvais sens ?
- Proposer une feature qui corrige la cause, et décider sur la validation, pas sur le test.
L’étape 2 compte : trier les régions par perte brute désigne les régions les plus bruitées (les rafales, imprévisibles par nature), pas celles que le modèle devrait réussir.
Exemple de code
Comme en parties 15 à 18, on reprend tel quel le script de la partie 14, puis on ajoute les trois blocs ci-dessous à la suite. On réutilise les trois workloads de la partie 18 et les réglages trouvés par Optuna (arrondis : 40 feuilles, taux 0,044, 101 arbres, min_child_samples 37), ce qui déplace d’au plus un millième le tableau leave-one-workload-out de la partie 18. L’ensemble tourne en une minute environ (numpy 2.5, pandas 3.0, scikit-learn 1.9, lightgbm 4.7).
Trois importances, SHAP et dépendance partielle
simuler_workload est celui de la partie 18, avec un ajout : il renvoie aussi la vraie nature de chaque région (on la connaît parce qu’on l’a simulée, ce que les vraies traces ne nous donneront pas). Les tirages sont les mêmes, donc les traces sont identiques.
# Suite du script de la partie 14 : df, FEATURES, H, T, T_CHANGEMENT, TYPES, N_REGIONS, TAILLE_BLOC,
# simuler_segment, construire_dataset, np, pd et roc_auc_score sont déjà définis.
import lightgbm as lgb
from sklearn.inspection import permutation_importance

t_test = 1800
# Les réglages trouvés par Optuna en partie 18 (arrondis)
P = dict(num_leaves=40, learning_rate=0.044, n_estimators=101, min_child_samples=37)


def simuler_workload(graine, types, p, cycle_balayage=240):
    """Le simuler_workload de la partie 18 (mêmes tirages, mêmes traces), qui renvoie
    aussi la nature de chaque région avant et après T_CHANGEMENT."""
    r = np.random.default_rng(graine)
    acces = np.zeros((N_REGIONS, T), dtype=int)
    nature = np.empty((N_REGIONS, 2), dtype=object)
    temps = np.arange(T)
    for bloc in range(N_REGIONS // TAILLE_BLOC):
        avant = r.choice(types, p=p)
        apres = r.choice(types, p=p) if r.random() < 0.4 else avant
        for reg in range(bloc * TAILLE_BLOC, (bloc + 1) * TAILLE_BLOC):
            nature[reg] = avant, apres
            for debut, fin, type_ in [(0, T_CHANGEMENT, avant), (T_CHANGEMENT, T, apres)]:
                if type_ == "balayage":
                    actif = (temps[debut:fin] - 2 * reg) % cycle_balayage < 2
                    acces[reg, debut:fin] = actif * r.poisson(6, fin - debut)
                else:
                    acces[reg, debut:fin] = simuler_segment(type_, fin - debut, r)
    return acces, nature


acces_jvm, nature_jvm = simuler_workload(11, TYPES, [0.7, 0.1, 0.1, 0.1])
acces_ana, nature_ana = simuler_workload(12, TYPES + ["balayage"], [0.1, 0.15, 0.25, 0.1, 0.4])
workloads = {"mixte": df[FEATURES + ["region", "t", "y"]],
             "jvm": construire_dataset(acces_jvm),
             "analytique": construire_dataset(acces_ana)}
tous = pd.concat([d.assign(workload=nom) for nom, d in workloads.items()], ignore_index=True)
avant, apres = tous[tous.t < t_test - H], tous[tous.t >= t_test]


def ajuster(d, feats=FEATURES):
    return lgb.LGBMClassifier(**P, random_state=0, verbose=-1).fit(d[feats], d.y)


# 1. Trois importances, SHAP et dépendance partielle sur le workload mixte
dev, test = avant[avant.workload == "mixte"], apres[apres.workload == "mixte"]
modele = ajuster(dev)
print(f"AUC test : {roc_auc_score(test.y, modele.predict_proba(test[FEATURES])[:, 1]):.3f}")
gain = modele.booster_.feature_importance("gain")
coupes = modele.booster_.feature_importance("split")
perm = permutation_importance(modele, test[FEATURES], test.y, scoring="roc_auc",
                              n_repeats=5, random_state=0)

echantillon = test.sample(20_000, random_state=0)
contrib = modele.booster_.predict(echantillon[FEATURES], pred_contrib=True)  # TreeSHAP : 9 colonnes + phi_0
phi, phi0 = contrib[:, :-1], contrib[0, -1]
marge = modele.booster_.predict(echantillon[FEATURES], raw_score=True)      # log-odds
print(f"phi_0 = {phi0:.3f} | max |phi_0 + somme(phi) - marge| = {np.abs(phi0 + phi.sum(1) - marge).max():.1e}")

tableau = pd.DataFrame({"gain %": 100 * gain / gain.sum(),
                        "coupes %": 100 * coupes / coupes.sum(),
                        "permutation": perm.importances_mean,
                        "moyenne |SHAP|": np.abs(phi).mean(0)}, index=FEATURES)
print(tableau.sort_values("moyenne |SHAP|", ascending=False).round(3))

# Dépendance partielle de phase : on force la valeur sur toutes les lignes, on moyenne la prédiction
grille = [0, 0.25, 0.5, 0.75, 0.9, 1.0, 1.5, 2, 5]
dp_phase = [modele.predict_proba(echantillon[FEATURES].assign(phase=v))[:, 1].mean() for v in grille]
print("DP(phase) :", dict(zip(grille, np.round(dp_phase, 3))))
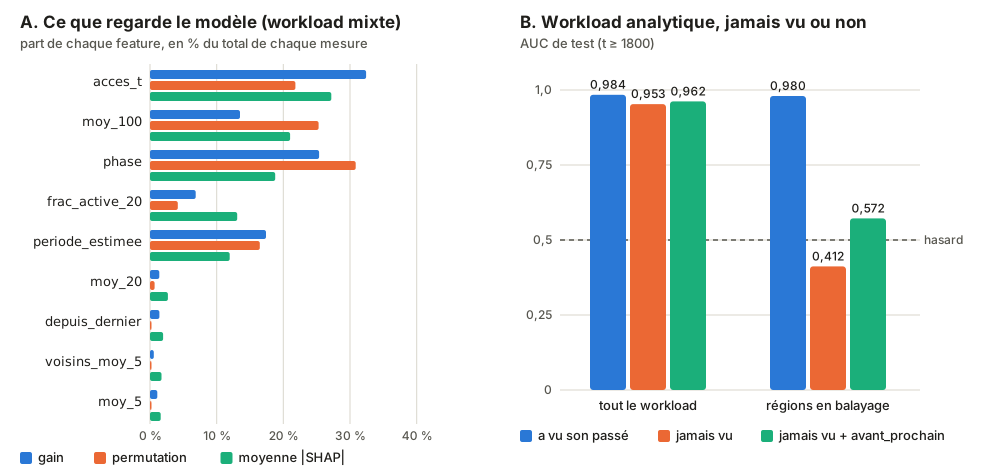
Sortie : AUC de test 0,873, (une probabilité moyenne d’environ 0,26 une fois passée dans la sigmoïde), et une erreur d’efficacité de : les contributions redonnent bien la prédiction, à la précision machine près.
| Feature | Gain % | Coupes % | Permutation (AUC perdue) | Moyenne |SHAP| |
|---|---|---|---|---|
acces_t |
32,4 | 2,6 | 0,094 | 0,678 |
moy_100 |
13,5 | 21,3 | 0,109 | 0,524 |
phase |
25,4 | 14,8 | 0,133 | 0,468 |
frac_active_20 |
6,9 | 13,2 | 0,018 | 0,326 |
periode_estimee |
17,4 | 30,6 | 0,071 | 0,298 |
moy_20 |
1,4 | 4,6 | 0,003 | 0,067 |
depuis_dernier |
1,4 | 7,2 | 0,001 | 0,049 |
voisins_moy_5 |
0,6 | 2,3 | 0,001 | 0,043 |
moy_5 |
1,1 | 3,3 | 0,001 | 0,040 |
- Les trois mesures ne donnent pas le même classement.
periode_estimeeest la feature la plus utilisée (30,6 % des coupes) mais seulement cinquième selon SHAP : c’est une variable continue avec beaucoup de seuils, ce que le nombre de coupes récompense.acces_tsert dans 2,6 % des coupes mais apporte 32,4 % du gain : quelques coupes, près de la racine, qui font l’essentiel du travail. - Elles s’accordent sur l’essentiel. Cinq features (
acces_t,moy_100,phase,frac_active_20,periode_estimee) portent presque tout ; les quatre autres valent moins de 3 % chacune, quelle que soit la mesure. depuis_derniern’est pas inutile, elle est redondante. C’est l’information de LRU, et la mélanger coûte 0,001 d’AUC. L’exercice 1 montre qu’une foisacces_tretirée, son importance par permutation monte à 0,091 : l’information est là, le modèle la lit simplement ailleurs.
Dépendance partielle de phase (prédiction moyenne sur 20 000 lignes du test) :
phase |
0 | 0,25 | 0,5 | 0,75 | 0,9 | 1,0 | 1,5 | 2 | 5 |
|---|---|---|---|---|---|---|---|---|---|
| DP | 0,238 | 0,244 | 0,312 | 0,411 | 0,412 | 0,268 | 0,278 | 0,284 | 0,319 |
Le modèle a appris une bosse entre 0,5 et 0,9, celle que l’arbre de profondeur 3 trouvait déjà en partie 17 : « on approche de la prochaine activation ». Au-delà de 1, le cycle est manqué et la région redevient froide. Attention au bord gauche : phase = 0 veut dire « accédée à l’instant », donc la forcer sur une région silencieuse depuis 50 agrégations crée une ligne qui ne peut pas exister. Le 0,238 fait la moyenne de beaucoup de lignes de ce genre : c’est exactement la précaution de la section 3.
Analyse d’erreurs : pourquoi le balayage est raté
On revient au workload analytique de la partie 18 et on compare deux modèles sur les mêmes lignes de test : celui qui n’a jamais vu ce workload (leave-one-workload-out) et celui qui a vu son passé (intra).
# 2. Analyse d'erreurs : où se trompe le modèle qui n'a jamais vu « analytique » ?
ana = apres[apres.workload == "analytique"].copy()
ana["nature"] = np.where(ana.t < T_CHANGEMENT, nature_ana[ana.region, 0], nature_ana[ana.region, 1])
lowo = ajuster(avant[avant.workload != "analytique"])     # n'a jamais vu ce workload
intra = ajuster(avant[avant.workload == "analytique"])    # a vu son passé


def log_loss_ligne(y, p):
    p = np.clip(p, 1e-7, 1 - 1e-7)
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))


for nom, m in [("lowo", lowo), ("intra", intra)]:
    ana["p_" + nom] = m.predict_proba(ana[FEATURES])[:, 1]
    ana["perte_" + nom] = log_loss_ligne(ana.y, ana["p_" + nom])
ana["exces"] = ana.perte_lowo - ana.perte_intra            # ce que coûte le fait de ne pas avoir vu le workload


def auc_par_nature(col):
    return ana.groupby("nature").apply(lambda d: roc_auc_score(d.y, d[col]) if d.y.nunique() > 1 else np.nan)


g = ana.groupby("nature")
print(pd.DataFrame({"lignes": g.size(), "positifs": g.y.mean(),
                    "AUC lowo": auc_par_nature("p_lowo"), "AUC intra": auc_par_nature("p_intra"),
                    "perte en excès": g.exces.sum()}).round(3))
regions = ana.groupby("region").agg(nature=("nature", "last"), perte_moy=("perte_lowo", "mean"),
                                    exces=("exces", "sum"))
print("20 pires régions, par perte moyenne :", regions.nlargest(20, "perte_moy").nature.value_counts().to_dict())
print("20 pires régions, par excès :       ", regions.nlargest(20, "exces").nature.value_counts().to_dict())

# Que dit SHAP des régions en balayage juste avant leur lecture ?
bal = ana[(ana.nature == "balayage") & (ana.y == 1)]
c = lowo.booster_.predict(bal[FEATURES], pred_contrib=True)
print(f"balayage, y = 1 : p moyen {bal.p_lowo.mean():.3f} (modèle intra : {bal.p_intra.mean():.3f}), {len(bal)} lignes")
print("médianes :", bal[["depuis_dernier", "periode_estimee", "phase", "moy_100", "frac_active_20"]].median().to_dict())
print("SHAP moyen :", dict(zip(FEATURES, c[:, :-1].mean(0).round(3))), "| phi_0", round(c[0, -1], 3))
| Comportement | Lignes | Positifs | AUC jamais vu | AUC a vu son passé | Perte en excès |
|---|---|---|---|---|---|
| balayage | 45 200 | 4,7 % | 0,412 | 0,980 | +8 560 |
| chaude | 36 920 | 99,9 % | 0,549 | 0,555 | +129 |
| froide | 10 720 | 9,2 % | 0,513 | 0,500 | −269 |
| periodique | 13 080 | 36,2 % | 0,985 | 0,931 | −2 466 |
| rafale | 8 320 | 28,8 % | 0,676 | 0,684 | +233 |
- Le balayage explique tout, et plus. L’excès total vaut +6 187 ; le balayage seul pèse +8 560. Ailleurs, le modèle qui n’a jamais vu le workload fait mieux sur les régions périodiques (0,985 contre 0,931) : il a été entraîné sur jvm, à 70 % périodique, il a donc vu beaucoup plus de cycles.
- Sur les régions en balayage, l’AUC de 0,412 est sous le hasard. Le modèle classe les régions « sur le point d’être lues » en dessous des régions « silencieuses ». Ce n’est pas qu’il ne sait pas : il se trompe avec assurance.
- Trier par perte brute désigne d’autres coupables. Les 20 régions à la plus forte perte moyenne sont 8 rafales, 6 froides et 6 balayages : les rafales sont difficiles pour tout modèle. Triées par excès, les 20 sont des balayages. C’est la raison de l’étape 2 de la démarche.
- Les AUC des chaudes et des froides veulent peu dire. 99,9 % de positifs d’un côté, des accès de Poisson à 0,01 de l’autre : il n’y a presque rien à classer.
Ce que dit SHAP des régions en balayage juste avant leur lecture (2 126 lignes avec
) : le modèle leur donne en moyenne 0,166, contre 0,853 pour le modèle intra. Leurs médianes : depuis_dernier 232, periode_estimee 240, phase 0,975, moy_100 0 et frac_active_20 0. Contributions moyennes :
| Feature | moyen |
|---|---|
moy_100 |
−0,545 |
frac_active_20 |
−0,399 |
periode_estimee |
−0,190 |
depuis_dernier |
−0,095 |
phase |
+0,196 |
Le diagnostic se lit directement : phase dit « ça arrive » (0,975, en plein dans la bosse), mais le modèle n’a vu que des cycles de 15 à 60 agrégations. Pour lui, une région silencieuse depuis 100 agrégations (moy_100 = 0, frac_active_20 = 0) et de période 240 est une région froide, et ces deux signaux l’emportent. L’information utile était là ; elle était seulement exprimée relativement à la période, alors que le label est défini en temps absolu (
agrégations).
Une feature dans l’unité du label
D’où l’idée : le nombre d’agrégations restant avant le prochain début attendu, avant_prochain = periode_estimee − depuis_dernier. Pour une région périodique de période 30 comme pour un balayage de période 240, « avant_prochain entre 1 et 10 » veut dire la même chose : l’activation tombe dans la fenêtre du label. Un arbre entraîné sur des régions périodiques apprend ce seuil, et il se transpose au balayage sans l’avoir vu.
On décide sur la validation (entraînement , validation , le découpage de la partie 15), puis on confirme une seule fois sur le test.
# 3. Une feature dans l'unité du label : agrégations avant le prochain début attendu
tous["avant_prochain"] = tous.periode_estimee - tous.depuis_dernier
F2 = FEATURES + ["avant_prochain"]

# a) Décider sans toucher au test : entraînement t < 1390, validation 1400 <= t < 1790
tr = tous[tous.t < 1390]
va = tous[(tous.t >= 1400) & (tous.t < 1790) & (tous.workload == "analytique")]
for feats in (FEATURES, F2):
    m = ajuster(tr[tr.workload != "analytique"], feats)
    print(f"{len(feats)} features | validation, analytique jamais vu : "
          f"{roc_auc_score(va.y, m.predict_proba(va[feats])[:, 1]):.3f}")

# b) Confirmer une seule fois sur le test, avec les trois protocoles de la partie 18
avant, apres = tous[tous.t < t_test - H], tous[tous.t >= t_test]
for nom in workloads:
    te = apres[apres.workload == nom]
    ligne = []
    for feats in (FEATURES, F2):
        for d in (avant[avant.workload == nom], avant[avant.workload != nom], avant):
            ligne.append(roc_auc_score(te.y, ajuster(d, feats).predict_proba(te[feats])[:, 1]))
    print(f"{nom:>10} | 9 features {np.round(ligne[:3], 3)} | + avant_prochain {np.round(ligne[3:], 3)}")

# Et sur les seules régions en balayage, pour le modèle qui ne les a jamais vues
te = apres[apres.workload == "analytique"].assign(nature=ana.nature.values)
m = ajuster(avant[avant.workload != "analytique"], F2)
s = te.nature == "balayage"
print(f"balayage seul, jamais vu : AUC {roc_auc_score(te.y[s], m.predict_proba(te[F2][s])[:, 1]):.3f}")
Sur la validation, le modèle qui n’a jamais vu le workload analytique passe de 0,964 à 0,971 avec avant_prochain : on garde la feature. Confirmation sur le test, avec les trois protocoles de la partie 18 :
| Workload | Intra | Jamais vu | Trois workloads | Intra + avant_prochain |
Jamais vu + avant_prochain |
Trois + avant_prochain |
|---|---|---|---|---|---|---|
| mixte | 0,873 | 0,865 | 0,874 | 0,875 | 0,868 | 0,879 |
| jvm | 0,980 | 0,980 | 0,985 | 0,985 | 0,983 | 0,986 |
| analytique | 0,984 | 0,953 | 0,988 | 0,985 | 0,962 | 0,988 |
- La feature aide partout, et surtout là où elle devait aider. L’analytique jamais vu passe de 0,953 à 0,962 : elle récupère presque un tiers des 3,1 points perdus. Aucune case ne se dégrade.
- Mais elle ne résout pas le balayage. Sur les seules régions en balayage, l’AUC monte de 0,412 à 0,572, loin des 0,980 d’un modèle qui a vu des balayages. Une bonne feature rend l’information lisible ; elle ne remplace pas le fait d’avoir vu le comportement.
- Le gain se confirme dans les folds. Dans la validation croisée temporelle de la partie 18 sur le workload mixte,
avant_prochainaméliore les quatre folds (exercice 3). Un gain qui n’apparaîtrait que sur le test aurait été suspect.
Fil rouge : ce que ça change pour le mémoire
- Q1 et H1 ont maintenant une méthode. « La périodicité et le voisinage sont-ils les features les plus prédictives ? » se tranche avec les trois mesures côte à côte, sur des données mises de côté, pas avec l’importance par défaut de LightGBM (le nombre de coupes). Sur notre simulation : la périodicité, oui (
phase+periode_estimeepèsent 47 % de l’importance par permutation et 31 % de la moyenne des |SHAP|), le voisinage, non (voisins_moy_5pèse au plus 2,3 % des coupes et moins de 2 % selon les trois autres mesures). Prudence : ce verdict est celui de la simulation, où les voisines partagent la même nature mais pas la même phase. Seules les vraies traces DAMON peuvent trancher H1. - Rapporte les importances avec leurs limites. Signale toujours les groupes redondants (
acces_t/depuis_dernier/phase) : une feature « inutile » en permutation peut devenir la seule si on retire sa jumelle. L’exercice 1 donne les chiffres. - L’analyse d’erreurs est un chapitre, pas une annexe. Le tableau de perte en excès par comportement, avec l’explication SHAP de la tranche coupable, est exactement le genre de résultat qu’attend un jury : il dit pourquoi le modèle échoue, pas seulement de combien.
- Exprime les features dans l’unité du label. L’horizon
sera un paramètre du démon (combien de temps à l’avance protéger une page de zswap). Les features mesurées dans la même unité (
avant_prochain) généralisent mieux que les features relatives (phase) quand les périodes changent d’un workload à l’autre. - Pour le LSTM (partie 23), SHAP reste applicable (
shap.DeepExplainer, ou les gradients intégrés), mais on perd l’exactitude de TreeSHAP. C’est un argument en faveur de LightGBM si les deux modèles finissent avec des scores proches.
Exercice pratique
- Features corrélées. Réentraîne le modèle du workload mixte sans
acces_t, puis recalcule l’importance par permutation. Que devient l’AUC ? Et l’importance dedepuis_dernier? Qu’est-ce que ça t’apprend sur la phrase « cette feature est inutile » ? - Vérifier avec la bibliothèque
shap. Installeshapet calculeshap.TreeExplainer(modele).shap_values(echantillon[FEATURES]). Compare avecphi(plus grand écart absolu) et avec le temps de calcul depred_contrib. - Confirmer en validation croisée. Reprends
folds_temporelsetscore_cvde la partie 18 (avecPet la période de développement du workload mixte) pour comparerFEATURESetF2fold par fold. Le gain est-il positif sur les quatre folds ? Est-il plus grand que la dispersion entre folds ? - Une feature de voisinage pour le balayage. Dans un balayage, les régions avant
regsont lues juste avant elle. Construisamont_moy_5, la moyenne de l’activité glissante sur 5 agrégations des régionsreg - 4àreg - 1, ajoute-la àF2, et mesure l’analytique jamais vu. Explique le résultat avec ce que cet article a montré. - Fil rouge. Pour chacun de tes vrais workloads, produis le tableau de perte en excès par tranche. Sans « vraie nature » disponible sur les traces DAMON, quelles tranches utiliserais-tu ? (Piste : plages d’adresses, classes de
periode_estimee, avant/après un changement de phase connu du programme.)
Indices. Question 1 : AUC 0,873 → 0,872 ; l’importance par permutation de depuis_dernier passe de 0,001 à 0,091. Question 2 : plus grand écart 0,0 (valeurs identiques) ; sur notre machine à deux cœurs, environ 7 s pour 20 000 lignes dans les deux cas (6,96 s avec pred_contrib, 7,38 s avec shap). Question 3 : 0,9052 · 0,8998 · 0,9073 · 0,9190 (moyenne 0,9078) → 0,9063 · 0,9041 · 0,9076 · 0,9194 (moyenne 0,9093) ; un gain de 0,0011 · 0,0043 · 0,0003 · 0,0004, positif sur les quatre folds mais plus petit que l’écart-type entre folds. Question 4 : 0,962 → 0,962, aucun gain : le modèle n’a jamais vu de cas où l’activité en amont annonce une lecture, il n’a donc pas appris à s’en servir. Seules des données d’entraînement contenant des balayages rendraient cette feature utile.
Ressources pour aller plus loin
- Lundberg et Lee, A Unified Approach to Interpreting Model Predictions (NeurIPS 2017) : SHAP et ses propriétés.
- Lundberg et al., From local explanations to global understanding with explainable AI for trees (Nature Machine Intelligence, 2020) : TreeSHAP exact.
- Christoph Molnar, Interpretable Machine Learning, chapitres sur l’importance par permutation, la dépendance partielle et les valeurs de Shapley.
- Documentation scikit-learn : Permutation feature importance (section sur les features corrélées) et Partial Dependence and Individual Conditional Expectation plots.
- Rappel : M7 · Variables aléatoires, lois, espérance et variance, pour .
Ce que tu dois savoir faire avant de passer à la suite
- Expliquer la différence entre importance par gain, par nombre de coupes et par permutation, et le biais de chacune
- Expliquer pourquoi une feature redondante paraît inutile en importance par permutation
- Énoncer la propriété d’efficacité des valeurs de Shapley et la vérifier sur un modèle LightGBM
- Calculer des valeurs SHAP avec
pred_contrib=Trueet les lire localement et globalement - Calculer une courbe de dépendance partielle et repérer les lignes impossibles qu’elle crée
- Mener une analyse d’erreurs par tranches, avec une perte en excès face à un modèle de référence
- Proposer une feature à partir d’un diagnostic et la valider sans toucher au test
Partie suivante : Apprentissage non supervisé : explorer sans labels (partie 20). Ici on a triché : on connaissait la vraie nature de chaque région. Sur les vraies traces DAMON, on ne l’aura pas ; on verra comment le clustering peut retrouver ces familles de comportements à partir des seules traces d’accès, et même repérer un comportement nouveau avant que le modèle ne se trompe.