Modèles linéaires et régularisation
Régression logistique, log-loss, L1 et L2 : la baseline légère du mémoire comprise en profondeur, jusqu'à son coût d'inférence et la référence « ne jamais compresser ».
Mastering AI · Phase technique · Semaine 1 · Partie 16
Objectif de l’étape
Dans les parties 14 et 15, la régression logistique n’était qu’une ligne dans un tableau, battue par le gradient boosting. Pourtant c’est la première baseline du mémoire, et pas par politesse : elle tient en une douzaine de multiplications, on peut lire ses poids, et elle tourne sans problème dans un démon système. Avant de la remplacer par plus gros, il faut savoir exactement ce qu’elle fait.
À la fin de cet article, tu sauras :
- passer d’un score linéaire à une probabilité avec la sigmoïde, et lire un coefficient comme un effet sur la cote ;
- expliquer pourquoi on entraîne avec la log-loss et pas avec la MSE ;
- régler la régularisation
/
avec le
Cde scikit-learn, et comprendre pourquoi il faut unCaussi petit ; - aider un modèle linéaire avec des features transformées, et voir où ça ne suffit plus ;
- calculer le coût d’inférence réel d’une régression logistique en production.
Notions clés
1. De la régression linéaire à la logistique
Intuition. La régression linéaire de l’article en bas niveau sort un nombre quelconque. Pour une probabilité, il faut l’écraser entre 0 et 1 : c’est le rôle de la sigmoïde.
En inversant, on obtient la forme qui rend les coefficients lisibles :
Le membre de gauche est le log de la cote (le logit). Le modèle est donc linéaire, mais en log-cote. Conséquence pratique : si la feature augmente de 1, la cote est multipliée par , toutes les autres features restant fixes.
2. Pourquoi la log-loss et pas la MSE
Intuition. Quand le modèle se trompe avec assurance, on veut qu’il le sente fort. Avec la MSE passée dans une sigmoïde, c’est l’inverse : plus il se trompe avec assurance, plus le gradient est petit.
La log-loss (ou cross-entropie binaire) est la vraisemblance négative de Required Maths M8 :
Sa dérivée par rapport au score est d’une simplicité remarquable, alors que celle de la MSE traîne un facteur qui s’annule aux extrémités :
En prime, la log-loss est convexe en : sa hessienne vaut , avec diagonale de termes , donc elle est semi-définie positive (Required Maths M6). Pas de minimum local piège : n’importe quel solveur trouve l’optimum.
3. Régularisation
et
, et le piège du C
Intuition. On ajoute une pénalité sur la taille des poids. les rétrécit tous un peu ; en met certains exactement à zéro, ce qui fait de la sélection de features. La géométrie (boule ronde contre losange) est dans Required Maths M11.
Piège pratique : scikit-learn ne minimise pas « perte moyenne
pénalité », mais une somme de pertes multipliée par C :
En divisant par
, on retrouve la forme du cours avec
. Avec nos
exemples d’entraînement, C = 1 correspond à
: presque pas de régularisation. Pour voir un effet, il faut descendre à C
, soit
.
4. Normaliser pour lire les coefficients
Intuition. Un poids dépend de l’unité de sa feature. depuis_dernier va de 0 à 500, frac_active_20 de 0 à 1 : leurs poids bruts ne sont pas comparables. Après un StandardScaler, chaque poids se lit « effet sur la log-cote d’une hausse d’un écart-type ».
Deux mises en garde :
- normaliser est aussi indispensable pour la régularisation, sinon la pénalité frappe plus fort les features à petite échelle ;
- un coefficient est un effet toutes choses égales par ailleurs. Quand des features sont très corrélées (nos trois moyennes glissantes), ce scénario n’existe presque pas dans les données, et les signes peuvent surprendre. On le voit plus bas.
5. Ce qu’un modèle linéaire ne peut pas voir
Intuition. La log-cote est une fonction monotone de chaque feature. Or certains effets ne le sont pas. Pour une région périodique, le moment dangereux est quand phase est proche de 1 (le cycle va redémarrer) : ni trop tôt, ni trop tard. Un poids unique sur phase ne peut pas exprimer « proche de 1 ».
Deux solutions : fabriquer des features qui rendent l’effet monotone (un logarithme, une bosse autour de 1), ou passer à un modèle non linéaire (arbres, partie 17). La première garde le modèle léger.
6. Le coût d’inférence
Intuition. En production, on n’a même pas besoin de la sigmoïde. Comme est croissante, . On compare donc directement à un seuil précalculé, et on peut replier la normalisation dans les poids :
où et sont la moyenne et l’écart-type appris par le scaler. Pour features : multiplications, additions et une comparaison par région.
Exemple de code
On reprend tel quel le script de la partie 14 (simulation, features, labels), puis on ajoute les cinq blocs ci-dessous à la suite, dans le même fichier. Le découpage est celui de la partie 15 : train , validation , test (avec le changement de régime à ). L’ensemble tourne en une dizaine de secondes.
La baseline et ses coefficients
# Suite du script de la partie 14 : df, FEATURES, H, np, pd, make_pipeline, StandardScaler,
# LogisticRegression, HistGradientBoostingClassifier et roc_auc_score sont déjà définis.
import time
from sklearn.metrics import average_precision_score, log_loss

# Les trois mêmes périodes qu'en partie 15
t_val, t_test = 1400, 1800
train = df[df.t < t_val - H]
val = df[(df.t >= t_val) & (df.t < t_test - H)]
test = df[df.t >= t_test]

# 1. La baseline : standardisation + régression logistique (L2, C = 1)
lr = make_pipeline(StandardScaler(), LogisticRegression(C=1.0, max_iter=1000))
lr.fit(train[FEATURES], train.y)
p_val = lr.predict_proba(val[FEATURES])[:, 1]
print(f"logistique, validation : AUC {roc_auc_score(val.y, p_val):.3f} | "
      f"AP {average_precision_score(val.y, p_val):.3f} | log-loss {log_loss(val.y, p_val):.3f}")

w = lr[-1].coef_[0]
coefs = pd.DataFrame({"w (par écart-type)": w, "cote x": np.exp(w)}, index=FEATURES)
print(coefs.sort_values("w (par écart-type)", key=abs, ascending=False).round(2))
print(f"biais b = {lr[-1].intercept_[0]:.2f} | corr(moy_20, y) sur le train = {train.moy_20.corr(train.y):.2f}")
Sur la validation : AUC 0,808, précision moyenne 0,725, log-loss 0,447.
| Feature | (par écart-type) | Cote multipliée par |
|---|---|---|
frac_active_20 |
1,77 | 5,90 |
moy_20 |
−1,36 | 0,26 |
acces_t |
0,80 | 2,23 |
moy_100 |
0,80 | 2,23 |
moy_5 |
−0,32 | 0,73 |
periode_estimee |
−0,31 | 0,73 |
depuis_dernier |
−0,10 | 0,91 |
phase |
−0,07 | 0,93 |
voisins_moy_5 |
0,06 | 1,06 |
Le biais vaut .
- La feature la plus forte est la régularité : un écart-type de plus de
frac_active_20multiplie la cote d’être chaude par 5,9. moy_20a un poids négatif, alors que seule elle est positivement liée à la chaleur (corrélation 0,38 sur le train). Ce n’est pas une erreur : le poids mesure l’effet demoy_20àmoy_5,moy_100etfrac_active_20fixées, une situation rare puisque ces moyennes bougent ensemble. Le modèle s’en sert comme d’un terme correctif entre les échelles de temps, pas comme d’un indicateur de chaleur. C’est la mise en garde de la notion 4 : on ne lit pas un coefficient isolé quand les features sont corrélées.
Log-loss contre MSE, en chiffres
# 2. Pourquoi la log-loss plutôt que la MSE : le gradient d'une erreur très confiante
z = np.array([-6.0, -2.0, 0.0, 2.0])     # score d'une région en réalité chaude (y = 1)
p = 1 / (1 + np.exp(-z))
grad_logloss = p - 1                       # d/dz de -log(p)
grad_mse = 2 * (p - 1) * p * (1 - p)       # d/dz de (p - 1)^2
for zi, pi, gl, gm in zip(z, p, grad_logloss, grad_mse):
    print(f"z = {zi:+.0f} | p = {pi:.3f} | gradient log-loss {gl:+.3f} | gradient MSE {gm:+.4f}")
| (région vraiment chaude) | Gradient log-loss | Gradient MSE | |
|---|---|---|---|
| −6 | 0,002 | −0,998 | −0,0049 |
| −2 | 0,119 | −0,881 | −0,1850 |
| 0 | 0,500 | −0,500 | −0,2500 |
| +2 | 0,881 | −0,119 | −0,0250 |
Pour l’erreur la plus grave ( , le modèle est sûr à 99,8 % que la région est froide), la log-loss pousse avec une force de presque 1. La MSE pousse 200 fois moins fort : elle laisse le modèle dans son erreur. C’est exactement le cas qu’on veut corriger en priorité, puisqu’un faux froid coûte cher.
Chemins de régularisation et
# 3. L1 contre L2 : quelles features survivent quand la pénalité augmente ?
print(f"{len(train)} exemples d'entraînement")
for C in np.logspace(-5, -2, 7):
    for nom, l1_ratio in (("L1", 1.0), ("L2", 0.0)):
        m = make_pipeline(StandardScaler(),
                          LogisticRegression(C=C, l1_ratio=l1_ratio, solver="saga", max_iter=5000))
        m.fit(train[FEATURES], train.y)
        w_c = m[-1].coef_[0]
        auc_c = roc_auc_score(val.y, m.predict_proba(val[FEATURES])[:, 1])
        gardees = [f for f, wi in zip(FEATURES, w_c) if wi != 0]
        print(f"C = {C:.1e} | {nom} | non nuls : {len(gardees)} | somme |w| {np.abs(w_c).sum():.2f} | "
              f"AUC val {auc_c:.3f}" + (f" | {gardees}" if nom == "L1" and len(gardees) < 9 else ""))
C |
: features non nulles | : AUC val | : AUC val |
|---|---|---|---|
| 0 | 0,500 | 0,769 | |
| 0 | 0,500 | 0,774 | |
| 3 | 0,780 | 0,783 | |
| 6 | 0,786 | 0,796 | |
| 8 | 0,799 | 0,806 | |
| 9 | 0,808 | 0,809 | |
| 9 | 0,809 | 0,809 |
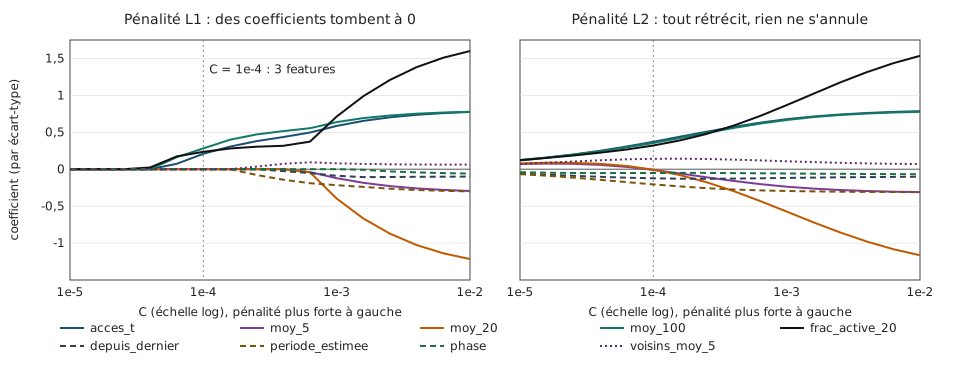
- À
C = 1e-4, ne garde que trois features :acces_t(l’instant présent),moy_100(le long terme) etfrac_active_20(la régularité). Avec elles seules, l’AUC est déjà 0,780, contre 0,809 avec les neuf. - Viennent ensuite
depuis_dernier,periode_estimeeetvoisins_moy_5(6 features), puismoy_5etmoy_20, etphaseen dernier.moy_20n’entre que tard, et c’est là qu’elle devient négative : elle ne sert qu’à corriger les autres moyennes. -
ne met jamais rien à zéro : même à
C = 1e-5, les neuf poids sont non nuls, juste petits. - Au-delà de
C = 3e-3, plus rien ne bouge : avec 123 840 exemples et 9 features, il n’y a pas de surapprentissage à combattre. Ici, la régularisation sert surtout à sélectionner, pas à généraliser.
Aider le modèle linéaire, et le comparer au boosting
# 4. Aider un modèle linéaire : des features transformées
def ajouter_features(d):
    d = d.copy()
    d["log_depuis"] = np.log1p(d.depuis_dernier)             # la récence agit en échelle log
    d["log_periode"] = np.log1p(d.periode_estimee)
    d["proche_cycle"] = np.exp(-((d.phase - 1) / 0.2) ** 2)  # ~1 quand un cycle va redémarrer
    return d


FEATURES_PLUS = FEATURES + ["log_depuis", "log_periode", "proche_cycle"]
tr, va, te = ajouter_features(train), ajouter_features(val), ajouter_features(test)
C_FAUX_FROID, C_FAUX_CHAUD = 10, 1


def cout_moyen(y, p, seuil):
    pred = p >= seuil
    return (C_FAUX_FROID * np.sum((y == 1) & ~pred) + C_FAUX_CHAUD * np.sum((y == 0) & pred)) / len(y)


seuils = np.linspace(0.01, 0.99, 99)
candidats = {
    "logistique, 9 features": (make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)), FEATURES),
    "logistique, 12 features": (make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)), FEATURES_PLUS),
    "boosting, 9 features": (HistGradientBoostingClassifier(max_iter=200, random_state=0), FEATURES),
}
print(f"ne jamais compresser : coût test {cout_moyen(te.y.to_numpy(), np.ones(len(te)), 0.5):.3f}")
ajustes, retenus = {}, {}
for nom, (m, F) in candidats.items():
    m.fit(tr[F], tr.y)
    ajustes[nom] = m
    pv, pt = m.predict_proba(va[F])[:, 1], m.predict_proba(te[F])[:, 1]
    s = seuils[int(np.argmin([cout_moyen(va.y.to_numpy(), pv, s) for s in seuils]))]
    retenus[nom] = s
    print(f"{nom:>24} | AUC val {roc_auc_score(va.y, pv):.3f} | AUC test {roc_auc_score(te.y, pt):.3f} | "
          f"seuil {s:.2f} | coût val {cout_moyen(va.y.to_numpy(), pv, s):.3f} | "
          f"coût test {cout_moyen(te.y.to_numpy(), pt, s):.3f} | compressées (test) {(pt < s).mean():.3f}")
Référence : ne jamais rien compresser coûte 0,689 par région sur le test (et 0,699 sur la validation), puisque toutes les régions froides deviennent des faux chauds.
| Modèle | AUC val | AUC test | Seuil (val) | Coût val | Coût test | Compressées (test) |
|---|---|---|---|---|---|---|
| Logistique, 9 features | 0,808 | 0,793 | 0,14 | 0,665 | 0,723 | 17,6 % |
| Logistique, 12 features | 0,832 | 0,806 | 0,05 | 0,676 | 0,694 | 1,5 % |
| Boosting, 9 features | 0,911 | 0,858 | 0,11 | 0,547 | 0,707 | 32,9 % |
| Ne jamais compresser | 0,699 | 0,689 | 0 % |
Trois leçons, dont une qui dépasse cet article :
- les trois features transformées font gagner 2,4 points d’AUC en validation (0,808 → 0,832) et 1,3 en test.
proche_cycleest celle qui apporte le plus, car elle donne au modèle linéaire la bosse « phase proche de 1 » qu’il ne peut pas fabriquer seul ; - une meilleure AUC ne garantit pas un meilleur coût. Avec 12 features, le seuil choisi descend à 0,05 : le modèle classe mieux, mais il n’isole pas un groupe assez « sûrement froid » pour qu’on ose compresser. Il ne compresse plus que 1,5 % des régions, c’est-à-dire presque rien. Avec un faux froid à 10, ce qui compte est la pureté de la zone basse des scores, pas le classement global ;
- sur la validation, le boosting bat nettement la référence (0,547 contre 0,699). Sur le test, aucun modèle ne fait mieux que « ne jamais compresser » (0,689) : le changement de régime de réveille des régions que tous les modèles croyaient froides. La partie 15 avait mesuré une baisse de coût de 31 % par rapport au seuil 0,5 ; la vraie référence est celle-ci, et c’est elle qu’il faudra battre dans le mémoire. Les parties 18 (validation par workload) et 28 (surveillance) traitent ce problème.
Le coût d’inférence
# 5. Coût d'inférence : on replie le scaler dans les poids, puis un seul produit scalaire
meilleur = ajustes["logistique, 12 features"]
scaler, clf = meilleur[0], meilleur[-1]
w_brut = clf.coef_[0] / scaler.scale_                      # poids dans les unités des features
b_brut = clf.intercept_[0] - np.sum(clf.coef_[0] * scaler.mean_ / scaler.scale_)
s = retenus["logistique, 12 features"]
z_star = np.log(s / (1 - s))                               # p >= s  <=>  z >= logit(s)
instant = te[te.t == t_test]                               # les 96 régions à une agrégation
X96 = instant[FEATURES_PLUS].to_numpy()
identique = np.allclose(X96 @ w_brut + b_brut, meilleur.decision_function(instant[FEATURES_PLUS]))
t0 = time.perf_counter()
for _ in range(10_000):
    garder = X96 @ w_brut + b_brut >= z_star
dt = (time.perf_counter() - t0) / 10_000
print(f"mêmes scores que le pipeline : {identique} | seuil en logit z* = {z_star:.3f}")
print(f"{len(w_brut)} multiplications + {len(w_brut)} additions par région | "
      f"96 régions : {dt * 1e6:.1f} µs par agrégation")
- Les scores calculés à la main avec les poids repliés sont identiques à ceux du pipeline scikit-learn.
- Le seuil 0,05 devient : aucune exponentielle à calculer en production.
- 12 multiplications et 12 additions par région. Pour les 96 régions d’une agrégation, la décision prend environ 2 µs en NumPy sur ma machine (2,1 à 2,6 µs selon les exécutions), à comparer à une période d’agrégation de 100 ms.
Fil rouge : ce que ça change pour le mémoire
- La baseline est fixée. Régression logistique standardisée,
Cchoisi sur la validation, seuil choisi sur la validation avec le coût annoncé à l’avance. Elle sert de plancher : un LSTM qui ne la bat pas nettement ne vaut pas sa complexité. - Le coût d’inférence est un argument. Pour régions DAMON, une décision coûte environ multiplications-additions par agrégation. En NumPy, sur ma machine, ça prend environ 0,4 ms (mesuré en répétant les 96 régions jusqu’à lignes) : c’est compatible avec un démon qui tourne en continu ; on mesurera la même chose pour LightGBM et le LSTM.
- comme outil d’analyse. Le chemin donne un ordre d’importance des features (régularité, intensité long terme, présent), à rapprocher de ton hypothèse H1 sur la périodicité.
- La vraie référence est « ne jamais compresser ». Chaque modèle doit être comparé à elle, en coût, sur le test. On ajoute cette ligne au protocole de la partie 15.
Exercice pratique
-
face au bruit. Ajoute 5 colonnes de bruit gaussien (
rng.normal(size=len(d))) au train et à la validation, puis refais le chemin . Jusqu’à quelCleurs poids restent-ils exactement nuls ? Qu’en déduis-tu sur les features vraiment utiles ? - Colinéarité. Retire
moy_20et réentraîne la baseline. Que deviennent l’AUC et le poids defrac_active_20? Explique avec la notion 4. - Calibration. Calcule le score de Brier du test pour la logistique à 12 features et pour le boosting (partie 15). Le modèle linéaire est-il mieux calibré ? Pourquoi est-ce important pour le seuil théorique ?
- L’écart est-il réel ? Le coût test de la logistique à 12 features (0,694) est plus bas que celui du boosting (0,707). Calcule un intervalle de confiance à 95 % sur la différence par bootstrap sur les régions (on tire 96 régions avec remise, pas des lignes, parce que les lignes d’une même région sont corrélées), avec les outils de Required Maths M9. Conclus.
- Fil rouge. Écris en C (ou en Rust) la fonction de décision d’une région : un tableau de 12 poids, un biais, un seuil . Combien d’octets fait le modèle complet ?
Indices. Question 1 : avec la graine 1 pour le bruit, les cinq poids restent nuls jusqu’à C = 1e-3, un seul devient non nul (et minuscule) à C = 1e-2. Question 2 : l’AUC de validation passe de 0,808 à 0,801 et le poids de frac_active_20 de 1,77 à 0,52. Question 3 : 0,1467 contre 0,1119. Question 4 : avec 2 000 tirages, la différence vaut −0,013 et l’intervalle est d’environ [−0,062 ; +0,039].
Ressources pour aller plus loin
- Rappel : La régression linéaire, en bas niveau.
- James, Witten, Hastie, Tibshirani, An Introduction to Statistical Learning (ISLR), chapitre 4 (classification, régression logistique) et chapitre 6 (ridge et lasso).
- Documentation scikit-learn : Logistic regression (section des modèles linéaires), et l’exemple Regularization path of L1-Logistic Regression.
- Hastie, Tibshirani, Wainwright, Statistical Learning with Sparsity (2015), chapitres 2 et 3 : pourquoi le lasso met des poids exactement à zéro.
Ce que tu dois savoir faire avant de passer à la suite
- Écrire le modèle logistique et lire un coefficient comme un facteur multiplicatif sur la cote
- Expliquer, gradient à l’appui, pourquoi la log-loss plutôt que la MSE pour la classification
- Traduire le
Cde scikit-learn en , et choisir entre et - Lire des coefficients normalisés sans tomber dans le piège des features corrélées
- Ajouter une feature transformée pour un effet non monotone
- Replier le scaler dans les poids et calculer le coût d’inférence d’une décision
- Comparer un modèle à la référence « ne jamais compresser », et pas seulement à un autre modèle
Partie suivante : Arbres, forêts et gradient boosting (partie 17). On ouvre la boîte du modèle qui gagne depuis la partie 14 : comment un arbre fabrique tout seul les seuils et les bosses qu’on a dû ajouter à la main ici.