M7 · Variables aléatoires, lois, espérance et variance
Le vocabulaire minimal pour raisonner sur l'incertain : lois usuelles, espérance, variance, covariance, loi des grands nombres, théorème central limite et autocorrélation.
Mastering AI · Required Maths · Semaine 3 (probabilités et statistiques) · Partie 7
Objectif de l’étape
Les données sont bruitées, les modèles sont entraînés sur un échantillon parmi d’autres possibles, et les prédictions sont des probabilités. Pour raisonner sur tout ça, il faut le vocabulaire des probabilités. Cet article pose les bases utilisées par les deux suivants (M8 vraisemblance, M9 tests statistiques) et par toute la phase technique.
À la fin de cet article, tu sauras :
- décrire une variable aléatoire par sa loi, son espérance et sa variance ;
- reconnaître les lois usuelles du ML et des systèmes (Bernoulli, binomiale, Poisson, normale, exponentielle, Zipf) ;
- expliquer la loi des grands nombres et le théorème central limite, et pourquoi ils comptent en pratique ;
- démontrer pourquoi moyenner des modèles réduit la variance, et pourquoi la corrélation limite ce gain ;
- calculer une autocorrélation pour détecter la périodicité d’une région mémoire.
Notions clés
1. Variable aléatoire et loi
Intuition. Une variable aléatoire est une quantité dont la valeur dépend du hasard : le nombre d’accès d’une région pendant 100 ms, le label d’un exemple tiré au hasard, l’erreur d’un modèle. Sa loi dit quelles valeurs sont possibles et avec quelle probabilité.
- Discrète (valeurs entières) : la loi est donnée par pour chaque .
- Continue (valeurs réelles) : la loi est donnée par une densité , et .
2. Espérance et variance
Intuition. L’espérance est la valeur moyenne qu’on obtiendrait en répétant l’expérience indéfiniment. La variance mesure à quel point les valeurs s’écartent de cette moyenne.
L’écart-type est dans la même unité que . Trois propriétés reviennent sans cesse :
- l’espérance est linéaire : , toujours ;
- ;
- si et sont indépendantes, .
3. Les lois usuelles
| Loi | Modélise | Espérance | Variance |
|---|---|---|---|
| Bernoulli( ) | un label 0/1, « la région est-elle accédée ? » | ||
| Binomiale( ) | nombre de succès sur essais | ||
| Poisson( ) | nombre d’événements rares dans un intervalle (accès, requêtes) | ||
| Normale( ) | bruit de mesure, sommes de nombreux petits effets | ||
| Exponentielle( ) | temps d’attente entre deux événements | ||
| Zipf( ) | popularité : quelques éléments concentrent la majorité des accès | — | — |
La loi de Zipf est celle des caches et de Redis : . Avec , les 10 régions les plus populaires reçoivent environ les trois quarts des accès. C’est ce qui rend la mémoire hiérarchisée intéressante : la plupart des pages sont froides.
4. Covariance et corrélation
Intuition. Deux variables varient-elles ensemble ? Quand l’une est au-dessus de sa moyenne, l’autre l’est-elle aussi ?
La corrélation, c’est le cosinus de M1 appliqué aux variables centrées. La matrice de covariance de plusieurs variables est symétrique semi-définie positive : c’est elle que la PCA diagonalise (M3).
Attention : une corrélation nulle ne signifie pas l’indépendance. et (avec symétrique autour de 0) ont une corrélation nulle mais sont parfaitement dépendantes.
5. Loi des grands nombres et théorème central limite
Intuition. Quand on fait la moyenne de nombreux tirages indépendants, deux choses se produisent : la moyenne se rapproche de l’espérance (loi des grands nombres), et ses fluctuations autour de l’espérance prennent la forme d’une cloche gaussienne, quelle que soit la loi de départ (théorème central limite, TCL).
Pour tirages indépendants de même loi, d’espérance et d’écart-type :
et, pour assez grand, suit approximativement une loi .
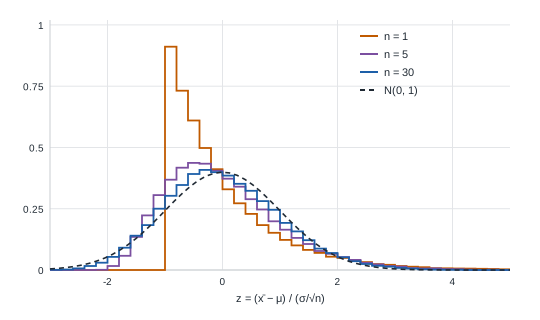
En pratique, c’est ce qui permet de dire « mon F1 vaut 0,82 plus ou moins 0,01 » : l’incertitude sur une moyenne diminue en , et on sait la quantifier (M9).
6. Pourquoi moyenner des modèles réduit l’erreur
Intuition. Si modèles se trompent de façon indépendante, leurs erreurs se compensent quand on fait la moyenne. Mais s’ils se trompent tous dans le même sens, la moyenne n’y change rien.
Pour prédictions de variance chacune, deux à deux corrélées avec un coefficient :
Le second terme disparaît quand grandit ; le premier reste. C’est toute l’idée des forêts aléatoires (partie 17) : on moyenne beaucoup d’arbres (grand ) en les rendant les plus différents possible (petit ).
C’est aussi l’outil de la décomposition biais/variance de la partie 13. En développant avec , en ajoutant et retranchant et en utilisant l’indépendance du bruit, les termes croisés ont une espérance nulle et il reste biais² + variance + .
7. L’autocorrélation : la ressemblance d’un signal avec lui-même décalé
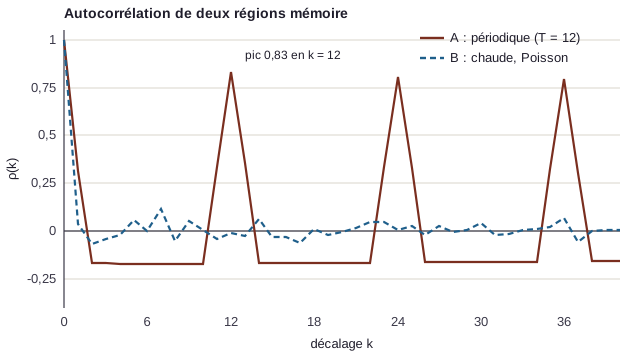
Intuition. Pour savoir si une région mémoire a un rythme, on compare sa série d’accès avec la même série décalée de pas. Si elle est périodique de période , la ressemblance est forte pour
C’est la corrélation entre la série et sa version décalée. C’est exactement l’outil qui manquait en M1 et M3 : la distance euclidienne et la PCA ne voyaient pas qu’une région décalée avait le même rythme ; l’autocorrélation, elle, ignore le décalage.
Exemple de code
Les lois usuelles : théorie contre simulation
import numpy as np

rng = np.random.default_rng(0)
N = 200_000

lois = {
    "Bernoulli(p=0.3)": (rng.binomial(1, 0.3, N), 0.3, 0.3 * 0.7),
    "Binomiale(n=20, p=0.3)": (rng.binomial(20, 0.3, N), 6.0, 20 * 0.3 * 0.7),
    "Poisson(λ=2)": (rng.poisson(2, N), 2.0, 2.0),
    "Normale(μ=1, σ=2)": (rng.normal(1, 2, N), 1.0, 4.0),
    "Exponentielle(λ=0.5)": (rng.exponential(2, N), 2.0, 4.0),
}
for nom, (ech, mu, var) in lois.items():
    print(f"{nom:<24} moyenne {ech.mean():6.3f} (théorie {mu:5.2f}) | variance {ech.var():6.3f} (théorie {var:5.2f})")

# Zipf : quelques régions concentrent la plupart des accès
regions = rng.zipf(1.5, N)
_, comptes = np.unique(regions, return_counts=True)
part_top10 = np.sort(comptes)[::-1][:10].sum() / N
print(f"Zipf(1.5) : les 10 régions les plus accédées reçoivent {part_top10:.0%} des accès")
Avec 200 000 tirages, chaque moyenne et chaque variance empiriques tombent à moins de 1 % de la théorie (par exemple 2,004 et 2,007 pour Poisson(2), dont espérance et variance valent 2). Pour Zipf(1,5), les 10 régions les plus accédées reçoivent 76 % des accès.
Grands nombres et TCL
import numpy as np

rng = np.random.default_rng(0)

# loi des grands nombres
x = rng.binomial(1, 0.3, 10_000)
moy = np.cumsum(x) / np.arange(1, len(x) + 1)
for k in (10, 100, 1000, 10_000):
    print(f"moyenne des {k:>6} premiers tirages : {moy[k - 1]:.4f}")

# théorème central limite sur une loi très asymétrique (exponentielle, moyenne 2, écart-type 2)
for n in (1, 5, 30, 200):
    moyennes = rng.exponential(2, (50_000, n)).mean(axis=1)
    z = (moyennes - 2) / (2 / np.sqrt(n))
    asym = np.mean(z**3)
    print(f"n={n:<4} écart-type des moyennes {moyennes.std():.3f} (théorie {2 / np.sqrt(n):.3f}) | asymétrie {asym:5.2f}")
La moyenne courante vaut 0,4000 après 10 tirages, 0,3700 après 100, 0,3220 après 1 000 et 0,3001 après 10 000 : elle converge vers .
| Écart-type des moyennes | Théorie | Asymétrie | |
|---|---|---|---|
| 1 | 2,012 | 2,000 | 2,06 |
| 5 | 0,902 | 0,894 | 0,96 |
| 30 | 0,366 | 0,365 | 0,36 |
| 200 | 0,141 | 0,141 | 0,12 |
L’écart-type suit de très près , et l’asymétrie (0 pour une gaussienne) fond à peu près comme (soit 0,89 ; 0,37 et 0,14 en théorie) : à , la distribution des moyennes est déjà presque symétrique, alors que la loi de départ ne l’est pas du tout.
Moyenner des modèles corrélés
import numpy as np

rng = np.random.default_rng(0)
sigma2, B = 1.0, 25
for rho in (0.0, 0.3, 0.7):
    cov = sigma2 * (rho * np.ones((B, B)) + (1 - rho) * np.eye(B))
    preds = rng.multivariate_normal(np.zeros(B), cov, 50_000)
    print(f"ρ={rho}: variance de la moyenne de {B} modèles = {preds.mean(axis=1).var():.3f} "
          f"(théorie {rho * sigma2 + (1 - rho) * sigma2 / B:.3f})")
| Corrélation | Variance de la moyenne de 25 modèles | Théorie |
|---|---|---|
| 0 | 0,040 | 0,040 |
| 0,3 | 0,327 | 0,328 |
| 0,7 | 0,703 | 0,712 |
Avec des modèles indépendants, moyenner 25 modèles divise la variance par 25. Avec une corrélation de 0,7, on ne gagne presque rien.
Détecter une période par autocorrélation
import numpy as np

rng = np.random.default_rng(0)


def autocorr(a, max_lag):
    a = a - a.mean()
    var = a @ a
    return np.array([1.0] + [(a[:-k] @ a[k:]) / var for k in range(1, max_lag + 1)])


T = 600
t = np.arange(T)
periodique = ((t % 12) < 2) * rng.poisson(6, T)          # actif 2 agrégations sur 12
chaude = rng.poisson(3, T).astype(float)
for nom, a in (("périodique", periodique), ("chaude", chaude)):
    ac = autocorr(a.astype(float), 40)
    k_max = 1 + np.argmax(ac[1:])
    print(f"{nom:<10} : pic d'autocorrélation au décalage {k_max:>2} (valeur {ac[k_max]:.2f})")
La région périodique a un pic à de valeur 0,83 (puis 0,80 à et 0,79 à ) : on retrouve sa période sans la connaître. La région chaude n’a aucun pic notable : son maximum, 0,12 au décalage 7, est isolé et ne se répète pas aux multiples de 7 (0,07 à , 0,02 à ) ; c’est du bruit. Le décalage du premier pic d’autocorrélation est une feature invariante au décalage : exactement ce qu’il fallait pour les profils de M1 et M3.
Exercice pratique
- À la main. Calcule l’espérance et la variance d’un dé à 6 faces. Vérifie par simulation avec 100 000 lancers.
- Variance d’une somme. Montre que . Que devient la formule si ? Vérifie numériquement.
- Corrélation nulle mais dépendance. Tire et pose . Calcule leur corrélation empirique. Qu’en conclus-tu ?
- Combien d’exemples ? Une région est accédée avec une probabilité inconnue par agrégation. Combien d’agrégations faut-il observer pour que l’écart-type de l’estimation soit inférieur à 0,01 ?
- Fil rouge. Ajoute aux features de la partie 14 la valeur du pic d’autocorrélation et son décalage, calculés sur une fenêtre glissante de 100 agrégations. Ces deux features séparent-elles mieux les régions périodiques des rafales que
periode_estimee?
Indice pour la question 4 : .
Ressources pour aller plus loin
- Blitzstein et Hwang, Introduction to Probability et le cours Stat 110 de Harvard, gratuits en ligne : la meilleure introduction aux probabilités.
- Deisenroth et al., Mathematics for Machine Learning, chapitre 6 (probabilités et lois).
- Seeing Theory (Brown University) : visualisations interactives de l’espérance, de la variance et du TCL.
- Breslau et al., Web Caching and Zipf-like Distributions (INFOCOM 1999) : Zipf appliqué aux caches.
Ce que tu dois savoir faire avant de passer à la suite
- Calculer espérance et variance pour une loi discrète simple
- Associer chaque loi usuelle à un phénomène (labels, comptages, temps d’attente, popularité)
- Expliquer la différence entre corrélation nulle et indépendance
- Énoncer la loi des grands nombres et le TCL, et expliquer le
- Expliquer avec la formule pourquoi on moyenne des modèles décorrélés
- Calculer une autocorrélation et en déduire une période
Partie suivante : M8 · Vraisemblance, Bayes et entropie. D’où viennent la MSE et la cross-entropie : les fonctions de perte vues comme des probabilités.