Le cadre du ML supervisé, revu à froid
Données, modèle, perte et généralisation : on reconstruit le cadre mental du ML supervisé avant d'aller plus loin.
Mastering AI · Phase technique · Semaine 1 · Partie 13
Objectif de l’étape
Avant d’empiler les modèles (gradient boosting, LSTM, MLOps…), on remet en place le cadre commun à tout le ML supervisé. Presque chaque problème rencontré plus tard (fuite de données, sur-apprentissage, mauvais choix de métrique) vient d’un cadre mal posé.
À la fin de cet article, tu sauras formuler n’importe quel problème supervisé en quatre éléments, données, modèle, perte, optimisation, et diagnostiquer si un modèle apprend trop ou pas assez.
Notions clés
1. Les données : des exemples
Intuition. On montre au modèle des situations ( ) et la bonne réponse ( ), puis on espère qu’il devine la réponse pour des situations nouvelles.
- : le vecteur de features, ce qu’on observe. Pour une région mémoire, ce serait par exemple « nombre d’accès sur les 10 dernières agrégations, temps depuis le dernier accès, taille ».
- : le label, ce qu’on veut prédire. Pour notre exemple : « la région est-elle accédée dans les prochaines ms ? ».
Le jeu de données est une collection . Deux grandes familles de problèmes :
| Problème | Exemple | |
|---|---|---|
| Régression | réel | temps avant le prochain accès |
| Classification | catégorie | chaud / froid |
Hypothèse cachée, mais capitale : les exemples d’entraînement et ceux qu’on rencontrera plus tard viennent de la même distribution. C’est elle qui rend la généralisation possible, et c’est elle qui casse quand le workload change (on y reviendra aux parties 18 et 28).
2. Le modèle : une fonction paramétrée
Intuition. Un modèle est une famille de fonctions dont on règle les boutons . Entraîner revient à choisir la position des boutons.
- Régression linéaire : , les boutons sont les poids.
- Arbre de décision : les boutons sont les seuils et les découpages.
- Réseau de neurones : des millions de poids.
Choisir un modèle, c’est choisir l’ensemble des fonctions possibles (sa capacité). Trop petit, il ne peut pas représenter la réalité. Trop grand, il peut représenter le bruit aussi.
3. La perte : mesurer l’erreur
Intuition. Il faut un chiffre qui dit « à quel point ce modèle se trompe ». Plus il est petit, mieux c’est.
Pour un exemple, la fonction de perte compare la prédiction à la vérité :
- erreur quadratique (régression) :
- log-loss (classification) : , avec la probabilité prédite
Sur tout le jeu d’entraînement, on fait la moyenne, appelée risque empirique :
D’où viennent ces pertes ? Elles ne sont pas arbitraires : elles découlent du maximum de vraisemblance → Required Maths M8 : vraisemblance, Bayes et entropie.
4. Entraîner = optimiser
Intuition. On cherche la position des boutons qui rend l’erreur moyenne la plus petite possible.
Pour un modèle linéaire, il existe une solution exacte (les équations normales de M2). Pour un réseau de neurones, on descend la pente de petit à petit → Required Maths M10 : descente de gradient.
5. Le vrai objectif : la généralisation
Intuition. Réussir l’examen avec les questions qu’on a déjà vues ne prouve rien. Ce qui compte, c’est la note sur des questions nouvelles.
Ce qu’on veut vraiment minimiser, c’est le risque réel : l’erreur moyenne sur toutes les données possibles, pas seulement celles qu’on a vues. Comme on ne peut pas le calculer, on l’estime sur un ensemble de test que le modèle n’a jamais vu.
Trois situations typiques :
| Erreur train | Erreur test | Diagnostic | |
|---|---|---|---|
| Sous-apprentissage | haute | haute | modèle trop simple |
| Bon modèle | basse | basse, proche du train | ✅ |
| Sur-apprentissage | très basse | haute | modèle qui apprend le bruit |
6. Le compromis biais / variance
Intuition. Imagine qu’on entraîne le même type de modèle sur 200 jeux de données différents tirés de la même source.
- Biais : en moyenne, le modèle tombe-t-il à côté de la vérité ? (modèle trop rigide)
- Variance : ses prédictions changent-elles beaucoup d’un jeu de données à l’autre ? (modèle trop sensible)
Pour la perte quadratique, l’erreur attendue se décompose exactement ainsi :
Augmenter la capacité du modèle fait baisser le biais et monter la variance. Le meilleur modèle se trouve entre les deux. La démonstration repose sur les outils de probabilités → Required Maths M7 : variables aléatoires, espérance et variance.
Exemple de code
On fait varier la capacité d’un modèle : des polynômes de degré 1 à 15, ajustés sur une sinusoïde bruitée. Tout tient en un script.
Erreurs train / test selon la complexité
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

rng = np.random.default_rng(42)

def f_vraie(x):
    """La 'réalité' que le modèle ne connaît pas."""
    return np.sin(2 * np.pi * x)

# 1. Données : n points bruités (peu de points, pour bien voir le sur-apprentissage)
n, bruit = 30, 0.25
x = rng.uniform(0, 1, n)
y = f_vraie(x) + rng.normal(0, bruit, n)
X = x.reshape(-1, 1)

# Ici les points sont indépendants : un split aléatoire est légitime.
# (Sur des traces temporelles, ce sera interdit -> partie 14.)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.4, random_state=0
)

def polynome(degre):
    return make_pipeline(
        PolynomialFeatures(degre, include_bias=False),
        StandardScaler(),
        LinearRegression(),
    )

# 2. Modèle + perte + optimisation, pour chaque degré
degres = list(range(1, 16))
err_train, err_test = [], []
for d in degres:
    m = polynome(d).fit(X_train, y_train)
    err_train.append(mean_squared_error(y_train, m.predict(X_train)))
    err_test.append(mean_squared_error(y_test, m.predict(X_test)))

meilleur = degres[int(np.argmin(err_test))]
print(f"Meilleur degré sur le test : {meilleur}")
print(f"Bruit irréductible (sigma^2) : {bruit**2:.4f}")

# 3. Visualisation
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))

axes[0].plot(degres, err_train, "o-", label="erreur train")
axes[0].plot(degres, err_test, "o-", label="erreur test")
axes[0].axhline(bruit**2, ls="--", c="gray", label="bruit $\\sigma^2$")
axes[0].set_yscale("log")
axes[0].set_xlabel("degré du polynôme (capacité)")
axes[0].set_ylabel("MSE")
axes[0].set_title("Sous- et sur-apprentissage")
axes[0].legend()

grille = np.linspace(0, 1, 300).reshape(-1, 1)
axes[1].scatter(X_train, y_train, s=15, label="train")
axes[1].scatter(X_test, y_test, s=15, marker="x", label="test")
axes[1].plot(grille, f_vraie(grille), "k--", label="vraie fonction")
for d in (1, meilleur, 15):
    axes[1].plot(grille, polynome(d).fit(X_train, y_train).predict(grille),
                 label=f"degré {d}")
axes[1].set_ylim(-2, 2)
axes[1].set_title("Trois niveaux de capacité")
axes[1].legend(fontsize=8)

plt.tight_layout()
plt.show()
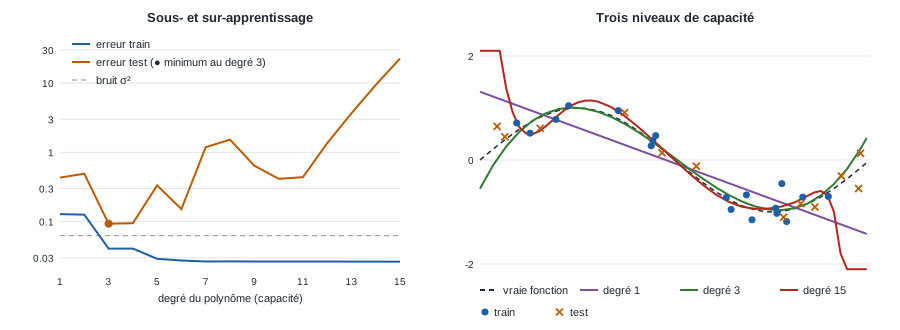
Ce que tu dois observer :
- l’erreur train baisse quand le degré augmente, puis se stabilise autour de 0,026, sous le bruit : le modèle colle aux points mieux que la vraie fonction elle-même, autrement dit il apprend le bruit ;
- l’erreur test dessine un U : minimale au degré 3 (autour de 0,09), elle remonte ensuite jusqu’à plus de 20 au degré 15 (d’où l’échelle logarithmique) ;
- le degré 1 rate la forme (biais), le degré 15 ondule entre les points et part dans tous les sens aux extrémités (variance) ;
- même au mieux, l’erreur test ne descend pas sous : c’est le bruit irréductible.
Mesurer biais et variance directement
On applique littéralement la définition : on ré-entraîne chaque modèle sur 200 jeux de données différents.
import numpy as np
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)

def f_vraie(x):
    return np.sin(2 * np.pi * x)

def polynome(degre):
    return make_pipeline(
        PolynomialFeatures(degre, include_bias=False),
        StandardScaler(),
        LinearRegression(),
    )

x_eval = np.linspace(0.05, 0.95, 50).reshape(-1, 1)

def biais_variance(degre, n_jeux=200, n=30, bruit=0.25):
    preds = np.empty((n_jeux, len(x_eval)))
    for k in range(n_jeux):
        xs = rng.uniform(0, 1, n)
        ys = f_vraie(xs) + rng.normal(0, bruit, n)
        preds[k] = polynome(degre).fit(xs.reshape(-1, 1), ys).predict(x_eval)
    pred_moyenne = preds.mean(axis=0)
    biais2 = np.mean((pred_moyenne - f_vraie(x_eval.ravel())) ** 2)
    variance = np.mean(preds.var(axis=0))
    return biais2, variance

print(f"{'degré':>5} | {'biais²':>8} | {'variance':>8} | {'somme':>8}")
for d in (1, 3, 5, 9, 12):
    b2, v = biais_variance(d)
    print(f"{d:>5} | {b2:8.4f} | {v:8.4f} | {b2 + v:8.4f}")
| Degré | Biais² | Variance |
|---|---|---|
| 1 | 0,157 | 0,019 |
| 3 | 0,003 | 0,009 |
| 5 | 0,0002 | 0,017 |
| 9 | 0,003 | 0,39 |
| 12 | 0,020 | 4,77 |
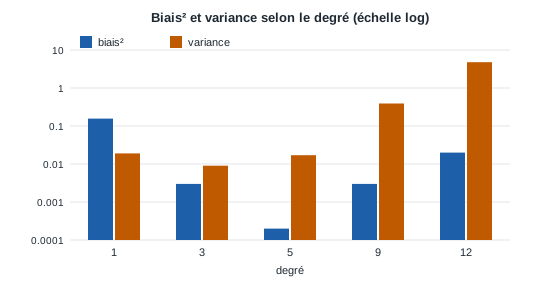
Le biais² s’effondre dès le degré 3, puis la variance explose au-delà du degré 5. Leur somme est minimale autour du degré 3 : c’est la formule de la section 6, vérifiée en chiffres.
Fil rouge : le mémoire dans ce cadre
Le sujet de mémoire se pose exactement dans ce cadre :
| Élément | Prédiction chaud/froid |
|---|---|
| Exemple | une région mémoire DAMON à l’instant |
| features calculées sur l’historique de la région (récence, fréquence, périodicité, voisinage…) | |
| si la région est accédée dans les ms suivantes, sinon | |
| Modèle | régression logistique → LightGBM → LSTM |
| Perte | log-loss, avec un coût asymétrique : un faux froid (région compressée puis relue) coûte plus cher qu’un faux chaud |
| Généralisation | sur la suite de la trace (futur) et sur un autre workload |
Deux différences importantes avec l’exemple jouet :
- les exemples ne sont pas indépendants : deux instants consécutifs d’une même région se ressemblent. Le split aléatoire devient une fuite (partie 14) ;
- la bonne métrique n’est pas la MSE ni l’accuracy, mais un compromis précision/rappel qui tient compte du coût des faux froids (partie 15).
Exercice pratique
- Plus de données. Relance le premier script avec
n = 200, puisn = 1000. Le meilleur degré change-t-il ? L’écart train/test au degré 15 se réduit-il ? Explique pourquoi avec le compromis biais/variance. - Plus de bruit. Remets
n = 30et passebruità0.6. Que devient le meilleur degré ? Pourquoi un modèle plus simple devient-il préférable ? - Régularisation, en avant-première. Remplace
LinearRegression()parRidge(alpha=1e-3)(import depuissklearn.linear_model) et garde le degré 15. Compare l’erreur test. Qu’a fait la régularisation à la variance ? (Réponse complète en partie 16.) - Fil rouge. Sans écrire de code, rédige en 5 à 10 lignes la formulation de ton problème chaud/froid : unité d’exemple, liste de features candidates, label exact, horizon , ce qu’on entend par « généraliser ». Garde ce texte : on le réutilisera en partie 14.
Indice pour la question 1 : avec plus de données, la variance de chaque modèle diminue, donc on peut se permettre plus de capacité.
Ressources pour aller plus loin
- An Introduction to Statistical Learning (James, Witten, Hastie, Tibshirani), chapitre 2, gratuit en ligne : la meilleure présentation du compromis biais/variance.
- The Elements of Statistical Learning, chapitre 7 : la version plus mathématique de la sélection de modèles.
- Documentation scikit-learn, exemple Underfitting vs. Overfitting.
- Rappel sur le blog : scikit-learn : le cycle complet d’un modèle.
Ce que tu dois savoir faire avant de passer à la suite
- Formuler un problème supervisé en quatre éléments : données, modèle, perte, optimisation
- Expliquer la différence entre risque empirique et risque réel, et pourquoi on a besoin d’un ensemble de test
- Reconnaître le sous-apprentissage et le sur-apprentissage sur des courbes train/test
- Expliquer le compromis biais/variance avec tes propres mots, sans formule
- Avoir rédigé la formulation supervisée de ton problème chaud/froid
Partie suivante : Préparer les données sans fuite, où l’on génère les premières traces mémoire simulées et où l’on découvre pourquoi le split aléatoire de cet article serait une erreur sur ces données.