Apprentissage non supervisé : explorer sans labels
Profils d'accès, PCA, k-means, DBSCAN et les pièges de t-SNE : retrouver sans labels les familles de régions mémoire, et repérer un comportement jamais vu avant que le modèle ne se trompe.
Mastering AI · Phase technique · Semaine 2 · Partie 20
Objectif de l’étape
Dans la partie 19, on a trouvé pourquoi le modèle rate le workload analytique : les régions en balayage, un comportement qu’il n’avait jamais vu. Mais on a triché : on connaissait la vraie nature de chaque région, parce qu’on l’avait simulée. Sur les vraies traces DAMON, personne ne te donnera cette colonne.
La question de cet article : peut-on retrouver ces familles de comportements à partir des seules traces, sans aucun label ? Et, mieux : peut-on voir arriver un comportement nouveau avant que le modèle supervisé ne se trompe ?
À la fin de cet article, tu sauras :
- résumer une région par un profil d’accès et choisir une distance qui a un sens ;
- appliquer et interpréter une PCA (variance expliquée, chargements) ;
- faire tourner k-means, choisir sans labels (coude, silhouette), et évaluer un clustering quand on a, exceptionnellement, la vérité ;
- connaître l’apport du clustering hiérarchique et de DBSCAN ;
- lire un graphique t-SNE sans lui faire dire ce qu’il ne dit pas ;
- utiliser tout ça pour détecter un comportement absent des données d’entraînement.
Notions clés
1. Sans labels, tout repose sur la distance
Intuition. Un clustering regroupe ce qui se ressemble. « Se ressembler » veut dire « être proche », donc tout dépend de la règle qui mesure la proximité. Change la règle, tu changes les groupes.
On travaillera avec la distance euclidienne de Required Maths M1, . Elle a un défaut : elle additionne les écarts de toutes les colonnes, donc une colonne exprimée sur une grande échelle écrase les autres. D’où la standardisation avant tout clustering :
Chaque colonne a alors une moyenne nulle et un écart-type de 1 : elles pèsent pareil dans la distance. Ce n’est pas neutre pour autant : c’est un choix (« toutes les colonnes comptent autant »), et le choix des colonnes elles-mêmes compte encore plus. L’exemple de code mesure ce que coûte l’oubli de la standardisation.
Deuxième décision : quoi regrouper. Les lignes du dataset des parties 14 à 19 (une région à un instant) sont trop locales : à un instant donné, une région périodique entre deux activations ressemble à une région froide. On regroupe donc des fenêtres : une région sur 700 agrégations, résumée en quelques nombres (son profil).
2. La PCA : regarder les données sous le bon angle
Intuition. Six colonnes, c’est six dimensions : impossible à dessiner. La PCA cherche le plan sur lequel l’ombre du nuage de points est la plus étalée, donc celui qui perd le moins d’information.
Tu as vu la mécanique en Required Maths M3 : les axes principaux sont les vecteurs propres de la matrice de covariance des données standardisées, et la part de variance portée par l’axe est
Deux lectures :
- la variance expliquée dit combien d’axes suffisent (si PC1 + PC2 portent 90 %, le dessin en 2D est fidèle) ;
- les chargements (les coordonnées des vecteurs propres) disent ce que mesure chaque axe. Un axe où toutes les colonnes d’intensité ont un fort chargement positif est un axe « activité ».
Attention : le signe d’un axe est arbitraire (un vecteur propre et son opposé conviennent tous les deux), et la PCA ne voit que les relations linéaires.
3. k-means : centres, et chacun va au plus proche
Intuition. On place centres au hasard. Chaque point rejoint le centre le plus proche ; chaque centre se déplace au milieu de ses points ; on recommence jusqu’à ce que plus rien ne bouge.
C’est une descente sur l’inertie, la somme des carrés des distances de chaque point à son centre :
Le problème n’est pas convexe (M6) : le résultat dépend de l’initialisation, d’où n_init=10 (dix départs, on garde le meilleur). Et k-means suppose des groupes ronds et de tailles comparables : il préfère couper en deux un grand groupe étalé plutôt qu’isoler un petit groupe compact.
Choisir sans labels. L’inertie baisse toujours quand augmente : on cherche un coude, souvent flou. La silhouette est plus tranchée. Pour un point , avec sa distance moyenne aux points de son cluster et sa distance moyenne aux points du cluster voisin le plus proche :
proche de 1 : le point est bien chez lui. Proche de 0 : il est à la frontière. Négatif : il serait mieux ailleurs. On prend le qui maximise la silhouette moyenne.
Évaluer quand on a la vérité. Ici, exceptionnellement, on connaît les natures (simulées). L’ARI (adjusted Rand index) mesure l’accord entre deux partitions, sans se soucier des numéros de clusters : 1 = identiques, 0 = pas mieux que le hasard. On ne s’en sert que pour contrôler, jamais pour choisir : sur les vraies traces, il n’existera pas.
4. Deux autres familles : hiérarchique et par densité
- Clustering hiérarchique (Ward). On part d’un cluster par point et on fusionne, à chaque étape, les deux clusters dont l’union augmente le moins l’inertie. On obtient un arbre de fusions (dendrogramme) qu’on coupe au niveau voulu. Avantage : pas d’initialisation aléatoire, et toutes les valeurs de d’un coup.
- DBSCAN. Un cluster est une zone dense : un point est « cœur » s’il a au moins
min_samplesvoisins à moins deeps, et les cœurs voisins s’enchaînent. Les points isolés sont étiquetés bruit ( ). Avantages : pas de à choisir, des formes quelconques. Contrepartie :epsà régler. Une heuristique : tracer la distance de chaque point à sonmin_samples-ième voisin, et prendreepsvers le coude de cette courbe.
5. t-SNE et UMAP : faits pour regarder, pas pour mesurer
Intuition. t-SNE place les points en 2D de façon à ce que les voisins proches restent voisins. Il y arrive très bien, au prix de tout le reste.
Ce que t-SNE (et UMAP, sur le même principe) ne conserve pas :
- la taille des groupes : t-SNE dilate les zones denses et contracte les zones diffuses ;
- la distance entre groupes : deux groupes éloignés sur le dessin ne le sont pas forcément dans les données ;
- l’absence de structure : sur du bruit pur, il dessine volontiers des grumeaux.
Le résultat dépend aussi de la perplexité (en gros, le nombre de voisins pris en compte) et de la graine. La règle : t-SNE sert à faire des hypothèses à vérifier ensuite dans l’espace d’origine, jamais à les prouver. Ne fais jamais de clustering sur des coordonnées t-SNE.
Exemple de code
Comme en parties 15 à 19, on reprend tel quel le script de la partie 14, puis on ajoute les quatre blocs ci-dessous. Les deux workloads sont ceux des parties 18 et 19 : jvm (70 % de régions périodiques) et analytique (qui contient les balayages). L’ensemble tourne en une dizaine de secondes (numpy 2.5, pandas 3.0, scikit-learn 1.9, scipy 1.18).
Des profils d’accès, puis une PCA
Chaque région est découpée en quatre fenêtres de 700 agrégations, alignées sur le changement de régime ( ) pour qu’une fenêtre ne mélange jamais deux natures. Chaque fenêtre est résumée en six nombres, calculés sans aucun label :
| Colonne | Ce qu’elle mesure |
|---|---|
log_intensite |
nombre moyen d’accès par agrégation (en log) |
frac_active |
part des agrégations avec au moins un accès |
log_duree_rafale |
durée moyenne d’une période d’activité (en log) |
log_ecart |
écart moyen entre deux débuts d’activité (en log) |
irregularite |
écart-type / moyenne de ces écarts : 0 = métronome |
pic_acf |
plus haut pic d’autocorrélation entre les décalages 5 et 299 : 1 = parfaitement périodique |
L’autocorrélation est la corrélation de la série avec elle-même décalée (M7) : c’est la version rigoureuse de la « périodicité » annoncée en partie 14. Les logarithmes servent à ramener des grandeurs très asymétriques (de 0,01 à 4 accès par agrégation) sur une échelle où les distances ont un sens.
# Suite du script de la partie 14 : T, N_REGIONS, TAILLE_BLOC, T_CHANGEMENT, TYPES,
# simuler_segment, np et pd sont déjà définis.
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA


def simuler_workload(graine, types, p, cycle_balayage=240):
    """Le simuler_workload de la partie 19 : mêmes traces, et la vraie nature des régions."""
    r = np.random.default_rng(graine)
    acces = np.zeros((N_REGIONS, T), dtype=int)
    nature = np.empty((N_REGIONS, 2), dtype=object)
    temps = np.arange(T)
    for bloc in range(N_REGIONS // TAILLE_BLOC):
        avant = r.choice(types, p=p)
        apres = r.choice(types, p=p) if r.random() < 0.4 else avant
        for reg in range(bloc * TAILLE_BLOC, (bloc + 1) * TAILLE_BLOC):
            nature[reg] = avant, apres
            for debut, fin, type_ in [(0, T_CHANGEMENT, avant), (T_CHANGEMENT, T, apres)]:
                if type_ == "balayage":
                    actif = (temps[debut:fin] - 2 * reg) % cycle_balayage < 2
                    acces[reg, debut:fin] = actif * r.poisson(6, fin - debut)
                else:
                    acces[reg, debut:fin] = simuler_segment(type_, fin - debut, r)
    return acces, nature


def profil(a):
    """Résumé d'une fenêtre d'accès en 6 nombres, sans aucun label."""
    actif = (a > 0).astype(int)
    debuts = np.flatnonzero(np.diff(np.r_[0, actif]) == 1)        # débuts d'activité
    fins = np.flatnonzero(np.diff(np.r_[actif, 0]) == -1)         # fins d'activité
    ecarts = np.diff(debuts)
    x = actif - actif.mean()
    acf = np.array([x[:-k] @ x[k:] for k in range(5, 300)]) / max(x @ x, 1e-9)
    return {
        "log_intensite": np.log1p(a.mean()),                         # accès moyens par agrégation
        "frac_active": actif.mean(),                                 # part du temps actif
        "log_duree_rafale": np.log1p((fins - debuts + 1).mean()) if len(debuts) else 0.0,
        "log_ecart": np.log1p(ecarts.mean()) if len(ecarts) else np.log1p(len(a)),
        "irregularite": ecarts.std() / ecarts.mean() if len(ecarts) > 1 else 1.0,
        "pic_acf": acf.max(),                                        # 1 = parfaitement périodique
    }


# Fenêtres de 700 agrégations, alignées sur le changement de régime (t = 2100)
FENETRES = [(0, 700), (700, 1400), (1400, 2100), (2100, 2800)]
lignes = []
for nom, (acc, nat) in {"jvm": simuler_workload(11, TYPES, [0.7, 0.1, 0.1, 0.1]),
                        "analytique": simuler_workload(12, TYPES + ["balayage"],
                                                       [0.1, 0.15, 0.25, 0.1, 0.4])}.items():
    for reg in range(N_REGIONS):
        for debut, fin in FENETRES:
            lignes.append({**profil(acc[reg, debut:fin]), "workload": nom, "region": reg,
                           "debut": debut, "nature": nat[reg, int(debut >= T_CHANGEMENT)]})
profils = pd.DataFrame(lignes)
COLS = ["log_intensite", "frac_active", "log_duree_rafale", "log_ecart", "irregularite", "pic_acf"]
pd.set_option("display.width", 120)
pd.set_option("display.max_columns", 20)
print(profils.shape, {str(k): int(v) for k, v in profils.nature.value_counts().items()})
print(profils.groupby("nature")[COLS].median().round(2))

# PCA sur les profils standardisés
Z = StandardScaler().fit_transform(profils[COLS])
pca = PCA().fit(Z)
print("variance expliquée :", pca.explained_variance_ratio_.round(3),
      "| cumulée PC1+PC2 :", pca.explained_variance_ratio_[:2].sum().round(3))
print(pd.DataFrame(pca.components_[:2].T, index=COLS, columns=["PC1", "PC2"]).round(2))
Sortie : 768 fenêtres (2 workloads × 96 régions × 4 fenêtres) : 304 périodiques, 208 chaudes, 136 balayages, 100 froides et 20 rafales. Les médianes par nature, que le clustering ne verra pas :
| Nature | log_intensite |
frac_active |
log_duree_rafale |
log_ecart |
irregularite |
pic_acf |
|---|---|---|---|---|---|---|
| balayage | 0,05 | 0,01 | 1,10 | 5,48 | 0,00 | 0,67 |
| chaude | 1,30 | 0,93 | 2,67 | 2,72 | 0,83 | 0,11 |
| froide | 0,01 | 0,01 | 0,69 | 4,47 | 0,71 | 0,16 |
| périodique | 0,38 | 0,07 | 1,39 | 3,69 | 0,00 | 0,94 |
| rafale | 0,47 | 0,12 | 2,04 | 3,94 | 0,83 | 0,39 |
Les signatures sont nettes : la chaude est active 93 % du temps ; la périodique et le balayage sont des métronomes (irrégularité nulle), mais le balayage revient bien plus rarement (écart de agrégations contre ) ; la froide et la rafale sont irrégulières, la rafale étant bien plus intense.
PCA. Les deux premiers axes portent 69,8 % et 18,6 % de la variance, soit 88,4 % : le dessin en 2D sera fidèle. Les chargements :
| Colonne | PC1 | PC2 |
|---|---|---|
log_intensite |
0,46 | 0,31 |
frac_active |
0,48 | 0,08 |
log_duree_rafale |
0,42 | 0,22 |
log_ecart |
−0,33 | −0,45 |
irregularite |
0,39 | −0,51 |
pic_acf |
−0,36 | 0,62 |
- PC1 est un axe « activité » : intensité, part active et durée des rafales poussent dans le même sens, l’écart entre activations dans l’autre. Les chaudes sont tout à droite.
- PC2 est un axe « régularité » : autocorrélation forte en haut, irrégularité en bas. Les périodiques sont en haut, les froides en bas.
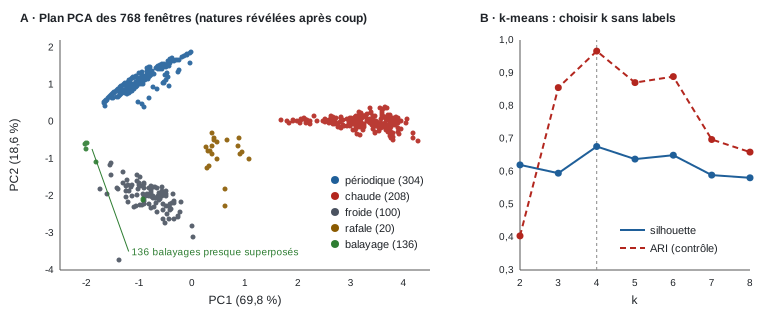
Sur le panneau A, les couleurs sont ajoutées après coup : la PCA ne les a pas vues. Cinq groupes séparés apparaissent quand même. Les 136 balayages tiennent presque en un point : la même mécanique (2 agrégations actives toutes les 240) donne presque le même profil d’une région à l’autre.
k-means, Ward, DBSCAN
from sklearn.cluster import KMeans, AgglomerativeClustering, DBSCAN
from sklearn.neighbors import NearestNeighbors
from sklearn.metrics import silhouette_score, adjusted_rand_score

# Choisir k sans labels : inertie (coude) et silhouette. L'ARI utilise les natures cachées : contrôle seulement.
for k in range(2, 9):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(Z)
    print(f"k = {k} | inertie {km.inertia_:7.1f} | silhouette {silhouette_score(Z, km.labels_):.3f}"
          f" | ARI {adjusted_rand_score(profils.nature, km.labels_):.3f}")

for k in (4, 6):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(Z)
    print(f"\nk-means, k = {k}\n", pd.crosstab(km.labels_, profils.nature))

# La même chose sans standardiser : les distances sont dominées par les colonnes à grande échelle
brut = KMeans(n_clusters=4, n_init=10, random_state=0).fit(profils[COLS])
print("\nécarts-types bruts :", profils[COLS].std().round(2).to_dict())
print("k-means k = 4 sans standardiser : ARI", round(adjusted_rand_score(profils.nature, brut.labels_), 3))
print(pd.crosstab(brut.labels_, profils.nature))

# Deux autres familles : hiérarchique (Ward) et par densité (DBSCAN)
ward = AgglomerativeClustering(n_clusters=4, linkage="ward").fit(Z)
print("\nWard, 4 clusters : ARI", round(adjusted_rand_score(profils.nature, ward.labels_), 3))
d10 = NearestNeighbors(n_neighbors=10).fit(Z).kneighbors(Z)[0][:, -1]   # distance au 10e voisin
print("distance au 10e voisin, quantiles 50/90/99 % :", np.quantile(d10, [0.5, 0.9, 0.99]).round(2))
for eps in (0.5, 0.8):
    db = DBSCAN(eps=eps, min_samples=10).fit(Z)
    print(f"\nDBSCAN eps = {eps} : ARI {adjusted_rand_score(profils.nature, db.labels_):.3f} (-1 = bruit)\n",
          pd.crosstab(db.labels_, profils.nature))
Choisir .
| Inertie | Silhouette | ARI (contrôle) | |
|---|---|---|---|
| 2 | 1 674,4 | 0,620 | 0,404 |
| 3 | 964,7 | 0,595 | 0,855 |
| 4 | 598,2 | 0,676 | 0,966 |
| 5 | 382,9 | 0,638 | 0,870 |
| 6 | 312,1 | 0,649 | 0,889 |
| 7 | 250,8 | 0,589 | 0,697 |
| 8 | 194,9 | 0,581 | 0,659 |
L’inertie baisse sans coude franc ; la silhouette, elle, désigne , et c’est bien là que l’ARI (calculé avec les natures cachées) est le meilleur : 0,966. Le critère sans labels a trouvé le bon réglage. Mais il y a cinq natures, pas quatre. Les clusters :
| Cluster ( ) | balayage | chaude | froide | périodique | rafale |
|---|---|---|---|---|---|
| 0 | 0 | 208 | 0 | 0 | 0 |
| 1 | 132 | 0 | 5 | 0 | 0 |
| 2 | 0 | 0 | 0 | 304 | 0 |
| 3 | 4 | 0 | 95 | 0 | 20 |
- Les 20 rafales sont avalées par les froides. Elles ne pèsent que 20 fenêtres sur 768 : les séparer ne réduit presque pas l’inertie.
- Avec , k-means ne les isole toujours pas : il coupe les chaudes en deux (106 + 102), parce qu’un grand groupe étalé coûte plus cher en inertie qu’un petit groupe à part. Il faut pour voir apparaître un cluster de 20 rafales pures. C’est le biais « groupes ronds de tailles comparables » de la section 3, chiffres à l’appui.
- Les 4 balayages classés froids sont les régions 88 à 91 sur une fenêtre où elles ne sont activées que deux fois : un seul écart entre deux débuts, donc une irrégularité impossible à mesurer (le code met alors 1,0). Une fenêtre trop courte par rapport au cycle rend un comportement indiscernable : l’exercice 1 pousse l’effet à fond.
Sans standardiser, l’ARI à
tombe à 0,746 : balayages et froides fusionnent (136 + 98), les chaudes sont coupées en deux (108 + 100), et les rafales rejoignent les périodiques. Les écarts-types bruts vont de 0,37 (pic_acf) à 1,04 (log_ecart) : la distance brute est surtout faite d’intensité et d’écart entre activations, deux colonnes où balayages et froides se ressemblent (peu d’accès, longs silences). Ce qui les distingue, la régularité, pèse trop peu.
Ward (4 clusters) fait à peine mieux que k-means : ARI 0,975, avec la même confusion des rafales.
DBSCAN. La distance au 10e voisin vaut 0,17 en médiane, 0,47 au quantile 90 % et 1,11 au quantile 99 % : on essaie eps = 0,5 (vers le coude) et 0,8.
eps = 0,5 |
eps = 0,8 |
|
|---|---|---|
| Clusters | 4 | 5 |
| Points de bruit | 38, dont les 20 rafales | 5 |
| Rafales | toutes en bruit | 18 dans leur propre cluster |
| ARI | 0,972 | 0,988 |
Avec eps = 0,5, DBSCAN dit quelque chose d’intéressant : les rafales ne forment pas une zone assez dense, ce sont des anomalies. Avec eps = 0,8, il retrouve les cinq natures, sans qu’on lui ait donné de
. Les deux lectures sont vraies ; c’est toi qui décides si 20 fenêtres font une famille ou une exception.
Les pièges de t-SNE, mesurés
from sklearn.manifold import TSNE
from scipy.spatial.distance import pdist


def etalement(E, nature):
    """Distance moyenne entre deux points d'une même nature."""
    return pdist(E[(profils.nature == nature).values]).mean()


# Les tailles relatives des groupes survivent-elles à t-SNE ?
for nom, E in [("profils standardisés", Z)] + [
        (f"t-SNE perplexité {p}", TSNE(perplexity=p, random_state=0).fit_transform(Z)) for p in (5, 30, 100)]:
    e = {n: etalement(E, n) for n in ("chaude", "periodique", "balayage")}
    print(f"{nom:>22} | chaude {e['chaude']:6.2f} | periodique {e['periodique']:6.2f} | "
          f"balayage {e['balayage']:6.2f} | chaude / periodique {e['chaude'] / e['periodique']:.2f}")

# Et sur du bruit pur, sans aucune structure ?
bruit = np.random.default_rng(0).normal(size=Z.shape)
E = TSNE(perplexity=30, random_state=0).fit_transform(bruit)
for nom, X in [("bruit brut", bruit), ("t-SNE du bruit", E)]:
    print(f"{nom:>15} | silhouette k-means k = 4 : "
          f"{silhouette_score(X, KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(X)):.3f}")
Distance moyenne entre deux fenêtres de même nature :
| Représentation | chaude | périodique | balayage | chaude / périodique |
|---|---|---|---|---|
| Profils standardisés (la vérité) | 1,53 | 0,75 | 0,18 | 2,05 |
| t-SNE, perplexité 5 | 38,02 | 54,60 | 63,33 | 0,70 |
| t-SNE, perplexité 30 | 13,52 | 18,50 | 12,01 | 0,73 |
| t-SNE, perplexité 100 | 3,49 | 4,38 | 2,44 | 0,80 |
- t-SNE inverse les tailles. Dans les données, les chaudes sont deux fois plus étalées que les périodiques ; sur tous les dessins t-SNE, elles paraissent plus compactes.
- Le groupe le plus serré peut devenir le plus large. Les balayages tiennent presque en un point (0,18), mais avec une perplexité de 5, t-SNE en fait le groupe le plus étalé (63,33) : il étire les points quasi identiques pour leur donner de la place.
- t-SNE invente des groupes. Sur 768 points de bruit gaussien pur, la silhouette d’un k-means à 4 clusters vaut 0,110 dans l’espace d’origine (aucune structure) et 0,381 sur les coordonnées t-SNE : le dessin suggère des groupes qui n’existent pas.
Retiens-le pour le mémoire : un graphique t-SNE est une illustration, jamais un résultat.
Repérer, sans labels, un comportement jamais vu
C’est le lien direct avec les parties 18 et 19 : le modèle supervisé entraîné sans le workload analytique échouait sur les balayages. Peut-on voir, sans aucun label, que les fenêtres analytiques contiennent quelque chose que jvm n’a jamais montré ?
# Fil rouge : repérer, sans aucun label, un comportement absent des données d'entraînement
km = KMeans(n_clusters=6, n_init=10, random_state=0).fit(Z)
print(pd.crosstab(km.labels_, profils.workload))              # un cluster sans aucune fenêtre jvm ?

jvm, ana = profils[profils.workload == "jvm"], profils[profils.workload == "analytique"]
echelle = StandardScaler().fit(jvm[COLS])                    # tout est ajusté sur jvm seulement
Zj, Za = echelle.transform(jvm[COLS]), echelle.transform(ana[COLS])

# a) distance au centroïde jvm le plus proche (k choisi par silhouette sur jvm)
k_jvm = max(range(2, 9), key=lambda k: silhouette_score(
    Zj, KMeans(n_clusters=k, n_init=10, random_state=0).fit_predict(Zj)))
km_jvm = KMeans(n_clusters=k_jvm, n_init=10, random_state=0).fit(Zj)
d_centre_j, d_centre_a = km_jvm.transform(Zj).min(1), km_jvm.transform(Za).min(1)

# b) distance moyenne aux 5 fenêtres jvm les plus proches (densité locale)
nn = NearestNeighbors(n_neighbors=5).fit(Zj)
d_knn_j = nn.kneighbors(Zj, n_neighbors=6)[0][:, 1:].mean(1)  # on s'exclut soi-même
d_knn_a = nn.kneighbors(Za)[0].mean(1)

# Seuil : 99 % des fenêtres jvm sont en dessous ; on signale les fenêtres analytiques au-dessus
res = ana.assign(centroide=d_centre_a > np.quantile(d_centre_j, 0.99),
                 knn=d_knn_a > np.quantile(d_knn_j, 0.99)).groupby("nature")
print(f"k choisi sur jvm : {k_jvm}")
print(pd.DataFrame({"fenêtres": res.size(), "signalées (centroïde)": res.centroide.mean(),
                    "signalées (5 voisins)": res.knn.mean()}).round(2))
Première lecture : la composition des clusters. Avec sur les deux workloads, deux clusters ne contiennent (presque) aucune fenêtre jvm : l’un compte 134 fenêtres analytiques pour 2 jvm (les balayages), l’autre 20 analytiques pour 0 jvm (les rafales). Un cluster qui n’existe que dans les nouvelles données est un signal d’alerte.
Deuxième lecture : une distance au connu. On ajuste tout sur jvm seulement, et on signale une fenêtre analytique si elle est plus loin de jvm que 99 % des fenêtres jvm elles-mêmes.
| Nature (analytique) | Fenêtres | Signalées (distance au centroïde) | Signalées (5 plus proches voisins) |
|---|---|---|---|
| balayage | 136 | 0,00 | 1,00 |
| chaude | 148 | 0,03 | 0,01 |
| froide | 44 | 0,00 | 0,02 |
| périodique | 36 | 0,00 | 0,00 |
| rafale | 20 | 0,05 | 1,00 |
- La distance au centroïde échoue complètement : aucun balayage signalé. La silhouette choisit sur jvm, et le cluster des chaudes y est très étalé : le seuil à 99 % est donc large, et les balayages, pourtant étrangers, passent dessous. Encore l’hypothèse « groupes ronds » de k-means.
- La distance aux 5 plus proches voisins réussit : 100 % des balayages et des rafales signalés, 0 à 2 % de fausses alertes sur les comportements connus. Elle mesure la densité locale : une fenêtre est « nouvelle » si elle n’a aucun voisin jvm proche, quelle que soit la forme des groupes.
On a donc un détecteur, entraîné sans un seul label, qui aurait levé la main sur exactement les deux comportements que jvm n’avait jamais montrés, avant même que le modèle supervisé ne se trompe.
Fil rouge : ce que ça change pour le mémoire
- Le chapitre 4 (analyse exploratoire) a une méthode. Profils par fenêtre, standardisation, PCA pour la variance expliquée et les chargements, k-means avec silhouette, puis vérification avec Ward et DBSCAN. Si trois familles d’algorithmes s’accordent, la structure est probablement réelle.
- H1 se teste aussi sans labels. Les colonnes de régularité (
irregularite,pic_acf) portent PC2 et séparent les périodiques des froides. L’exercice 2 montre qu’avec les seules colonnes d’intensité, l’ARI s’effondre. Sur les vraies traces, si PC2 reste un axe « régularité », c’est un argument pour la périodicité, indépendant de tout modèle. - Tu as maintenant des tranches pour l’analyse d’erreurs. La partie 19 demandait quelles tranches utiliser sans « vraie nature » (exercice 5). Réponse : les clusters de profils. Calcule la perte en excès par cluster au lieu de par nature.
- Un garde-fou pour le démon. La distance aux plus proches voisins des fenêtres d’entraînement est un détecteur de dérive (out-of-distribution) peu coûteux. Si la part de fenêtres signalées dépasse un seuil, le démon peut revenir à une politique prudente (ne plus compresser) plutôt que de faire confiance à un modèle hors de son domaine. On y reviendra en partie 28 (monitoring).
- Attention à la causalité si tu t’en sers en ligne. Ici, les profils regardent des fenêtres entières, ce qui est légitime pour explorer. Comme feature d’un modèle de prédiction, un profil devra être calculé sur les 700 agrégations passées, sinon c’est la fuite par le futur de la partie 14.
- t-SNE dans le mémoire : en annexe, comme illustration, avec la perplexité indiquée, et jamais comme preuve d’une séparation.
Exercice pratique
- La taille de la fenêtre. Remplace
FENETRESpar neuf fenêtres de 300 agrégations (de 0 à 2 700) et relance le choix de . Quel choisit la silhouette ? Que deviennent les balayages ? Relie la réponse à la durée du cycle (240 agrégations). - Sans la régularité. Refais le k-means en ne gardant que
log_intensite,frac_activeetlog_duree_rafale. Quel choisit la silhouette, et quel ARI obtiens-tu à ? Quelles natures fusionnent ? Qu’est-ce que ça dit de l’hypothèse H1 ? - Pourquoi le centroïde échoue. Affiche le seuil à 99 % de la distance au centroïde jvm et la distance médiane des fenêtres de balayage. Puis affiche la table croisée des 3 clusters jvm avec les natures jvm. Quel cluster rend le seuil si large ?
- Un mélange gaussien. Remplace k-means par
GaussianMixture(k, covariance_type="full", random_state=0, n_init=3)pour de 2 à 8, et choisis avec le critère BIC (.bic(Z), le plus petit est le meilleur). Quel obtiens-tu ? Pourquoi le BIC continue-t-il de baisser ? (Pense aux 136 balayages presque superposés.) - Fil rouge. Sur tes vraies traces DAMON, calcule les profils de fenêtre par région, fais la PCA et donne une interprétation de PC1 et PC2 à partir des chargements. Puis calcule la perte en excès de ton modèle de la partie 19 par cluster de profils.
Indices. Question 1 : 1 728 fenêtres ; la silhouette choisit (0,655), ARI 0,84 ; les 304 fenêtres de balayage tombent avec 215 froides : avec 300 agrégations, une fenêtre ne contient souvent qu’une ou deux activations, et l’irrégularité n’est plus mesurable. Question 2 : la silhouette choisit (ARI 0,378) ; à , l’ARI vaut 0,47, et les 136 balayages, les 100 froides et 77 périodiques partagent un cluster : sans les colonnes de régularité, un métronome lent ressemble à du silence. Question 3 : seuil 3,02, distance médiane des balayages 2,78 ; le cluster des 60 chaudes jvm est le plus étalé. Question 4 : le BIC baisse jusqu’à (de −700,4 à −15 856,8) ; à l’ARI vaut 0,973. Des points quasi identiques permettent une covariance presque nulle, donc une vraisemblance qui explose : le BIC n’est pas fiable sur des données aussi dégénérées.
Ressources pour aller plus loin
- James, Witten, Hastie et Tibshirani, An Introduction to Statistical Learning (ISLR), chapitre 12 : PCA, k-means et clustering hiérarchique.
- Documentation scikit-learn : Clustering (comparaison des algorithmes et des métriques, dont la silhouette et l’ARI) et Decomposition (PCA).
- Ester et al., A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise (KDD 1996) : l’article de DBSCAN.
- Wattenberg, Viégas et Johnson, How to Use t-SNE Effectively (Distill, 2016) : les pièges de t-SNE, avec des exemples interactifs.
- Rappels : M1 · Vecteurs, produit scalaire et normes pour les distances, M3 · Valeurs propres, SVD et PCA pour la PCA.
Ce que tu dois savoir faire avant de passer à la suite
- Expliquer pourquoi on standardise avant un clustering, et mesurer ce que coûte l’oubli
- Construire un profil de fenêtre sans label et justifier le choix des colonnes
- Appliquer une PCA, lire la variance expliquée et interpréter les chargements des premiers axes
- Faire tourner k-means, choisir avec la silhouette, et connaître son biais pour les groupes ronds de tailles comparables
- Évaluer un clustering avec l’ARI quand une vérité existe, sans s’en servir pour choisir
- Régler
epsde DBSCAN avec la distance au k-ième voisin, et interpréter les points de bruit - Citer trois choses qu’un graphique t-SNE ne conserve pas
- Construire un détecteur de comportement nouveau par distance aux plus proches voisins
Partie suivante : Un réseau de neurones à la main avec PyTorch (partie 21). On quitte les arbres : on reconstruit en PyTorch le petit réseau écrit en NumPy dans la synthèse M12, avec l’autograd, les nn.Module et une vraie boucle d’entraînement, avant les modèles de séquences.