Évaluer un classifieur pour de vrai
Matrice de confusion, précision, rappel, ROC et PR : choisir la bonne métrique et le bon seuil quand les erreurs n'ont pas le même coût.
Mastering AI · Phase technique · Semaine 1 · Partie 15
Objectif de l’étape
Dans la partie 14, on a jugé les modèles avec l’AUC sans la discuter. Pour le mémoire, ça ne suffit pas : à la fin, il faut décider, région par région, si on la compresse ou non. Et les deux erreurs possibles n’ont pas du tout le même prix. Une région compressée puis relue tout de suite (un faux froid) bloque l’application pendant la décompression. Une région gardée en RAM alors qu’elle ne sert plus (un faux chaud) gaspille un peu de mémoire, sans plus.
À la fin de cet article, tu sauras :
- lire une matrice de confusion et en tirer précision, rappel, F1 et taux de faux froids ;
- expliquer pourquoi l’accuracy trompe dès que les classes sont déséquilibrées ;
- lire une courbe ROC et une courbe précision-rappel, et choisir entre les deux ;
- fixer le seuil de décision à partir d’un coût asymétrique, sur la validation ;
- vérifier si les probabilités d’un modèle sont calibrées.
Notions clés
1. La matrice de confusion
Intuition. Pour chaque région, il y a la vérité (chaude ou froide) et la décision du modèle. Ça fait quatre cases, et toutes les métriques ne sont que des façons de combiner ces quatre nombres.
On prend « chaude » comme classe positive ( : la région est accédée dans les prochaines agrégations).
| Prédite chaude (on garde) | Prédite froide (on compresse) | |
|---|---|---|
| Vraiment chaude | VP : vrai positif | FN : faux froid (coûteux) |
| Vraiment froide | FP : faux chaud (peu coûteux) | VN : vrai négatif |
2. Précision, rappel, F1, et le piège de l’accuracy
Intuition. La précision répond à « quand le modèle dit chaude, a-t-il raison ? ». Le rappel répond à « parmi les régions vraiment chaudes, combien en trouve-t-il ? ».
Le est une moyenne harmonique : il s’effondre dès que l’un des deux est mauvais.
L’accuracy, la part de décisions correctes, est trompeuse dès que les classes sont déséquilibrées. Sur notre test, 31 % des régions sont chaudes : un modèle qui déclare tout froid obtient 68,9 % d’accuracy… avec un rappel nul. Il compresserait toutes les régions chaudes.
3. Le taux de faux froids
Pour zswap, la question opérationnelle est : parmi les régions qu’on compresse, combien sont relues ?
C’est exactement la probabilité calculée avec Bayes en Required Maths M8. Elle dépend du modèle et de la fréquence de base des régions chaudes : le même modèle n’a pas le même taux de faux froids sur un autre workload.
4. Courbes ROC et précision-rappel
Intuition. Un modèle ne sort pas une décision, il sort un score . La décision vient d’un seuil : chaude si . Chaque seuil donne une matrice de confusion différente ; une courbe les montre toutes d’un coup.
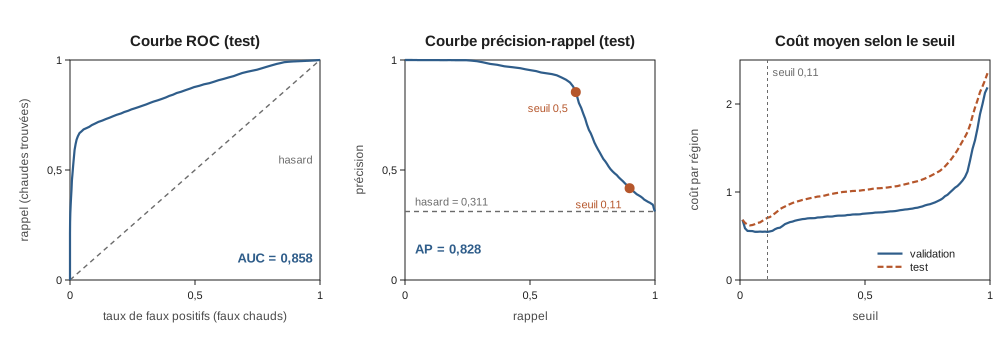
- La courbe ROC trace le rappel (taux de vrais positifs) en fonction du taux de faux positifs . Le hasard donne la diagonale.
- L’AUC ROC a une interprétation probabiliste simple : c’est la probabilité qu’une région chaude tirée au hasard ait un score plus élevé qu’une région froide tirée au hasard. C’est un calcul d’espérance sur des paires, dans l’esprit de Required Maths M7 ; on le vérifie plus bas par simulation.
- La courbe précision-rappel (PR) trace la précision en fonction du rappel. Le hasard y donne une ligne horizontale à la hauteur de la fréquence de base (0,311 ici). Son aire s’appelle la précision moyenne (AP).
Laquelle choisir ? La ROC ne dépend pas de la fréquence de base : pratique pour comparer des modèles entre workloads. La PR, elle, montre ce qui se passe sur la classe rare : quand les positifs sont peu nombreux, une ROC flatteuse peut cacher une précision médiocre (Saito et Rehmsmeier, 2015).
5. Choisir le seuil avec un coût asymétrique
Intuition. Le seuil 0,5 n’a rien de spécial : il revient à dire qu’un faux froid et un faux chaud coûtent pareil. Ce n’est pas notre cas.
Notons le coût d’un faux froid et celui d’un faux chaud. Pour une région de probabilité d’être chaude :
- la compresser coûte en moyenne ;
- la garder coûte en moyenne .
On la garde donc quand , c’est-à-dire :
Avec et , on obtient . Ce rapport 10 est une hypothèse de travail : mesurer le vrai coût d’une décompression zswap face au gain mémoire fera partie du mémoire.
Ce calcul suppose que est une vraie probabilité. Sinon, on choisit le seuil empiriquement, en minimisant le coût moyen sur la validation, jamais sur le test (partie 14).
6. Calibration
Intuition. Un modèle est calibré si, parmi les régions auxquelles il donne , environ 20 % sont vraiment chaudes. Un bon classement (une bonne AUC) ne garantit pas une bonne calibration.
On la mesure de deux façons :
- un diagramme de fiabilité : on regroupe les prédictions par tranches de et on compare le moyen au taux réel ;
- le score de Brier, l’erreur quadratique moyenne sur les probabilités : .
Exemple de code
On reprend tel quel le script de la partie 14 (simulation, features, labels), puis on ajoute les quatre blocs ci-dessous à la suite, dans le même fichier. Le découpage temporel a maintenant trois périodes, chacune séparée par une purge de :
- train : ;
- validation : , pour choisir le seuil ;
- test : , regardé une seule fois. Il contient le changement de régime de .
Seuil par défaut et matrice de confusion
# Suite du script de la partie 14 : df, FEATURES, H et T sont déjà définis.
from sklearn.metrics import (confusion_matrix, precision_score, recall_score, f1_score,
                             accuracy_score, roc_auc_score, roc_curve,
                             precision_recall_curve, average_precision_score, brier_score_loss)

# --- Trois périodes, chacune purgée de H : train | validation | test ---
t_val, t_test = 1400, 1800
train = df[df.t < t_val - H]
val = df[(df.t >= t_val) & (df.t < t_test - H)]
test = df[df.t >= t_test]

modele = HistGradientBoostingClassifier(max_iter=200, random_state=0)
modele.fit(train[FEATURES], train.y)
p_val = modele.predict_proba(val[FEATURES])[:, 1]
p_test = modele.predict_proba(test[FEATURES])[:, 1]
print(f"taux de chaudes : val {val.y.mean():.3f} | test {test.y.mean():.3f}")


def taux_faux_froids(y, pred):
    """Part des régions déclarées froides (donc compressées) qui sont relues : FN / (FN + VN)."""
    froides = pred == 0
    return (y[froides] == 1).mean()


def resume(y, p, seuil):
    pred = (p >= seuil).astype(int)
    vn, fp, fn, vp = confusion_matrix(y, pred).ravel()
    return dict(seuil=seuil, VP=vp, FP=fp, FN=fn, VN=vn,
                accuracy=accuracy_score(y, pred), precision=precision_score(y, pred),
                rappel=recall_score(y, pred), f1=f1_score(y, pred),
                faux_froids=taux_faux_froids(y.to_numpy(), pred))


# 1. Le seuil par défaut, et le piège de l'accuracy
r = resume(test.y, p_test, 0.5)
print(f"seuil 0,5 : VP = {r['VP']}, FP = {r['FP']}, FN = {r['FN']}, VN = {r['VN']}")
print(f"accuracy {r['accuracy']:.3f} | précision {r['precision']:.3f} | rappel {r['rappel']:.3f} | "
      f"F1 {r['f1']:.3f} | faux froids {r['faux_froids']:.3f}")
print(f"« tout est froid » : accuracy = {1 - test.y.mean():.3f}, rappel = 0")
| Seuil 0,5 sur le test | Valeur |
|---|---|
| VP / FP / FN / VN | 24 305 / 4 149 / 11 274 / 74 512 |
| Accuracy | 0,865 |
| Précision | 0,854 |
| Rappel | 0,683 |
| 0,759 | |
| Taux de faux froids | 0,131 |
| « Tout froid » : accuracy | 0,689 (rappel 0) |
Avec le seuil par défaut, le modèle a l’air bon (86,5 % d’accuracy, 85 % de précision). Mais 13,1 % des régions compressées sont relues dans la seconde qui suit : un tiers des régions chaudes (11 274 sur 35 579) finit dans zswap.
ROC, PR, et l’AUC comme probabilité
# 2. ROC et PR : des courbes qui ne dépendent d'aucun seuil
auc = roc_auc_score(test.y, p_test)
ap = average_precision_score(test.y, p_test)
rng_auc = np.random.default_rng(0)
i_pos = rng_auc.choice(np.flatnonzero(test.y == 1), 200_000)
i_neg = rng_auc.choice(np.flatnonzero(test.y == 0), 200_000)
p_gagne = (p_test[i_pos] > p_test[i_neg]).mean() + 0.5 * (p_test[i_pos] == p_test[i_neg]).mean()
print(f"AUC ROC = {auc:.3f} | P(score chaude > score froide) = {p_gagne:.3f}")
print(f"précision moyenne (AUC PR) = {ap:.3f} | hasard = {test.y.mean():.3f}")
- AUC ROC = 0,858, et la probabilité estimée sur 200 000 paires (chaude, froide) vaut aussi 0,858 : l’AUC est bien .
- Précision moyenne = 0,828, contre 0,311 pour le hasard.
- L’AUC est un peu plus basse qu’en partie 14 (0,864) : le train s’arrête maintenant à au lieu de 1790, pour laisser la place à la validation.
Le seuil qui minimise le coût
# 3. Choisir le seuil avec un coût asymétrique (sur la validation, jamais sur le test)
C_FAUX_FROID, C_FAUX_CHAUD = 10, 1          # un faux froid coûte 10 fois plus cher


def cout_moyen(y, p, seuil):
    pred = p >= seuil
    fn = np.sum((y == 1) & ~pred)            # faux froids : relues alors que compressées
    fp = np.sum((y == 0) & pred)             # faux chauds : mémoire gardée pour rien
    return (C_FAUX_FROID * fn + C_FAUX_CHAUD * fp) / len(y)


seuils = np.linspace(0.01, 0.99, 99)
couts_val = [cout_moyen(val.y.to_numpy(), p_val, s) for s in seuils]
s_val = seuils[int(np.argmin(couts_val))]
s_theorique = C_FAUX_CHAUD / (C_FAUX_CHAUD + C_FAUX_FROID)
print(f"seuil optimal sur la validation : {s_val:.2f} | seuil théorique : {s_theorique:.3f}")
for s in (0.5, s_val):
    r = resume(test.y, p_test, s)
    print(f"test, seuil {s:.2f} : coût = {cout_moyen(test.y.to_numpy(), p_test, s):.3f} | "
          f"précision {r['precision']:.3f} | rappel {r['rappel']:.3f} | "
          f"faux froids {r['faux_froids']:.3f} | régions compressées {(p_test < s).mean():.3f}")
| Test | Seuil 0,5 | Seuil 0,11 (choisi sur la validation) |
|---|---|---|
| Coût moyen par région | 1,023 | 0,707 |
| Précision | 0,854 | 0,417 |
| Rappel | 0,683 | 0,899 |
| Taux de faux froids | 0,131 | 0,096 |
| Régions compressées | 75,1 % | 32,9 % |
Quatre leçons :
- le seuil trouvé sur la validation (0,11) est proche du seuil théorique (0,091) : les probabilités du modèle sont à peu près utilisables telles quelles ;
- baisser le seuil réduit le coût de 31 %, mais on compresse beaucoup moins (32,9 % des régions au lieu de 75,1 %). C’est le vrai compromis du mémoire : gain mémoire contre faux froids ;
- même au meilleur seuil, le taux de faux froids reste à 9,6 % sur le test. La courbe orange de la figure montre pourquoi : après le changement de régime, la courbe de coût se déplace, et le seuil idéal du test n’est plus celui de la validation. On ne s’en sert pas pour choisir (ce serait une fuite), mais c’est un avertissement pour la surveillance en production (partie 28) ;
- attention à la bonne référence : ne jamais compresser coûte par région sur le test, puisque chaque région froide devient un faux chaud. Au seuil 0,11, le modèle coûte 0,707 : un peu plus que ne rien faire. Sur la validation, il battait nettement cette référence (0,547 contre , voir partie 16) ; c’est le changement de régime qui le fait passer derrière. Un modèle se compare donc d’abord à « ne jamais compresser », pas seulement au seuil 0,5.
Calibration
# 4. Calibration : une probabilité de 0,2 veut-elle dire « chaude 1 fois sur 5 » ?
bornes = [0, 0.05, 0.2, 0.4, 0.6, 0.8, 0.95, 1.0001]
for nom, y, p in (("validation", val.y.to_numpy(), p_val), ("test", test.y.to_numpy(), p_test)):
    print(f"{nom} : Brier = {brier_score_loss(y, p):.4f}")
    for a, b in zip(bornes[:-1], bornes[1:]):
        m = (p >= a) & (p < b)
        print(f"   p dans [{a:.2f} ; {min(b, 1):.2f}[ : n = {m.sum():>6} | p moyen {p[m].mean():.3f} | "
              f"taux réel {y[m].mean():.3f}")
| Tranche de | moyen (val) | Taux réel (val) | moyen (test) | Taux réel (test) |
|---|---|---|---|---|
| 0,020 | 0,021 | 0,024 | 0,043 | |
| 0,116 | 0,113 | 0,118 | 0,138 | |
| 0,275 | 0,146 | 0,274 | 0,170 | |
| 0,470 | 0,227 | 0,484 | 0,249 | |
| 0,716 | 0,688 | 0,713 | 0,602 | |
| 0,902 | 0,908 | 0,891 | 0,870 | |
| 0,987 | 0,994 | 0,990 | 0,982 | |
| Score de Brier | 0,0827 | 0,1119 |
- Aux extrémités, le modèle est bien calibré. Dans la zone 0,2 à 0,6, il surestime la probabilité d’être chaude : il annonce 47 % de chances, la réalité est 23 %. Environ 15 % des régions de la validation (19 % du test) tombent là, mais elles sont toutes au-dessus du seuil retenu (0,11) : on les garde en RAM de toute façon, donc cette erreur de calibration ne change aucune décision.
- Ce qui compte pour notre seuil, c’est la zone basse. Sur la validation, elle est très bien calibrée (0,020 annoncé, 0,021 réel). Sur le test, le taux réel double (0,024 annoncé, 0,043 réel) : après le changement de régime, des régions « sûrement froides » se réveillent. Le Brier passe de 0,083 à 0,112.
Fil rouge : les métriques du protocole
Pour le chapitre Méthodologie du mémoire, chaque modèle (régression logistique, LightGBM, LSTM) sera rapporté avec :
| Métrique | Pourquoi |
|---|---|
| AUC ROC | qualité du classement, indépendante de la fréquence de base, comparable entre workloads |
| Précision moyenne (AP) | qualité sur la classe chaude, sensible au déséquilibre |
| Précision, rappel, au seuil retenu | lisibles par un jury |
| Taux de faux froids au seuil retenu | l’impact direct sur la latence avec zswap |
| Part de régions compressées | le gain mémoire, l’autre plateau de la balance |
| Coût moyen, comparé à « ne jamais compresser » | le modèle fait-il mieux que ne rien faire ? |
| Brier et diagramme de fiabilité | les probabilités sont-elles utilisables pour fixer un seuil ? |
Le seuil est toujours choisi sur la validation, avec un coût annoncé à l’avance, et les écarts entre modèles sont testés avec les outils de Required Maths M9 (bootstrap apparié, McNemar).
Exercice pratique
- Taux de faux froids sous 1 %. Trouve, sur la validation, le plus grand seuil qui garde le taux de faux froids sous 1 %. Quelle part des régions compresse-t-on encore ? Applique ce seuil au test : la contrainte tient-elle ? Explique avec la notion 3 et le tableau de calibration.
- Autres coûts. Refais le choix du seuil avec un rapport de 3, puis de 30. Compare chaque fois le seuil trouvé sur la validation au seuil théorique .
- Calibrer. Recalibre le modèle déjà entraîné sur la validation :
CalibratedClassifierCV(FrozenEstimator(modele), method="isotonic").fit(val[FEATURES], val.y)(imports depuissklearn.calibrationetsklearn.frozen). Le Brier du test s’améliore-t-il ? Le seuil optimal se rapproche-t-il de ? - Le piège de la fréquence de base. Sous-échantillonne au hasard les régions chaudes du test pour qu’elles ne représentent plus que 5 % des exemples. Au seuil 0,5, que deviennent l’accuracy, la précision, le rappel, l’AUC ROC et la précision moyenne ? Lesquelles dépendent de la fréquence de base, et lesquelles non ?
- Fil rouge. Écris dans tes notes le paragraphe « Métriques » du protocole : les sept métriques ci-dessus, le rapport de coût choisi et sa justification, et la période sur laquelle le seuil est fixé.
Indice pour la question 1 : sur la validation, un seuil autour de 0,03 suffit, et on ne compresse alors plus qu’environ 15 % des régions. Regarde ensuite le taux de faux froids sur le test.
Ressources pour aller plus loin
- Documentation scikit-learn : Metrics and scoring: quantifying the quality of predictions et Probability calibration.
- Saito et Rehmsmeier, The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets (PLOS ONE, 2015).
- Fawcett, An introduction to ROC analysis (Pattern Recognition Letters, 2006).
- Elkan, The Foundations of Cost-Sensitive Learning (IJCAI 2001) : d’où vient le seuil .
Ce que tu dois savoir faire avant de passer à la suite
- Lire une matrice de confusion et en déduire précision, rappel, et taux de faux froids
- Expliquer pourquoi l’accuracy trompe sur des classes déséquilibrées
- Interpréter l’AUC ROC comme une probabilité, et choisir entre ROC et PR
- Dériver le seuil optimal et le retrouver empiriquement sur la validation
- Vérifier la calibration d’un modèle avec un diagramme de fiabilité et le score de Brier
- Comparer le coût d’un modèle à celui de « ne jamais compresser »
Partie suivante : Modèles linéaires et régularisation (partie 16). On ouvre la boîte : la régression logistique du mémoire, ses coefficients, et ce que les pénalités et de M11 changent en pratique.