Validation et tuning sérieux
Folds temporels avec purge, grille contre hasard contre Optuna, et leave-one-workload-out : régler ses modèles sans se mentir, et mesurer ce que coûte un workload jamais vu.
Mastering AI · Phase technique · Semaine 2 · Partie 18
Objectif de l’étape
Depuis la partie 15, on choisit tout (seuil, features, taille du modèle) sur une seule période de validation, . La partie 17 a montré la limite : des modèles presque identiques en validation donnent des coûts de test entre 0,637 et 0,826. Une seule période, c’est une seule mesure, donc un seul tirage du bruit.
À la fin de cet article, tu sauras :
- expliquer pourquoi le K-fold mélangé est interdit sur des traces temporelles, chiffres à l’appui ;
- construire une validation croisée temporelle avec purge et lire la dispersion de ses folds ;
- comparer grille, recherche aléatoire et Optuna à budget égal, sans surinterpréter le gagnant ;
- mettre en place un leave-one-workload-out pour tester la généralisation à un workload jamais vu.
Notions clés
1. Pourquoi le K-fold mélangé est interdit ici
Intuition. Le K-fold classique découpe les lignes au hasard en paquets, entraîne sur et valide sur le dernier. Sur nos traces, deux lignes voisines dans le temps se ressemblent presque à l’identique : le mélange met la ligne en entraînement et la ligne en validation. C’est la fuite par le découpage de la partie 14, répétée fois.
Le K-fold suppose des exemples indépendants et de même loi (le cadre de la partie 13). Nos exemples ne sont ni l’un ni l’autre : ils sont corrélés dans le temps, et la loi change au milieu de la trace.
2. La validation croisée temporelle
Intuition. On rejoue plusieurs fois la situation de production : « entraîne sur le passé, prédis la suite », en avançant la date de coupure.
On découpe la période de développement en blocs consécutifs. Le fold entraîne sur les blocs à et valide sur le bloc :
- La purge de agrégations avant chaque validation vient de la partie 14 : un label d’entraînement regarde pas en avant, il ne doit pas voir la validation. La seconde purge (à la fin de chaque bloc de validation sauf le dernier) évite que les labels de validation regardent le bloc suivant.
- Fenêtre qui s’agrandit (expanding window) : chaque fold garde tout le passé. Fenêtre glissante (rolling window) : on ne garde que les derniers blocs, utile quand le vieux passé ne ressemble plus au présent.
TimeSeriesSplitde scikit-learn fait la même chose, avec un paramètregappour la purge, mais il découpe des numéros de lignes en supposant une ligne par instant. Chez nous, il y a 96 lignes par instant (une par région) : on découpe donc surtdirectement, en dix lignes de code.
3. Un score de validation est une variable aléatoire
Intuition. Chaque fold donne une AUC un peu différente. La moyenne est l’estimation ; la dispersion dit à quel point il faut lui faire confiance.
Avec folds de scores , on rapporte la moyenne et l’écart-type entre folds. Pour comparer deux réglages A et B, on compare fold par fold : les deux voient exactement les mêmes données, donc les différences éliminent la difficulté propre à chaque fold. C’est l’idée de l’échantillon apparié de Required Maths M9.
Deux précautions :
- les folds ne sont pas indépendants (les ensembles d’entraînement se recouvrent), donc pas de test de Student naïf sur 4 valeurs ; on regarde si l’écart a toujours le même signe et s’il dépasse la dispersion entre folds ;
- la moyenne des folds estime la performance dans les conditions de la période de développement. Si le test contient quelque chose de nouveau (un changement de régime), aucune validation interne ne peut le prévoir.
4. Chercher les hyperparamètres : grille, hasard, optimisation bayésienne
Intuition. Chaque essai coûte entraînements. La question est : où dépenser un budget fixe d’essais ?
- Grille : toutes les combinaisons de quelques valeurs par paramètre. Simple, mais avec 4 paramètres et 3 valeurs, c’est déjà 81 essais, et chaque paramètre n’est testé qu’en 3 valeurs.
- Recherche aléatoire : on tire chaque paramètre au hasard dans un intervalle. À budget égal, chaque paramètre est testé en autant de valeurs que d’essais. Quand seuls un ou deux paramètres comptent vraiment, c’est nettement mieux que la grille (Bergstra et Bengio, 2012).
- Optimisation bayésienne (Optuna, TPE) : après quelques essais au hasard, l’algorithme sépare les essais en « bons » et « mauvais », modélise les deux distributions de paramètres et , et propose le point qui maximise : là où les bons essais sont fréquents et les mauvais rares.
Pour les paramètres « multiplicatifs » (taux d’apprentissage, nombre de feuilles, min_child_samples), on tire sur une échelle logarithmique : passer de 0,01 à 0,02 compte autant que de 0,1 à 0,2.
5. Surapprendre la validation
Intuition. Si tu lances 100 essais dont les scores ne diffèrent que par le bruit, le meilleur sera quand même au-dessus des autres, par chance. Son score est biaisé vers le haut : c’est la malédiction du gagnant.
Plus on fait d’essais sur la même validation, plus elle devient une partie de l’entraînement. Les parades :
- un test vu une seule fois, après tous les choix (partie 14) ;
- la validation croisée imbriquée (nested CV) : une boucle interne choisit les hyperparamètres, une boucle externe mesure la performance de toute la procédure de choix ;
- se méfier de tout écart plus petit que la dispersion entre folds.
6. Leave-one-group-out : généraliser à un workload jamais vu
Intuition. Ton démon tournera sur des programmes que tu n’as pas tracés. La vraie question n’est pas « prédit-il bien la suite de cette trace ? », mais « prédit-il bien une trace d’un autre programme ? ».
On regroupe les données par workload (un programme, une charge). Pour chaque workload , on entraîne sur tous les autres et on teste sur . Combiné au découpage temporel, on obtient trois protocoles, testés sur exactement les mêmes lignes (la fin de la trace de ) :
| Protocole | Entraînement | Ce qu’il mesure |
|---|---|---|
| Intra | le passé de | prédire la suite d’un workload connu |
| Leave-one-workload-out | le passé des autres workloads | généraliser à un workload jamais vu |
| Tous | le passé de tous, compris | ce qu’apporte le fait d’avoir déjà vu |
L’écart entre « intra » et « leave-one-workload-out » est le prix de la nouveauté.
Exemple de code
Comme en parties 15 à 17, on reprend tel quel le script de la partie 14, puis on ajoute les trois blocs ci-dessous à la suite, dans le même fichier. La période de développement est (le train et la validation des parties précédentes réunis), le test reste . L’ensemble tourne en trois minutes environ (numpy 2.5, pandas 3.0, scikit-learn 1.9, lightgbm 4.7, optuna 5.0).
K-fold mélangé contre folds temporels
# Suite du script de la partie 14 : df, FEATURES, H, T, np, pd, roc_auc_score,
# simuler_segment, construire_dataset, TYPES, TAILLE_BLOC, N_REGIONS et T_CHANGEMENT sont déjà définis.
import itertools
import time
import lightgbm as lgb
import optuna
from sklearn.model_selection import KFold

# Développement = tout ce qui précède le test (train + validation des parties 15 à 17)
t_test = 1800
dev = df[df.t < t_test - H].reset_index(drop=True)
test = df[df.t >= t_test]


# 1. K-fold mélangé contre folds temporels avec purge
def folds_temporels(d, k=4, purge=H):
    """Fenêtre qui s'agrandit : on entraîne sur le passé, on valide sur le bloc suivant."""
    bornes = np.linspace(d.t.min(), d.t.max() + 1, k + 2).astype(int)
    for i in range(1, k + 1):
        tr = np.flatnonzero(d.t < bornes[i] - purge)              # purge avant la validation
        fin = bornes[i + 1] - purge if i < k else bornes[i + 1]   # label sans recouvrement avec le bloc suivant
        va = np.flatnonzero((d.t >= bornes[i]) & (d.t < fin))
        yield tr, va


def score_cv(params, d, decoupage):
    scores = []
    for tr, va in decoupage:
        m = lgb.LGBMClassifier(**params, random_state=0, verbose=-1).fit(d.iloc[tr][FEATURES], d.y.iloc[tr])
        scores.append(roc_auc_score(d.y.iloc[va], m.predict_proba(d.iloc[va][FEATURES])[:, 1]))
    return np.array(scores)


BASE = dict(num_leaves=31, n_estimators=100, learning_rate=0.1)
print("bornes des blocs :", np.linspace(dev.t.min(), dev.t.max() + 1, 6).astype(int))
melange = score_cv(BASE, dev, KFold(4, shuffle=True, random_state=0).split(dev))
temporel = score_cv(BASE, dev, list(folds_temporels(dev)))
m = lgb.LGBMClassifier(**BASE, random_state=0, verbose=-1).fit(dev[FEATURES], dev.y)
print(f"K-fold mélangé {melange.round(3)} moyenne {melange.mean():.3f}")
print(f"folds temporels {temporel.round(3)} moyenne {temporel.mean():.3f} écart-type {temporel.std(ddof=1):.3f}")
print(f"test (une seule fois) {roc_auc_score(test.y, m.predict_proba(test[FEATURES])[:, 1]):.3f}")
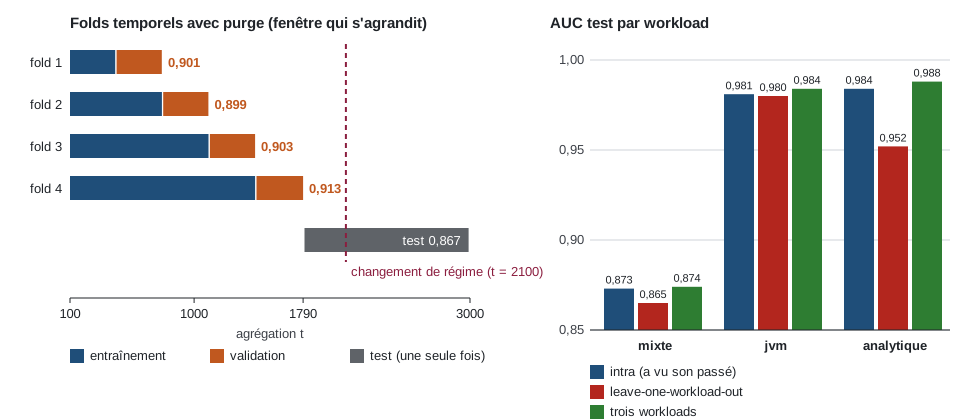
Les blocs commencent à = 100, 438, 776, 1 114 et 1 452 ; le dernier se termine à 1 790.
| Protocole | AUC par fold | Moyenne |
|---|---|---|
| K-fold mélangé | 0,937 · 0,939 · 0,940 · 0,940 | 0,939 |
| Folds temporels avec purge | 0,901 · 0,899 · 0,903 · 0,913 | 0,904 (écart-type 0,006) |
| Test, vu une seule fois | 0,867 |
- Le K-fold mélangé ment de 3,5 points sur la même période et avec le même modèle. Ses quatre folds sont presque identiques (0,937 à 0,940) : la faible dispersion ne rassure pas, elle confirme qu’on mesure toujours la même fuite.
- Les folds temporels sont honnêtes, mais pas clairvoyants. Ils annoncent 0,904 ; le test donne 0,867. Toute la période de développement est avant le changement de régime de , donc aucun fold ne le contient. La validation croisée temporelle estime bien la performance « tant que le workload ne change pas », et rien de plus.
Grille, hasard et Optuna, à budget égal
# 2. Même budget (18 essais), trois façons de chercher
optuna.logging.set_verbosity(optuna.logging.WARNING)
FOLDS = list(folds_temporels(dev))
BUDGET = 18
essais = {}

# a) Grille : 3 x 3 x 2 = 18 combinaisons
grille = [dict(num_leaves=f, learning_rate=lr, n_estimators=n)
          for f, lr, n in itertools.product([8, 31, 127], [0.03, 0.1, 0.3], [50, 200])]
essais["grille"] = [(p, score_cv(p, dev, FOLDS)) for p in grille]

# b) Recherche aléatoire : 18 tirages, échelle log pour les paramètres « multiplicatifs »
rng_r = np.random.default_rng(0)
log_unif = lambda a, b: float(np.exp(rng_r.uniform(np.log(a), np.log(b))))
aleatoire = [dict(num_leaves=int(log_unif(4, 256)), learning_rate=log_unif(0.01, 0.3),
                  n_estimators=int(rng_r.integers(20, 301)), min_child_samples=int(log_unif(5, 1000)))
             for _ in range(BUDGET)]
essais["aléatoire"] = [(p, score_cv(p, dev, FOLDS)) for p in aleatoire]


# c) Optuna (TPE) : 6 essais au hasard, puis il propose là où c'est prometteur
def objectif(trial):
    p = dict(num_leaves=trial.suggest_int("num_leaves", 4, 256, log=True),
             learning_rate=trial.suggest_float("learning_rate", 0.01, 0.3, log=True),
             n_estimators=trial.suggest_int("n_estimators", 20, 300),
             min_child_samples=trial.suggest_int("min_child_samples", 5, 1000, log=True))
    s = score_cv(p, dev, FOLDS)
    trial.set_user_attr("folds", s.tolist())
    return s.mean()


etude = optuna.create_study(direction="maximize",
                            sampler=optuna.samplers.TPESampler(seed=0, n_startup_trials=6))
etude.optimize(objectif, n_trials=BUDGET)
essais["optuna"] = [(t.params, np.array(t.user_attrs["folds"])) for t in etude.trials]

for nom, liste in essais.items():
    p, s = max(liste, key=lambda e: e[1].mean())
    m = lgb.LGBMClassifier(**p, random_state=0, verbose=-1).fit(dev[FEATURES], dev.y)
    auc_test = roc_auc_score(test.y, m.predict_proba(test[FEATURES])[:, 1])
    ecarts = s - temporel                                   # fold par fold, contre BASE
    print(f"{nom:>9} | meilleur CV {s.mean():.4f} | gain par fold sur BASE {ecarts.round(3)} | "
          f"test {auc_test:.4f} | { {k: round(v, 3) for k, v in p.items()} }")
Référence : le réglage de base (31 feuilles, 100 arbres, taux 0,1) obtient 0,904 en validation croisée et 0,867 en test.
| Méthode | Meilleur réglage | AUC CV | Gain par fold sur la base | AUC test |
|---|---|---|---|---|
| Grille | 31 feuilles, taux 0,03, 50 arbres | 0,9063 | +0,002 · +0,001 · +0,002 · +0,004 | 0,8687 |
| Aléatoire | 56 feuilles, taux 0,025, 106 arbres, min_child_samples 5 |
0,9089 | +0,001 · +0,004 · +0,007 · +0,008 | 0,8735 |
| Optuna | 40 feuilles, taux 0,044, 101 arbres, min_child_samples 37 |
0,9082 | +0,004 · +0,001 · +0,005 · +0,006 | 0,8729 |
- Le tuning rapporte, un peu. Les trois méthodes battent la base sur chacun des quatre folds : le gain est réel, mais il vaut 2 à 5 millièmes d’AUC. Sur le test, il se retrouve (0,867 → 0,869 à 0,874).
- On ne peut pas classer les trois méthodes. Entre la meilleure (0,9089) et la moins bonne (0,9063), l’écart est de 0,003, la moitié de l’écart-type entre folds (0,006), avec une seule graine et 18 essais. Ici, la recherche aléatoire est devant ; avec une autre graine, ce pourrait être Optuna. Optuna devient vraiment utile quand le budget est grand et chaque essai cher.
- La grille a gagné sur un bord. Son meilleur point utilise la plus petite valeur testée du taux (0,03) et du nombre d’arbres (50) : l’optimum est peut-être en dehors de la grille. C’est le signal classique pour élargir ou passer au hasard. La grille n’a d’ailleurs jamais touché
min_child_samples. - L’écart validation–test (environ 3,5 points) est sept fois plus grand que tout ce que le tuning a gagné. Le goulot n’est pas le réglage du modèle ; c’est le changement de régime, déjà au cœur des parties 16 et 17.
Leave-one-workload-out
On ajoute deux workloads simulés au workload « mixte » des parties précédentes :
- jvm : 70 % de blocs périodiques, un autre mélange des mêmes quatre comportements ;
- analytique : 40 % de blocs en balayage, un comportement nouveau. La région
regest lue toutes les 240 agrégations, 2 agrégations après sa voisinereg - 1, comme un scan séquentiel d’une table. Aucun des deux autres workloads ne contient ce comportement, et 240 est bien au-delà des périodes de 15 à 60 des régions périodiques.
Chaque workload garde son changement de régime à . Les hyperparamètres sont ceux trouvés par Optuna au bloc précédent.
# 3. Leave-one-workload-out : trois workloads, dont un avec un comportement nouveau
def simuler_workload(graine, types, p, cycle_balayage=240):
    """Comme simuler_traces, avec un mélange de comportements propre au workload.
    « balayage » : la région reg est lue 2 agrégations après sa voisine reg - 1 (scan séquentiel)."""
    r = np.random.default_rng(graine)
    acces = np.zeros((N_REGIONS, T), dtype=int)
    temps = np.arange(T)
    for bloc in range(N_REGIONS // TAILLE_BLOC):
        avant = r.choice(types, p=p)
        apres = r.choice(types, p=p) if r.random() < 0.4 else avant
        for reg in range(bloc * TAILLE_BLOC, (bloc + 1) * TAILLE_BLOC):
            for debut, fin, type_ in [(0, T_CHANGEMENT, avant), (T_CHANGEMENT, T, apres)]:
                if type_ == "balayage":
                    actif = (temps[debut:fin] - 2 * reg) % cycle_balayage < 2
                    acces[reg, debut:fin] = actif * r.poisson(6, fin - debut)
                else:
                    acces[reg, debut:fin] = simuler_segment(type_, fin - debut, r)
    return acces


workloads = {
    "mixte": df[FEATURES + ["region", "t", "y"]],      # celui des parties 14 à 17
    "jvm": construire_dataset(simuler_workload(11, TYPES, [0.7, 0.1, 0.1, 0.1])),
    "analytique": construire_dataset(simuler_workload(12, TYPES + ["balayage"], [0.1, 0.15, 0.25, 0.1, 0.4])),
}
tous = pd.concat([d.assign(workload=nom) for nom, d in workloads.items()], ignore_index=True)
avant, apres = tous[tous.t < t_test - H], tous[tous.t >= t_test]
P = etude.best_params                                      # les réglages trouvés par Optuna
ajuster = lambda d: lgb.LGBMClassifier(**P, random_state=0, verbose=-1).fit(d[FEATURES], d.y)

for nom in workloads:
    te = apres[apres.workload == nom]                      # même test pour les trois modèles
    auc = lambda m: roc_auc_score(te.y, m.predict_proba(te[FEATURES])[:, 1])
    intra = ajuster(avant[avant.workload == nom])          # a vu le passé de ce workload
    lowo = ajuster(avant[avant.workload != nom])           # n'a jamais vu ce workload
    tous3 = ajuster(avant)                                 # a vu le passé des trois
    print(f"{nom:>10} | positifs {workloads[nom].y.mean():.3f} | intra {auc(intra):.3f} | "
          f"leave-one-workload-out {auc(lowo):.3f} | trois workloads {auc(tous3):.3f}")
| Workload | Positifs | Intra | Leave-one-workload-out | Trois workloads |
|---|---|---|---|---|
| mixte | 30,7 % | 0,873 | 0,865 | 0,874 |
| jvm | 43,8 % | 0,981 | 0,980 | 0,984 |
| analytique | 45,1 % | 0,984 | 0,952 | 0,988 |
- Un nouveau mélange de comportements connus ne coûte presque rien. Sur jvm, le modèle qui n’a jamais vu ce workload fait 0,980, contre 0,981 pour celui qui a vu son passé. Les features décrivent la région elle-même (récence, rythme, phase), pas le programme : un bloc périodique se ressemble d’un workload à l’autre.
- Un comportement nouveau coûte cher. Sur analytique, l’AUC tombe de 0,984 à 0,952 quand le balayage n’a jamais été vu : 3,2 points perdus, du même ordre que les 3,5 points que le K-fold mélangé faisait gagner illusoirement. Cette chute est invisible pour toute validation faite à l’intérieur d’un seul workload.
- Voir le workload aide toujours un peu. Avec les trois workloads, chaque test est au moins aussi bon qu’en intra (0,874, 0,984, 0,988) : plus de comportements vus, sans en oublier.
- Le taux de positifs change d’un workload à l’autre (30,7 % à 45,1 %). L’AUC n’en dépend pas, mais un seuil choisi sur d’autres workloads (partie 15) risque d’être mal placé : à vérifier sur tes vraies traces.
Fil rouge : ce que ça change pour le mémoire
- Q3 et H3 ont maintenant un protocole. La question de généralisation (Q3) se mesure par l’écart entre « intra » et « leave-one-workload-out », pour chaque workload tracé avec DAMON, avec le même test (la fin de chaque trace). Rapporte les trois colonnes du tableau, pas seulement la moyenne : la moyenne cacherait qu’un seul workload s’effondre.
- Choisis tes workloads pour leur diversité de comportements, pas pour leur nombre. Ce qui fait chuter le modèle, c’est un motif d’accès jamais vu (ici le balayage), pas un nouveau programme qui mélange des motifs connus. Pour le mémoire : un workload JVM (GC périodique), une base de données ou un moteur analytique (scans), un serveur web (rafales), au minimum.
- Tuning : une procédure, pas un chiffre. Écris dans la méthodologie l’espace de recherche (avec les échelles log), le budget d’essais, les folds temporels et la purge. Rapporte la dispersion entre folds à côté de chaque gain : un gain plus petit que cette dispersion ne se défend pas devant un jury.
- Le test ne sert qu’une fois, après tous ces choix. Pour LightGBM comme pour le LSTM : même folds, même budget de tuning, même protocole leave-one-workload-out, sinon la comparaison de la partie 24 ne vaudra rien.
Exercice pratique
- Fenêtre glissante. Écris
folds_glissants(d, k=4, purge=H, largeur=2), identique àfolds_temporelssauf que l’entraînement du fold ne garde que les deux blocs précédents (à partir debornes[max(0, i - largeur)]). Compare la moyenne et les quatre scores avec la fenêtre qui s’agrandit. Dans quelle situation la fenêtre glissante gagnerait-elle ? - La purge compte-t-elle ici ? Relance
score_cv(BASE, dev, list(folds_temporels(dev, purge=0))). Pourquoi l’effet est-il si faible avec et des blocs de 338 agrégations ? Que se passerait-il avec ? LeaveOneGroupOutde scikit-learn. Calculecross_val_score(lgb.LGBMClassifier(**P, random_state=0, verbose=-1), avant[FEATURES], avant.y, groups=avant.workload, cv=LeaveOneGroupOut(), scoring="roc_auc"). Les scores sont-ils comparables à la colonne « leave-one-workload-out » du tableau ? Qu’est-ce qui diffère dans ce qui est testé ?- Doubler le budget. Relance l’étude Optuna avec
n_trials=36. De combien la meilleure AUC de validation croisée progresse-t-elle ? Et l’AUC de test du modèle réentraîné ? Relie ta réponse à la malédiction du gagnant. - Fil rouge. Écris le paragraphe « Protocole d’évaluation » de ton mémoire : folds temporels (nombre, purge), espace de recherche et budget, liste des workloads avec le comportement que chacun apporte, et les trois protocoles intra / leave-one-workload-out / tous.
Indices. Question 1 : 0,901 · 0,899 · 0,902 · 0,905, moyenne 0,902, quasiment comme la fenêtre qui s’agrandit, car rien ne change avant
. Question 2 : 0,899 · 0,900 · 0,903 · 0,915, moyenne 0,904 ; la purge ne retire que 10 agrégations sur environ 338 par bloc. Question 3 : dans l’ordre analytique, jvm, mixte : 0,964, 0,985, 0,898. Ici, on teste toute la trace du workload exclu, y compris les 70 % d’avant le changement de régime, et on entraîne sans séparation temporelle ; d’où le 0,898 du mixte, plus haut que 0,865. Question 4 : 0,9082 → 0,9098 en validation croisée, 0,8729 → 0,8739 en test (meilleur réglage : 55 feuilles, taux 0,02, 119 arbres, min_child_samples 28) : un gain de deux millièmes pour deux fois plus de calcul.
Ressources pour aller plus loin
- Documentation scikit-learn : Cross-validation: evaluating estimator performance, sections Cross validation of time series data et Group k-fold / Leave One Group Out.
- Documentation Optuna : Tutorial, en particulier Efficient Optimization Algorithms (TPE, élagage).
- Bergstra et Bengio, Random Search for Hyper-Parameter Optimization (JMLR, 2012).
- Cawley et Talbot, On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation (JMLR, 2010) : la malédiction du gagnant et la validation imbriquée.
- Rappel : M9 · Statistique inférentielle pour comparer des modèles, pour les comparaisons appariées et les intervalles de confiance.
Ce que tu dois savoir faire avant de passer à la suite
- Expliquer, chiffres à l’appui, pourquoi le K-fold mélangé surestime la performance sur des traces temporelles
- Écrire des folds temporels avec purge, en fenêtre qui s’agrandit et en fenêtre glissante
- Rapporter un score de validation croisée avec sa dispersion, et comparer deux réglages fold par fold
- Lancer une étude Optuna (espace de recherche en échelle log, budget fixé) et la comparer à une recherche aléatoire
- Reconnaître les signes d’un surapprentissage de la validation : optimum sur un bord, gain plus petit que la dispersion
- Mettre en œuvre un leave-one-workload-out et l’interpréter face aux protocoles intra et tous
Partie suivante : Comprendre ce que le modèle a appris (partie 19). On sait maintenant mesurer honnêtement ; on va ouvrir le modèle retenu pour comprendre ce qu’il regarde, et pourquoi il rate un balayage qu’il n’a jamais vu.