Arbres, forêts et gradient boosting
Arbres, bagging, boosting et LightGBM sur les traces mémoire : comment un arbre trouve seul les bosses qu'on fabriquait à la main, et le plus petit modèle qui garde le gain.
Mastering AI · Phase technique · Semaine 2 · Partie 17
Objectif de l’étape
Depuis la partie 14, le gradient boosting gagne tous les tableaux, et en partie 16 on a dû fabriquer à la main une feature « bosse » pour que la régression logistique voie ce que le boosting voyait tout seul. Il est temps d’ouvrir la boîte.
À la fin de cet article, tu sauras :
- expliquer comment un arbre de décision choisit une coupure (impureté de Gini, entropie) et pourquoi sa profondeur règle le surapprentissage ;
- expliquer bagging contre boosting : moyenner pour réduire la variance, ou additionner pour réduire le biais ;
- lire le gradient boosting comme une descente de gradient dans l’espace des fonctions ;
- régler les hyperparamètres principaux de LightGBM (
num_leaves,n_estimators,learning_rate) ; - mesurer la taille et la latence d’un modèle, et choisir le plus petit qui fait le travail.
Notions clés
1. Un arbre de décision est une suite de questions
Intuition. Un arbre pose la question « phase ≤ 0,001 ? », puis, selon la réponse, une autre question, et ainsi de suite. Chaque feuille contient une prédiction : la part de régions chaudes parmi les exemples d’entraînement qui y sont arrivés.
Pour choisir une question, l’arbre essaie toutes les features et tous les seuils, et garde celle qui rend les deux enfants les plus « purs » possible. Pour un nœud qui contient une fraction de positifs, l’impureté de Gini vaut :
Elle vaut 0 pour un nœud pur, et elle est maximale (0,5) en . Le gain d’une coupure est la baisse d’impureté, pondérée par la taille de chaque enfant :
L’entropie de Required Maths M8 joue le même rôle (le gain s’appelle alors gain d’information) ; en pratique, les deux choisissent presque les mêmes coupures.
Trois propriétés en découlent directement :
- un arbre est invariant aux transformations monotones d’une feature :
depuis_dernieroulog(depuis_dernier)donnent les mêmes coupures, donc pas besoin deStandardScaler; - il fabrique des effets non monotones en empilant deux seuils sur la même feature : exactement ce que le modèle linéaire ne savait pas faire ;
- il est glouton : chaque coupure est la meilleure maintenant, sans regarder plus loin.
2. La profondeur, c’est la capacité
Intuition. Chaque niveau de plus double le nombre de feuilles. Avec assez de feuilles, l’arbre peut isoler chaque exemple d’entraînement : il apprend par cœur.
Un arbre de profondeur
a au plus
feuilles. Un arbre peu profond a un biais fort (il ne peut pas exprimer la vraie règle), un arbre très profond a une variance forte (il change complètement si on retire les données). La profondeur, le nombre minimal d’exemples par feuille (min_samples_leaf) ou le nombre de feuilles sont les boutons du compromis biais–variance de la partie 13.
3. Bagging et forêts aléatoires : moyenner pour réduire la variance
Intuition. Un arbre profond est instable mais peu biaisé. On en entraîne plusieurs sur des données légèrement différentes et on fait la moyenne : les erreurs se compensent en partie.
Le bagging (bootstrap aggregating) entraîne arbres sur des échantillons bootstrap (tirages avec remise) et moyenne leurs prédictions. Si chaque arbre a une variance et que deux arbres ont une corrélation , la variance de la moyenne vaut (Required Maths M7) :
Le second terme disparaît quand
grandit ; le premier reste. Pour baisser
, la forêt aléatoire ne laisse chaque coupure choisir que parmi un sous-ensemble aléatoire de features (max_features="sqrt") : les arbres se ressemblent moins, donc leur moyenne est meilleure.
4. Le boosting : additionner pour réduire le biais
Intuition. Au lieu d’arbres indépendants qu’on moyenne, on construit de petits arbres l’un après l’autre, chacun corrigeant ce que les précédents ont raté.
Le modèle est une somme , où est un score (une log-cote, comme en partie 16) et le taux d’apprentissage. À chaque étape, on calcule le gradient de la log-loss par rapport au score de chaque exemple, et on ajuste un petit arbre de régression sur moins ce gradient :
C’est exactement la descente de gradient de Required Maths M10, sauf qu’on ne déplace pas des paramètres : on déplace la fonction elle-même, un pas = un arbre. M10 l’a codé à la main sur le fil rouge ; ici, on s’en sert pour comprendre les hyperparamètres :
n_estimators= nombre de pas,learning_rate= taille du pas : diviser l’un par deux demande à peu près de doubler l’autre ;- chaque arbre est petit (quelques feuilles) : le boosting part d’un modèle très biaisé et réduit le biais pas à pas. Trop de pas, et il surapprend, d’où l’arrêt précoce (early stopping) sur la validation.
5. LightGBM : la même idée, en rapide
Intuition. Essayer tous les seuils sur 123 840 exemples à chaque nœud coûte cher. LightGBM regroupe d’abord les valeurs de chaque feature en 255 cases au plus (histogrammes), puis n’essaie que les frontières de cases.
Deux choix le distinguent :
- la croissance par feuille (leaf-wise) : au lieu de remplir un arbre niveau par niveau, il coupe toujours la feuille qui fait le plus baisser la perte. La taille se règle par
num_leaves(nombre de feuilles par arbre), pas par la profondeur ; - les hyperparamètres principaux :
num_leaves(complexité de chaque arbre),n_estimatorsetlearning_rate(nombre et taille des pas),min_child_samples(exemples minimum par feuille),max_depth(garde-fou, illimité par défaut).
Le HistGradientBoostingClassifier utilisé depuis la partie 14 est la réimplémentation de ces idées dans scikit-learn (31 feuilles, taux d’apprentissage 0,1, 200 itérations dans nos réglages).
6. Taille et latence d’un ensemble d’arbres
Intuition. Pour prédire, chaque arbre descend de la racine à une feuille : une comparaison par niveau. Le coût est proportionnel au nombre d’arbres fois leur profondeur, pas au nombre d’exemples d’entraînement.
Un arbre à feuilles a nœuds internes, soit nœuds en tout. Un ensemble de arbres stocke donc environ nœuds. C’est ce nombre qu’on compare aux 12 poids de la régression logistique de la partie 16, et c’est lui qui décidera si le modèle tient dans un démon système.
Exemple de code
Comme en parties 15 et 16, on reprend tel quel le script de la partie 14 (simulation, features, labels), puis on ajoute les sept blocs ci-dessous à la suite, dans le même fichier. Même découpage : train , validation , test . L’ensemble tourne en une trentaine de secondes (numpy 2.5, pandas 3.0, scikit-learn 1.9, lightgbm 4.7).
Comment un arbre choisit sa première coupure
# Suite du script de la partie 14 : df, FEATURES, H, np, pd et roc_auc_score sont déjà définis.
import time
import lightgbm as lgb
from sklearn.tree import DecisionTreeClassifier, DecisionTreeRegressor
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import log_loss

# Les trois mêmes périodes qu'en parties 15 et 16
t_val, t_test = 1400, 1800
train = df[df.t < t_val - H]
val = df[(df.t >= t_val) & (df.t < t_test - H)]
test = df[df.t >= t_test]


# 1. Comment un arbre choisit une coupure : l'impureté de Gini, à la main
def gini(p):
    return 2 * p * (1 - p)        # impureté d'un nœud qui contient une fraction p de positifs


def meilleure_coupure(x, y):
    """Meilleur seuil sur une feature : plus forte baisse pondérée de l'impureté de Gini."""
    ordre = np.argsort(x, kind="stable")
    x, y = x[ordre], y[ordre]
    n = len(y)
    n_gauche = np.arange(1, n)                 # coupure après la position i
    pos_gauche = np.cumsum(y)[:-1]
    n_droite, pos_droite = n - n_gauche, y.sum() - pos_gauche
    impurete = (n_gauche * gini(pos_gauche / n_gauche) + n_droite * gini(pos_droite / n_droite)) / n
    valide = x[1:] != x[:-1]                   # on ne coupe qu'entre deux valeurs différentes
    i = np.argmin(np.where(valide, impurete, np.inf))
    return (x[i] + x[i + 1]) / 2, gini(y.mean()) - impurete[i]


y_tr = train.y.to_numpy()
print(f"impureté de la racine : {gini(y_tr.mean()):.4f}")
for f in FEATURES:
    s, gain = meilleure_coupure(train[f].to_numpy(), y_tr)
    print(f"{f:>17} | seuil {s:8.3f} | baisse de Gini {gain:.4f}")
souche = DecisionTreeClassifier(max_depth=1, random_state=0).fit(train[FEATURES], train.y)
print("racine scikit-learn :", FEATURES[souche.tree_.feature[0]], round(souche.tree_.threshold[0], 3))
L’impureté de la racine vaut .
| Feature | Meilleur seuil | Baisse de Gini |
|---|---|---|
acces_t |
0,5 | 0,1027 |
depuis_dernier |
0,5 | 0,1027 |
phase |
0,001 | 0,1027 |
frac_active_20 |
0,475 | 0,0813 |
moy_5 |
0,3 | 0,0664 |
moy_100 |
0,625 | 0,0533 |
moy_20 |
2,225 | 0,0461 |
voisins_moy_5 |
0,15 | 0,0275 |
periode_estimee |
36,5 | 0,0243 |
- Trois features sont exactement à égalité, et ce n’est pas un hasard :
acces_t ≤ 0,5,depuis_dernier ≤ 0,5etphase ≤ 0,001posent toutes la même question, « la région a-t-elle été accédée en ? ». La première question que pose un arbre, c’est celle de LRU. - scikit-learn départage les égalités par un ordre aléatoire des features : avec
random_state=0, il choisitphaseà 0,001. Notre fonction de 15 lignes trouve le même seuil et le même gain.
La bosse, trouvée toute seule
# 2. La bosse que le modèle linéaire ne voyait pas, trouvée par un arbre sur la seule phase
grille = pd.DataFrame({"phase": [0.0, 0.25, 0.5, 0.75, 0.9, 1.0, 1.5, 3.0]})
lin = LogisticRegression().fit(train[["phase"]], train.y)
arbre3 = DecisionTreeClassifier(max_depth=3, random_state=0).fit(train[["phase"]], train.y)
bosse = lambda d: pd.DataFrame({"phase": d.phase, "proche_cycle": np.exp(-((d.phase - 1) / 0.2) ** 2)})
lin_bosse = LogisticRegression().fit(bosse(train), train.y)     # la bosse faite main de la partie 16
print(f"phase seule | logistique AUC val {roc_auc_score(val.y, lin.predict_proba(val[['phase']])[:, 1]):.3f}"
      f" | logistique + proche_cycle {roc_auc_score(val.y, lin_bosse.predict_proba(bosse(val))[:, 1]):.3f}"
      f" | arbre de profondeur 3 {roc_auc_score(val.y, arbre3.predict_proba(val[['phase']])[:, 1]):.3f}")
print(pd.DataFrame({"phase": grille.phase,
                    "p logistique": lin.predict_proba(grille)[:, 1].round(3),
                    "p arbre": arbre3.predict_proba(grille)[:, 1].round(3)}).to_string(index=False))
phase |
logistique | arbre de profondeur 3 |
|---|---|---|
| 0 | 0,374 | 0,876 |
| 0,25 | 0,354 | 0,111 |
| 0,5 | 0,334 | 0,456 |
| 0,75 | 0,314 | 0,456 |
| 0,9 | 0,303 | 0,456 |
| 1,0 | 0,295 | 0,141 |
| 1,5 | 0,260 | 0,141 |
| 3,0 | 0,171 | 0,141 |
Avec la seule phase, l’AUC de validation passe de 0,670 (logistique) à 0,713 (logistique + la bosse proche_cycle de la partie 16) et à 0,803 (un arbre de profondeur 3, soit 4 seuils).
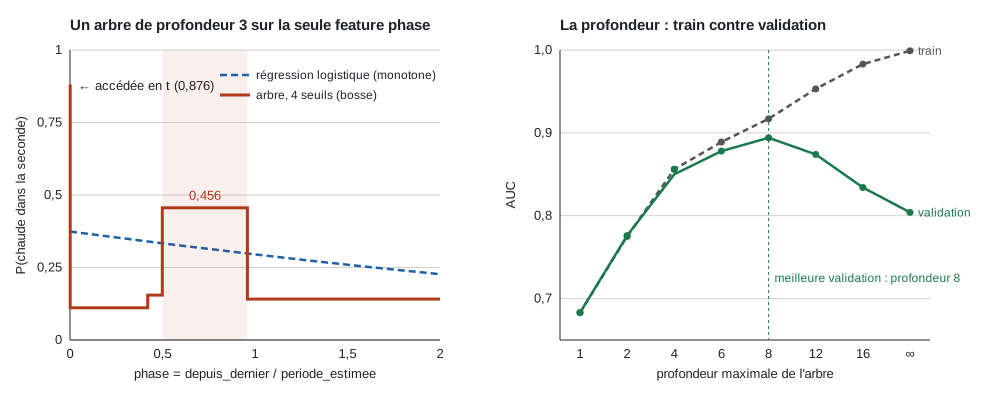
- L’arbre utilise ses seuils (0,001, 0,42, 0,499, 0,959) pour dessiner une fonction en escalier : très chaude si accédée en , froide juste après, une bosse à 0,456 entre 0,5 et 0,96, puis de nouveau froide.
- La bosse n’est pas là où on l’avait mise à la main. En partie 16,
proche_cycleétait centrée sur 1. Or le label regarde 10 agrégations en avant : la prochaine rafale entre dans la fenêtre dès quephasedépasse environ , soit entre 0,33 et 0,83 pour des périodes de 15 à 60. Au-delà de 1, le cycle attendu n’est pas revenu : la région a probablement quitté son régime périodique. L’arbre lit ça dans les données ; nous, on l’avait deviné, et un peu de travers.
Profondeur et surapprentissage
# 3. Profondeur = capacité : un arbre trop profond apprend par cœur
for prof in [1, 2, 4, 6, 8, 12, 16, None]:
    a = DecisionTreeClassifier(max_depth=prof, random_state=0).fit(train[FEATURES], train.y)
    auc_tr = roc_auc_score(train.y, a.predict_proba(train[FEATURES])[:, 1])
    auc_va = roc_auc_score(val.y, a.predict_proba(val[FEATURES])[:, 1])
    print(f"profondeur {str(prof):>4} | {a.get_n_leaves():5d} feuilles | AUC train {auc_tr:.3f} | AUC val {auc_va:.3f}")
| Profondeur max | Feuilles | AUC train | AUC val |
|---|---|---|---|
| 1 | 2 | 0,683 | 0,683 |
| 2 | 4 | 0,775 | 0,776 |
| 4 | 16 | 0,856 | 0,850 |
| 6 | 58 | 0,889 | 0,878 |
| 8 | 186 | 0,917 | 0,894 |
| 12 | 1 013 | 0,953 | 0,874 |
| 16 | 2 658 | 0,983 | 0,834 |
| illimitée | 6 703 | 0,999 | 0,804 |
L’image du cours : jusqu’à la profondeur 6, train et validation montent ensemble (le biais baisse) ; au-delà de 8, le train continue vers 1 pendant que la validation chute (la variance monte). L’arbre illimité connaît le train par cœur (0,999) et fait à peine mieux que la régression logistique en validation (0,804 contre 0,808).
Bagging : cinq arbres instables, une moyenne stable
# 4. Bagging : moyenner des arbres instables réduit la variance
preds = []
for graine in range(5):
    boot = train.sample(frac=1.0, replace=True, random_state=graine)    # échantillon bootstrap
    a = DecisionTreeClassifier(max_features="sqrt", random_state=graine).fit(boot[FEATURES], boot.y)
    preds.append(a.predict_proba(val[FEATURES])[:, 1])
    print(f"arbre profond {graine} | AUC val {roc_auc_score(val.y, preds[-1]):.3f}")
P = np.array(preds)
print(f"moyenne des 5 arbres | AUC val {roc_auc_score(val.y, P.mean(axis=0)):.3f} | "
      f"corrélation moyenne entre arbres {np.corrcoef(P)[np.triu_indices(5, 1)].mean():.2f}")
for n_arbres in [1, 10, 100]:
    rf = RandomForestClassifier(n_estimators=n_arbres, n_jobs=-1, random_state=0).fit(train[FEATURES], train.y)
    print(f"forêt aléatoire, {n_arbres:3d} arbres | AUC val {roc_auc_score(val.y, rf.predict_proba(val[FEATURES])[:, 1]):.3f}")
- Cinq arbres profonds, entraînés chacun sur un échantillon bootstrap (avec
max_features="sqrt", comme dans une forêt aléatoire, pour décorréler les arbres), ont une AUC de validation entre 0,810 et 0,820. Leur moyenne atteint 0,876 : 6 points de gagnés sans aucune information nouvelle, seulement en moyennant. - Les prédictions de deux arbres ont une corrélation de 0,70 : c’est le de la formule, la part de variance que la moyenne n’enlève pas.
- La forêt aléatoire passe de 0,802 (1 arbre) à 0,887 (10 arbres) et 0,899 (100 arbres). Au-delà, elle ne gagne presque plus rien : on a atteint le plancher .
Le boosting à la main
# 5. Boosting = descente de gradient dans l'espace des fonctions (M10), en 10 lignes
X_tr, X_va = train[FEATURES].to_numpy(), val[FEATURES].to_numpy()
F_tr = np.full(len(y_tr), np.log(y_tr.mean() / (1 - y_tr.mean())))   # départ constant : le taux de base
F_va = np.full(len(X_va), F_tr[0])
for k in range(1, 51):
    residu = y_tr - 1 / (1 + np.exp(-F_tr))           # moins le gradient de la log-loss par rapport au score
    pas = DecisionTreeRegressor(max_depth=3).fit(X_tr, residu)
    F_tr += 0.3 * pas.predict(X_tr)                    # taux d'apprentissage 0,3
    F_va += 0.3 * pas.predict(X_va)
    if k in (1, 5, 20, 50):
        print(f"{k:2d} arbres | log-loss train {log_loss(y_tr, 1 / (1 + np.exp(-F_tr))):.4f} | "
              f"AUC val {roc_auc_score(val.y, F_va):.3f}")
| Arbres | Log-loss train | AUC val |
|---|---|---|
| 1 | 0,5921 | 0,822 |
| 5 | 0,5274 | 0,826 |
| 20 | 0,4289 | 0,860 |
| 50 | 0,3768 | 0,865 |
Chaque arbre n’a que 8 feuilles (profondeur 3) et serait faible tout seul. Leur somme fait descendre la log-loss régulièrement : c’est une descente, un arbre par pas. La ligne residu = y_tr - p contient toute l’idée : le gradient de la log-loss par rapport au score vaut
(partie 16), donc l’arbre suivant apprend ce qui manque encore.
LightGBM : combien d’arbres, combien de feuilles ?
# 6. LightGBM : taille, latence et coût, pour plusieurs budgets
C_FAUX_FROID, C_FAUX_CHAUD = 10, 1


def cout_moyen(y, p, seuil):
    pred = p >= seuil
    return (C_FAUX_FROID * np.sum((y == 1) & ~pred) + C_FAUX_CHAUD * np.sum((y == 0) & pred)) / len(y)


seuils = np.linspace(0.01, 0.99, 99)
y_va, y_te = val.y.to_numpy(), test.y.to_numpy()
X96 = test[test.t == t_test][FEATURES].to_numpy()      # les 96 régions à une agrégation
print(f"ne jamais compresser | coût val {cout_moyen(y_va, np.ones(len(y_va)), 0.5):.3f} | "
      f"coût test {cout_moyen(y_te, np.ones(len(y_te)), 0.5):.3f}")
lignes = []
for feuilles in [4, 8, 16, 31, 63]:
    for n_arbres in [10, 50, 200]:
        m = lgb.LGBMClassifier(num_leaves=feuilles, n_estimators=n_arbres, learning_rate=0.05,
                               random_state=0, verbose=-1).fit(train[FEATURES], train.y)
        pv, pt = m.predict_proba(val[FEATURES])[:, 1], m.predict_proba(test[FEATURES])[:, 1]
        s = seuils[int(np.argmin([cout_moyen(y_va, pv, s) for s in seuils]))]
        noeuds = sum(2 * arbre["num_leaves"] - 1 for arbre in m.booster_.dump_model()["tree_info"])
        t0 = time.perf_counter()
        for _ in range(200):
            m.booster_.predict(X96)
        latence = (time.perf_counter() - t0) / 200 * 1e6
        lignes.append(dict(feuilles=feuilles, arbres=n_arbres, noeuds=noeuds, auc_val=roc_auc_score(y_va, pv),
                           seuil=s, cout_val=cout_moyen(y_va, pv, s),
                           cout_test=cout_moyen(y_te, pt, s), latence_us=latence, modele=m))
grille_res = pd.DataFrame(lignes)
print(grille_res.drop(columns="modele").round(3).to_string(index=False))
Référence : ne jamais compresser coûte 0,699 en validation et 0,689 en test.
| Feuilles | Arbres | Nœuds | AUC val | Seuil | Coût val | Coût test |
|---|---|---|---|---|---|---|
| 4 | 10 | 70 | 0,839 | 0,01 | 0,699 | 0,689 |
| 4 | 50 | 350 | 0,857 | 0,20 | 0,683 | 0,826 |
| 4 | 200 | 1 400 | 0,877 | 0,09 | 0,652 | 0,690 |
| 8 | 10 | 150 | 0,865 | 0,22 | 0,680 | 0,738 |
| 8 | 50 | 750 | 0,891 | 0,12 | 0,601 | 0,682 |
| 8 | 200 | 3 000 | 0,903 | 0,09 | 0,584 | 0,662 |
| 16 | 10 | 310 | 0,893 | 0,22 | 0,595 | 0,669 |
| 16 | 50 | 1 550 | 0,909 | 0,11 | 0,558 | 0,648 |
| 16 | 200 | 6 200 | 0,909 | 0,10 | 0,555 | 0,657 |
| 31 | 10 | 610 | 0,907 | 0,21 | 0,557 | 0,637 |
| 31 | 50 | 3 050 | 0,915 | 0,12 | 0,541 | 0,672 |
| 31 | 200 | 12 200 | 0,910 | 0,08 | 0,538 | 0,638 |
| 63 | 10 | 1 250 | 0,912 | 0,22 | 0,540 | 0,666 |
| 63 | 50 | 6 250 | 0,919 | 0,13 | 0,526 | 0,690 |
| 63 | 200 | 25 000 | 0,913 | 0,08 | 0,530 | 0,649 |
- La validation sature vite. Dès 610 nœuds (31 feuilles × 10 arbres), l’AUC vaut 0,907 ; 40 fois plus de nœuds (25 000) donnent 0,913. Le meilleur coût de validation (0,526) est atteint avec 6 250 nœuds.
- Avec un taux d’apprentissage de 0,05, 10 arbres ne font que quelques pas : les scores restent proches du taux de base, ce qui explique que le seuil retenu soit vers 0,22 plutôt que 0,1. Ce n’est pas un problème pour décider : seuls l’ordre et le seuil comptent.
- Le coût test saute : de 0,637 à 0,826 pour des modèles proches en validation. Avec 96 régions et un changement de régime, un seuil choisi en validation peut mal tomber sur le test (4 feuilles × 50 arbres). On mesure ce bruit plus bas plutôt que de lire le tableau comme un classement.
- Latence. Pour les 96 régions d’une agrégation,
booster_.predictprend environ 30 à 65 µs avec 10 arbres, 50 à 130 µs avec 50 arbres et 170 à 660 µs avec 200 arbres sur ma machine (fourchettes relevées sur plusieurs exécutions : la latence varie d’une exécution à l’autre, l’ordre de grandeur reste). À comparer aux 2 µs de la régression logistique de la partie 16 : le coût fixe de l’appel domine pour les petits modèles, puis chaque arbre ajoute sa part.
Hypothèse H2 : un petit boosting suffit-il ?
# 7. Hypothèse H2 : un petit modèle suffit-il ?
# Règle fixée à l'avance : le plus petit modèle qui garde 90 % du meilleur gain sur « ne jamais compresser » (validation)
jamais_val = cout_moyen(y_va, np.ones(len(y_va)), 0.5)
gain = jamais_val - grille_res.cout_val
petit = grille_res[gain >= 0.9 * gain.max()].sort_values("noeuds").iloc[0]
print(f"meilleur gain en val {gain.max():.3f} | retenu : {petit.feuilles} feuilles x {petit.arbres} arbres = "
      f"{petit.noeuds} nœuds | coût val {petit.cout_val:.3f} | coût test {petit.cout_test:.3f}")

# Fait-il vraiment mieux que « ne jamais compresser » sur le test ? Bootstrap sur les régions
pt = petit.modele.predict_proba(test[FEATURES])[:, 1]
compresse = pt < petit.seuil
par_region = pd.DataFrame({
    "region": test.region.to_numpy(),
    "modele": np.where(compresse, C_FAUX_FROID * y_te, C_FAUX_CHAUD * (1 - y_te)),
    "jamais": C_FAUX_CHAUD * (1 - y_te),
}).groupby("region").sum()
rng_b = np.random.default_rng(0)
n_lignes = len(test) / 96                               # lignes par région dans le test
ecarts = []
for _ in range(2000):
    idx = rng_b.integers(0, 96, 96)
    tirage = par_region.iloc[idx]
    ecarts.append((tirage.modele.sum() - tirage.jamais.sum()) / (96 * n_lignes))
bas, haut = np.percentile(ecarts, [2.5, 97.5])
print(f"modèle - ne jamais compresser, test : {petit.cout_test - cout_moyen(y_te, np.ones(len(y_te)), 0.5):+.3f} "
      f"| intervalle à 95 % [{bas:+.3f} ; {haut:+.3f}] | compressées {compresse.mean():.3f}")
- La règle, fixée avant de regarder le test : le plus petit modèle qui garde 90 % du meilleur gain sur « ne jamais compresser » en validation. Le meilleur gain vaut 0,174 (0,699 → 0,526) ; le modèle retenu est 63 feuilles × 10 arbres = 1 250 nœuds, avec un coût de validation de 0,540, soit 5 fois moins de nœuds que le meilleur.
- Sur le test, il coûte 0,666 contre 0,689 pour « ne jamais compresser » : un écart de −0,022, avec un intervalle à 95 % de [−0,070 ; +0,023] par bootstrap sur les régions. Il compresse 20,2 % des régions.
- Conclusion honnête : en validation, un petit boosting garde presque tout le gain d’un gros. Sur le test qui contient le changement de régime, aucune différence n’est significative, ni entre modèles, ni face à « ne jamais compresser ». C’est le même diagnostic qu’en partie 16 : le problème difficile n’est pas la capacité du modèle, c’est le changement de régime.
Fil rouge : ce que ça change pour le mémoire
- H2, première réponse. La taille du modèle n’est pas le goulot : 1 250 nœuds (10 arbres) font aussi bien en validation que 25 000. Dans le mémoire, présente toute la courbe taille–performance (le tableau ci-dessus), pas un seul point.
- Taille et latence se mesurent, elles ne se devinent pas. Nœuds , taille en octets, latence par agrégation. Ces trois nombres entrent dans le tableau comparatif, à côté de la régression logistique (12 poids, 2 µs) et, plus tard, du LSTM.
- Importance des arbres et périodicité. L’arbre a trouvé tout seul la zone dangereuse de la phase (0,5 à 0,96). C’est un argument direct pour ton hypothèse H1 : le signal de périodicité existe, mais il est non monotone, ce qui favorise les arbres et les modèles de séquence face aux modèles linéaires.
- Protocole. Chaque hyperparamètre (nombre de feuilles, d’arbres, seuil) se choisit en validation, avec une règle écrite à l’avance. Le test ne sert qu’une fois, avec un intervalle de confiance. La partie 18 remplacera cette période de validation unique par une validation par workload.
Exercice pratique
- Le plus petit modèle qui garde 95 %. Affine la grille :
num_leavesdans {32, 40, 48, 56, 63} etn_estimatorsdans {10, 20, 30, 40, 50}. Quel est le plus petit modèle (en nœuds) qui garde 95 % du meilleur gain de validation sur « ne jamais compresser » dans cette grille ? Combien de fois est-il plus gros que celui retenu à 90 % ? - Forêt contrainte. Entraîne une
RandomForestClassifier(n_estimators=200, min_samples_leaf=100, n_jobs=-1, random_state=0). Compare son AUC de validation, son AUC de test et son nombre total de nœuds (sum(e.tree_.node_count for e in rf.estimators_)) avec le LightGBM retenu. Lequel mettrais-tu dans un démon ? - Arrêt précoce. Entraîne LightGBM avec
num_leaves=31,n_estimators=2000,learning_rate=0.05, en passanteval_set=[(val[FEATURES], val.y)]etcallbacks=[lgb.early_stopping(50, verbose=False)]. À quelle itération s’arrête-t-il ? Pourquoi utiliser la validation pour l’arrêt et pour le seuil la rend-elle un peu optimiste ? - Importance. Affiche l’importance par gain du modèle retenu (
m.booster_.feature_importance("gain"), normalisée). Compare l’ordre avec le chemin de la partie 16, oùphaseentrait en dernier. Explique la différence. - Fil rouge. Combien d’octets prend le modèle retenu en C, avec un indice de feature sur 1 octet, un seuil
floatsur 4 octets et deux indices d’enfants sur 2 octets par nœud interne, et unfloatde 4 octets par feuille ? Compare aux 12 poids de la régression logistique.
Indices. Question 1 : 63 feuilles × 30 arbres, 3 750 nœuds, trois fois le modèle à 90 %. Question 2 : AUC val 0,914, AUC test 0,870, 181 144 nœuds (145 fois plus). Question 3 : meilleure itération 122, AUC val 0,912. Question 4 : acces_t 38 %, phase 27 %, periode_estimee 16 %, moy_100 12 % ; un modèle linéaire ne peut pas exploiter la phase, car son effet n’est pas monotone. Question 5 : 620 nœuds internes et 630 feuilles, soit 620 × 9 + 630 × 4 = 8 100 octets, contre 52 octets pour la régression logistique (12 poids + biais).
Ressources pour aller plus loin
- Breiman, Random Forests (Machine Learning, 2001).
- Friedman, Greedy Function Approximation: A Gradient Boosting Machine (Annals of Statistics, 2001) : le boosting comme descente de gradient.
- Ke et al., LightGBM: A Highly Efficient Gradient Boosting Decision Tree (NeurIPS 2017), et la documentation LightGBM, page Parameters Tuning.
- James, Witten, Hastie, Tibshirani, An Introduction to Statistical Learning (ISLR), chapitre 8 (méthodes à base d’arbres).
- Rappel : M10 · Descente de gradient et ses variantes, où on a codé le gradient boosting à la main.
Ce que tu dois savoir faire avant de passer à la suite
- Calculer à la main l’impureté de Gini et le gain d’une coupure
- Expliquer pourquoi un arbre n’a pas besoin de normalisation et peut représenter un effet non monotone
- Expliquer bagging contre boosting, avec la variance d’une moyenne d’arbres corrélés
- Écrire une étape de boosting : résidu = moins le gradient, un petit arbre, un taux d’apprentissage
- Régler
num_leaves,n_estimatorsetlearning_ratede LightGBM, et utiliser l’arrêt précoce - Mesurer la taille (nœuds, octets) et la latence d’un modèle, et choisir le plus petit avec une règle fixée à l’avance
- Appuyer une comparaison sur le test par un intervalle de confiance sur les régions
Partie suivante : Validation et tuning sérieux (partie 18). Une seule période de validation est fragile, les coûts de test ci-dessus le montrent : on passera à la validation croisée temporelle avec purge, au leave-one-workload-out et à la recherche d’hyperparamètres avec Optuna.