Préparer les données sans fuite
Split temporel, purge et features sur fenêtres glissantes : préparer des données qui ne mentent pas sur la performance.
Mastering AI · Phase technique · Semaine 1 · Partie 14
Objectif de l’étape
Dans la partie 13, on a découpé les données au hasard, et c’était légitime : les points étaient indépendants. Sur des traces temporelles, ce même geste fabrique des scores trop beaux pour être vrais.
À la fin de cet article, tu sauras :
- générer un premier jeu de traces mémoire simulées, avec features et labels ;
- reconnaître les trois grandes familles de fuites de données ;
- découper des données temporelles correctement : split temporel avec purge ;
- mesurer, chiffres à l’appui, de combien une fuite gonfle un score.
Notions clés
1. Train, validation, test : trois rôles différents
Intuition. Le test est un examen surprise. Si l’élève a vu les questions, même indirectement, la note ne veut plus rien dire.
| Ensemble | Sert à | Règle |
|---|---|---|
| Train | ajuster les paramètres | le modèle le voit autant qu’il veut |
| Validation | choisir les hyperparamètres, les features, le modèle | on le regarde souvent, il finit donc légèrement « appris » |
| Test | estimer la performance finale | on le regarde une seule fois, à la fin |
L’estimation du risque réel de la partie 13 n’est valable que si aucune information du test n’a influencé le modèle. C’est cette condition que les fuites violent.
2. Les trois familles de fuites
Intuition. Une fuite, c’est quand le modèle reçoit pendant l’entraînement une information qu’il n’aura jamais en production.
- Fuite par le futur. Une feature calculée avec des valeurs postérieures à l’instant de prédiction. Exemple typique : une moyenne glissante centrée (qui regarde 5 pas avant et 5 pas après).
- Fuite par le découpage. Des exemples quasi identiques se retrouvent des deux côtés du split. Sur une série temporelle, l’instant et l’instant d’une même région se ressemblent énormément. Si l’un est en train et l’autre en test, le modèle « reconnaît » la réponse au lieu de la prédire.
- Fuite par le prétraitement. On normalise, on impute ou on sélectionne des features sur toutes les données avant de découper. Les statistiques du test entrent alors dans le train. L’effet est souvent faible, mais réel, et il devient fort avec la sélection de features.
La règle qui couvre les trois : tout ce qui apprend quelque chose des données (modèle, scaler, imputeur, sélecteur) s’ajuste uniquement sur le train. En pratique, on enferme ces étapes dans un Pipeline scikit-learn, qui garantit que fit ne voit que le train.
3. Le split temporel, et pourquoi il faut une purge
Intuition. En production, on entraîne sur le passé et on prédit le futur. L’évaluation doit reproduire exactement cette situation.
On coupe à un instant : tout ce qui est avant sert à l’entraînement, tout ce qui est après sert au test.
Subtilité : notre label regarde le futur. si la région est accédée entre et . Un exemple d’entraînement juste avant a donc un label qui dépend de ce qui se passe après , c’est-à-dire dans la période de test. On retire ces exemples : c’est la purge.
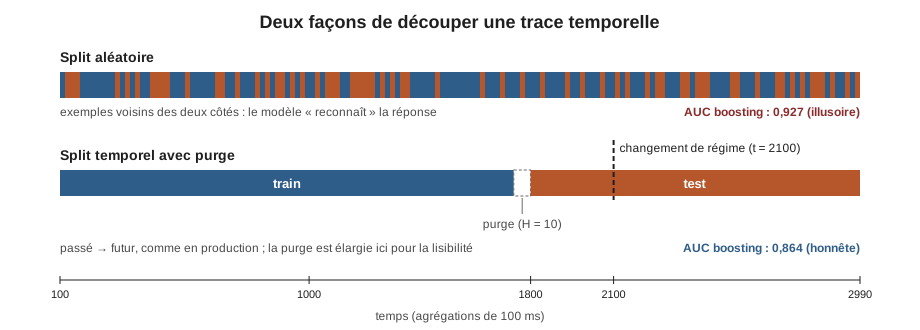
Les deux AUC de la figure sont celles qu’on obtient plus bas dans l’exemple de code.
4. Features sur fenêtres glissantes
Intuition. Pour décider si une région va être relue, on résume son passé récent en quelques nombres : combien d’accès, depuis quand, à quel rythme.
Pour une région, à chaque agrégation , en n’utilisant que :
| Feature | Ce qu’elle capture |
|---|---|
moy_5, moy_20, moy_100 |
intensité d’accès à plusieurs échelles de temps |
frac_active_20 |
régularité : part des 20 dernières agrégations avec au moins un accès |
depuis_dernier |
récence : c’est l’information qu’utilise LRU |
periode_estimee |
écart entre les deux derniers débuts d’activité |
phase |
depuis_dernier / periode_estimee : où en est-on dans le cycle ? |
voisins_moy_5 |
activité des régions adjacentes (localité) |
periode_estimee et phase sont une version simple de la « périodicité » de ton hypothèse H1. La version rigoureuse passe par l’autocorrélation → Required Maths M7 : variance, covariance.
Exemple de code
Le script complet fait quatre choses : simuler les traces, construire le dataset, comparer split aléatoire et split temporel, puis montrer deux fuites classiques. Les quatre blocs ci-dessous s’enchaînent dans un même fichier ; l’ensemble tourne en une dizaine de secondes (numpy 2.5, pandas 3.0, scikit-learn 1.9).
Simulation des traces
On simule 96 régions sur 3 000 agrégations de 100 ms, soit 5 minutes. Les régions vont par blocs de 4 voisines de même nature, pour imiter la localité mémoire. Il y a quatre comportements :
- périodique : quelques agrégations actives toutes les 15 à 60 (penser aux cycles du GC JVM) ;
- chaude : accédée presque tout le temps ;
- froide : quasiment jamais accédée ;
- rafale : périodes on/off aléatoires.
À 70 % de la trace, 40 % des blocs environ tirent un nouveau comportement (qui peut retomber sur l’ancien). C’est un changement de régime du workload, comme en vrai.
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score

rng = np.random.default_rng(7)

T = 3000          # nombre d'agrégations (100 ms chacune -> 5 minutes)
N_REGIONS = 96    # régions mémoire
TAILLE_BLOC = 4   # régions voisines de même nature (localité)
H = 10            # horizon : 10 agrégations = 1 s
T_CHANGEMENT = int(0.7 * T)  # changement de régime du workload

TYPES = ["periodique", "chaude", "froide", "rafale"]


def simuler_segment(type_, longueur, rng):
    """Nombre d'accès par agrégation pour une région d'un type donné."""
    t = np.arange(longueur)
    if type_ == "periodique":
        periode = rng.integers(15, 60)
        duree = rng.integers(2, 5)
        phase = rng.integers(0, periode)
        actif = ((t + phase) % periode) < duree
        return actif * rng.poisson(6, longueur)
    if type_ == "chaude":
        return rng.poisson(rng.uniform(1.0, 4.0), longueur)
    if type_ == "froide":
        return rng.poisson(0.01, longueur)
    # rafale : alternance on/off aléatoire (chaîne de Markov)
    acces = np.zeros(longueur, dtype=int)
    on = False
    for i in range(longueur):
        if not on and rng.random() < 0.02:
            on = True
        elif on and rng.random() < 0.15:
            on = False
        acces[i] = rng.poisson(5) if on else 0
    return acces


def simuler_traces(rng):
    """Matrice (régions x temps) ; certaines régions changent de nature à T_CHANGEMENT."""
    acces = np.zeros((N_REGIONS, T), dtype=int)
    for bloc in range(N_REGIONS // TAILLE_BLOC):
        avant = rng.choice(TYPES, p=[0.35, 0.2, 0.25, 0.2])
        apres = rng.choice(TYPES) if rng.random() < 0.4 else avant
        for r in range(bloc * TAILLE_BLOC, (bloc + 1) * TAILLE_BLOC):
            acces[r, :T_CHANGEMENT] = simuler_segment(avant, T_CHANGEMENT, rng)
            acces[r, T_CHANGEMENT:] = simuler_segment(apres, T - T_CHANGEMENT, rng)
    return acces
Features et labels, sans regarder le futur
Toutes les fenêtres rolling de pandas sont causales par défaut : la valeur en
n’utilise que
et le passé. Le label, lui, est volontairement calculé sur le futur, et c’est le seul endroit où le futur a le droit d’apparaître.
def features_region(a):
    """Features d'une région, calculées uniquement avec le passé (t inclus)."""
    s = pd.Series(a, dtype=float)
    actif = (a > 0).astype(float)
    f = pd.DataFrame({
        "acces_t": s,
        "moy_5": s.rolling(5, min_periods=1).mean(),
        "moy_20": s.rolling(20, min_periods=1).mean(),
        "moy_100": s.rolling(100, min_periods=1).mean(),
        "frac_active_20": pd.Series(actif).rolling(20, min_periods=1).mean(),
    })
    # temps depuis le dernier accès, et période estimée entre deux débuts d'activité
    depuis, periode = np.empty(len(a)), np.empty(len(a))
    dernier, debut, debut_prec = -10**6, -10**6, -10**6
    for t in range(len(a)):
        if a[t] > 0:
            if t - dernier > 1:          # début d'une nouvelle activité
                debut_prec, debut = debut, t
            dernier = t
        depuis[t] = min(t - dernier, 500)
        periode[t] = min(debut - debut_prec, 500)
    f["depuis_dernier"] = depuis
    f["periode_estimee"] = periode
    f["phase"] = np.clip(depuis / np.maximum(periode, 1), 0, 5)
    return f


def label_region(a, h=H):
    """y_t = 1 si la région est accédée dans les h agrégations suivantes."""
    actif = (a > 0).astype(int)
    futur = pd.Series(actif[::-1]).rolling(h, min_periods=1).max().to_numpy()[::-1]
    y = np.zeros(len(a), dtype=int)
    y[:-1] = futur[1:]          # fenêtre t+1 .. t+h
    return y


def construire_dataset(acces):
    morceaux = []
    for r in range(N_REGIONS):
        f = features_region(acces[r])
        # activité des voisins immédiats (régions r-1 et r+1) sur les 5 dernières agrégations
        voisins = [v for v in (r - 1, r + 1) if 0 <= v < N_REGIONS]
        f["voisins_moy_5"] = np.mean(
            [pd.Series(acces[v], dtype=float).rolling(5, min_periods=1).mean() for v in voisins],
            axis=0)
        f["region"] = r
        f["t"] = np.arange(T)
        f["y"] = label_region(acces[r])
        morceaux.append(f)
    df = pd.concat(morceaux, ignore_index=True)
    # on retire le démarrage (historique incomplet) et la fin (label incomplet)
    return df[(df.t >= 100) & (df.t < T - H)].reset_index(drop=True)


acces = simuler_traces(rng)
df = construire_dataset(acces)
FEATURES = ["acces_t", "moy_5", "moy_20", "moy_100", "frac_active_20",
            "depuis_dernier", "periode_estimee", "phase", "voisins_moy_5"]
print(df.shape, "taux de positifs :", round(df.y.mean(), 3))
Sortie : (277440, 12) taux de positifs : 0.307. On a donc 277 440 exemples (une ligne par région et par agrégation), dont 30,7 % de positifs.
Split aléatoire contre split temporel
Le scaler de la régression logistique est dans le pipeline : il ne s’ajuste que sur le train. Les deux splits utilisent un test de même taille, pour que la comparaison soit équitable.
# --- Split temporel avec purge ---
t_coupe = int(0.6 * T)
train = df[df.t < t_coupe - H]       # purge : les labels du train ne voient pas le test
test = df[df.t >= t_coupe]

# --- Split aléatoire (la mauvaise idée) ---
train_alea, test_alea = train_test_split(df, test_size=len(test) / len(df), random_state=0)


def evaluer(modele, tr, te, features=FEATURES):
    modele.fit(tr[features], tr.y)
    return roc_auc_score(te.y, modele.predict_proba(te[features])[:, 1])


modeles = {
    "logistique": lambda: make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)),
    "boosting": lambda: HistGradientBoostingClassifier(max_iter=200, random_state=0),
}
for nom, fabrique in modeles.items():
    auc_alea = evaluer(fabrique(), train_alea, test_alea)
    auc_temp = evaluer(fabrique(), train, test)
    print(f"{nom:>10} | AUC split aléatoire : {auc_alea:.3f} | AUC split temporel : {auc_temp:.3f}")
L’AUC est un score entre 0,5 (hasard) et 1 (parfait) ; on la détaillera en partie 15. Résultats obtenus avec la graine 7 :
| Modèle | Split aléatoire | Split temporel |
|---|---|---|
| Régression logistique | 0,799 | 0,793 |
| Gradient boosting | 0,927 | 0,864 |
Deux leçons :
- le modèle simple ne bouge presque pas. Il a trop peu de capacité pour « reconnaître » les exemples voisins, donc la fuite ne lui profite pas ;
- le gradient boosting gagne 6 points d’AUC grâce au split aléatoire. Ce gain est entièrement illusoire. Il vient de deux choses : des exemples consécutifs presque identiques des deux côtés du split, et le changement de régime que le split aléatoire laisse « voir » à l’entraînement.
Plus le modèle est puissant, plus il exploite la fuite. C’est pour ça qu’un mauvais protocole peut faire croire qu’un LSTM écrase LightGBM, ou l’inverse.
Deux fuites flagrantes, pour l’exemple
# --- Fuite flagrante : une feature qui regarde le futur ---
df["moy_centree"] = df.groupby("region").acces_t.transform(
    lambda s: s.rolling(11, center=True, min_periods=1).mean())
train = df[df.t < t_coupe - H]
test = df[df.t >= t_coupe]
auc_fuite = evaluer(modeles["boosting"](), train, test, FEATURES + ["moy_centree"])
print(f"boosting + feature qui voit le futur : AUC = {auc_fuite:.3f}")

# --- Fuite par l'identifiant + temps ---
auc_id = evaluer(modeles["boosting"](), train_alea, test_alea, FEATURES + ["region", "t"])
print(f"boosting + region + t, split aléatoire : AUC = {auc_id:.3f}")
| Fuite | AUC |
|---|---|
| Aucune (référence, split temporel) | 0,864 |
| Moyenne glissante centrée | 0,936 |
region + t comme features, split aléatoire |
0,951 |
center=True: un seul paramètre suffit pour que la feature voie 5 agrégations dans le futur, qui recouvrent précisément la fenêtre du label.region+t: avec le split aléatoire, le modèle apprend « la région 42 vers est chaude » et retrouve la réponse par interpolation. Ces deux colonnes n’ont aucun sens en production : la région 42 d’un autre processus n’a rien à voir.
Fil rouge : ce que ça change pour le mémoire
- Protocole. Le découpage temporel avec purge devient la règle pour toutes les expériences. Ta proposition le prévoyait déjà (« jamais aléatoire ») ; tu as maintenant les chiffres qui justifient ce choix, à citer dans le chapitre Méthodologie.
- Features interdites. Aucun identifiant de région, aucune adresse brute, aucun timestamp absolu. Uniquement des grandeurs relatives au passé de la région.
- Changement de régime. Le test après contient un changement de workload. C’est une version miniature de ta question Q3 (généralisation), qu’on traitera proprement en partie 18 avec le leave-one-workload-out.
- Les vraies traces DAMON remplaceront
simuler_tracessans rien changer d’autre : c’est tout l’intérêt de séparer simulation et construction du dataset.
Exercice pratique
- Mesurer la purge. Remplace
train = df[df.t < t_coupe - H]partrain = df[df.t < t_coupe](sans purge). L’AUC bouge-t-elle ? AugmenteHà 50 et recommence. Pourquoi l’effet grandit-il avec ? - Fuite par le prétraitement. Ajoute une étape
SelectKBest(f_classif, k=4)(depuissklearn.feature_selection) dans le pipeline logistique. Puis fais une version fautive : sélection des 4 meilleures features sur toutdf, avant le split. Compare les features retenues et les AUC. - Sans changement de régime. Mets
T_CHANGEMENT = T(plus aucun changement). L’écart entre split aléatoire et split temporel diminue-t-il ? Qu’est-ce que ça t’apprend sur l’origine de l’écart ? - Nouvelle feature. Ajoute
max_50, le nombre maximal d’accès sur les 50 dernières agrégations. Vérifie qu’elle n’utilise que le passé, puis mesure son effet sur l’AUC temporelle du boosting. - Fil rouge. Reprends la formulation écrite en partie 13 et complète-la : liste des features retenues, découpage temporel avec la taille de purge, et liste explicite des features interdites.
Indice pour la question 1 : la purge retire exactement agrégations par région. Plus l’horizon est long, plus les labels de fin de train empiètent sur le test.
Ressources pour aller plus loin
- Documentation scikit-learn : Common pitfalls and recommended practices, section Data leakage.
- Kaufman et al., Leakage in Data Mining: Formulation, Detection, and Avoidance (KDD 2011) : la référence sur la taxonomie des fuites.
- Marcos López de Prado, Advances in Financial Machine Learning, chapitre 7 : purge et embargo pour les séries temporelles.
- Rappel : pandas : des données brutes au tableau propre, pour
rollingetgroupby.
Ce que tu dois savoir faire avant de passer à la suite
- Citer les trois familles de fuites, avec un exemple de chacune
- Repérer une fuite dans un notebook : feature centrée, prétraitement avant split, identifiants
- Mettre en œuvre un split temporel avec purge et expliquer pourquoi la purge vaut
- Construire des features sur fenêtres glissantes strictement causales avec pandas
- Enfermer le prétraitement dans un
Pipelinescikit-learn
Partie suivante : Évaluer un classifieur pour de vrai (partie 15). Ici on a utilisé l’AUC sans la discuter ; on verra pourquoi elle ne suffit pas quand un faux froid coûte bien plus cher qu’un faux chaud, et comment choisir le seuil de décision.