Un réseau de neurones à la main avec PyTorch
Tenseurs, autograd vérifié à la main et boucle d'entraînement complète : un MLP PyTorch sur les traces mémoire, comparé à la régression logistique et au boosting, et trois bugs silencieux mesurés.
Mastering AI · Phase technique · Semaine 3 · Partie 21
Objectif de l’étape
Dans la synthèse M12, tu as écrit un MLP entièrement en NumPy : forward, rétropropagation à la main, AdamW. Ça marche, mais chaque nouvelle couche demande de réécrire le backward, et la moindre erreur d’indice donne un gradient faux qui « apprend » quand même un peu. Depuis la partie 16, on travaille avec des modèles tout faits (scikit-learn, LightGBM). Pour les modèles de séquences (partie 23), il faut un outil qui calcule les gradients à ta place, sans devenir une boîte noire.
PyTorch est cet outil. L’idée de cet article : ne rien lui déléguer que tu ne saurais pas refaire. On vérifie chaque gradient qu’il calcule contre un gradient écrit à la main.
À la fin de cet article, tu sauras :
- manipuler des tenseurs (forme, type, appareil) et les relier à ce que tu fais déjà en NumPy ;
- expliquer ce que construit autograd pendant le forward et ce que fait
loss.backward(); - vérifier un gradient d’autograd contre la formule de M12 et par différences finies ;
- écrire une boucle d’entraînement complète (
nn.Module,DataLoader, AdamW, validation, meilleure époque) ; - reconnaître, chiffres à l’appui, trois oublis classiques :
zero_grad(),model.eval()et la mise à l’échelle des entrées.
Notions clés
1. Un tenseur, c’est un tableau NumPy qui sait où il vit et d’où il vient
Intuition. Un torch.Tensor ressemble beaucoup à un np.ndarray : mêmes formes, même diffusion (broadcasting), même @ pour le produit matriciel. Il y ajoute trois choses :
| Attribut | Ce qu’il dit | Valeur habituelle ici |
|---|---|---|
dtype |
le type des nombres | float32 (NumPy travaille en float64 par défaut) |
device |
où vivent les données | cpu ; cuda sur une carte graphique |
requires_grad |
faut-il suivre les opérations pour dériver ? | True pour les paramètres |
Le float32 divise par deux la mémoire et accélère les calculs, au prix d’environ 7 chiffres significatifs au lieu de 16. C’est largement assez pour entraîner, mais pas pour vérifier un gradient par différences finies : on repasse alors en float64.
Un GPU apporterait peu à un réseau de 1 409 paramètres : pour d’aussi petites matrices, le coût est surtout celui du lancement des opérations, pas du calcul. Tout ce qui suit tourne sur CPU. Pour passer sur GPU, il suffit de déplacer modèle et données avec .to("cuda"), et rien d’autre ne change.
2. Une couche dense, une transformation affine
Intuition. Une couche dense fait exactement ce que fait une matrice en Required Maths M2 : elle transforme l’espace, puis ajoute une translation. La non-linéarité vient après.
nn.Linear(9, 32) contient une matrice
de taille
et un biais
de taille 32, soit 320 paramètres. Notre réseau enchaîne trois couches :
, soit
paramètres. La sortie est un logit
, un score réel ; la probabilité est
.
3. Le graphe de calcul et autograd
Intuition. Pendant le forward, PyTorch prend des notes : chaque opération sur un tenseur qui demande un gradient est enregistrée avec ses entrées. À la fin, loss.backward() relit ces notes à l’envers et applique la règle de la chaîne de Required Maths M5 à chaque étape.
Pour une régression logistique, le graphe a trois nœuds : produit plus biais, sigmoïde, perte. En remontant, on retrouve la formule écrite à la main en M12 :
Trois règles à retenir :
- le graphe est reconstruit à chaque forward. Un
ifou une bouclefordansforwardsont donc permis : le graphe suit le chemin réellement emprunté ; - les gradients s’additionnent dans
.gradau lieu de le remplacer. C’est voulu (une variable utilisée deux fois reçoit la somme de ses deux contributions), mais il faut donc effacer.gradavant chaque pas ; torch.no_grad()coupe l’enregistrement : pour évaluer, c’est plus rapide et ça ne consomme pas de mémoire pour un graphe inutile.
Ce mode de calcul s’appelle la différentiation automatique en mode inverse. Un seul passage arrière donne le gradient par rapport à tous les paramètres, pour un coût du même ordre qu’un forward. C’est ce qui rend possible l’entraînement de réseaux à des millions de paramètres.
4. La perte : des logits, pas des probabilités
On pourrait appliquer la sigmoïde, puis la log-loss. En pratique, on donne directement les logits à nn.BCEWithLogitsLoss, qui calcule la même chose sous une forme stable :
Avec
arrondie à exactement 1 en float32 (dès que
atteint 17 environ),
vaut
. La forme de droite n’a jamais ce problème. Sa dérivée est
, l’« erreur qui arrive en sortie » de M12.
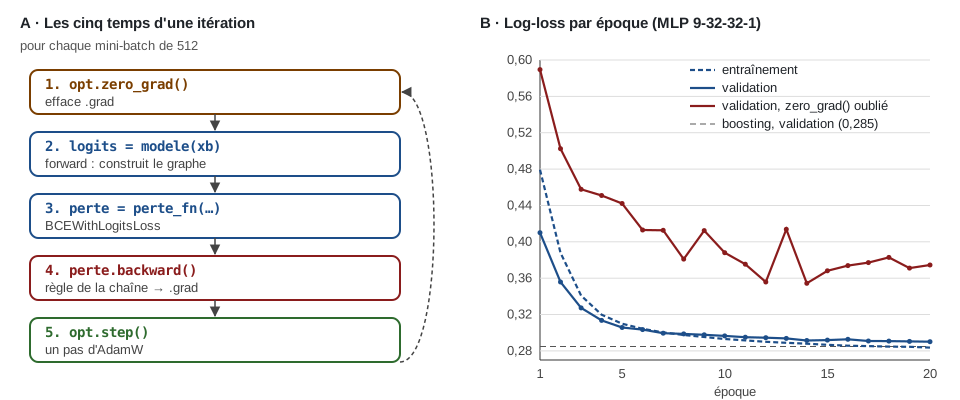
5. La boucle d’entraînement en cinq temps
Intuition. Toute la mécanique de PyTorch se résume à cinq lignes, répétées pour chaque mini-batch.
opt.zero_grad(): effacer les gradients du pas précédent ;logits = modele(xb): forward, qui construit le graphe ;perte = perte_fn(logits, yb): un nombre ;perte.backward(): remplit.gradde chaque paramètre ;opt.step(): un pas de l’optimiseur, ici AdamW (M10 et M11).
Autour, deux objets d’organisation : nn.Module, qui range les couches et retrouve tout seul leurs paramètres (modele.parameters()), et DataLoader, qui découpe les données en mini-batchs mélangés à chaque époque. Et deux modes : modele.train() et modele.eval(). Ils changent le comportement de certaines couches, comme Dropout (actif à l’entraînement, éteint à l’évaluation) ou BatchNorm. Oublier eval() ne provoque aucune erreur : les prédictions deviennent simplement aléatoires. On le mesure plus bas.
Exemple de code
Comme en parties 15 à 20, on reprend tel quel le script de la partie 14 (simulation et dataset), puis on ajoute les quatre blocs ci-dessous à la suite. Le premier bloc ne dépend pas des données : tu peux le lancer seul pour découvrir PyTorch. L’ensemble tourne en moins de deux minutes sur un CPU à deux cœurs (numpy 2.5, pandas 3.0, scikit-learn 1.9, torch 2.14).
Tenseurs et autograd, vérifiés à la main
import time
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.metrics import log_loss

torch.manual_seed(0)
torch.set_num_threads(2)

# 1. Un tenseur : un tableau comme en NumPy, plus un type, un appareil (CPU/GPU) et un historique
X = torch.tensor([[1.0, 0.5], [0.2, -1.0], [-0.3, 0.8], [1.5, 1.2]])
y = torch.tensor([1.0, 0.0, 0.0, 1.0])
print(X.shape, X.dtype, X.device, "| GPU disponible :", torch.cuda.is_available())

# 2. Une régression logistique : autograd enregistre chaque opération dans un graphe
w = torch.zeros(2, requires_grad=True)
b = torch.zeros(1, requires_grad=True)
p = torch.sigmoid(X @ w + b)
perte = nn.functional.binary_cross_entropy(p, y)
print("perte", round(perte.item(), 4), "| graphe :", perte.grad_fn.name(), "<-",
      perte.grad_fn.next_functions[0][0].name(), "<-",
      perte.grad_fn.next_functions[0][0].next_functions[0][0].name())

perte.backward()                                # remonte le graphe : règle de la chaîne (M5)
with torch.no_grad():
    print("autograd :", w.grad.numpy().round(4), "| à la main X^T(p - y)/n :", (X.T @ (p - y) / len(y)).numpy().round(4))

# 3. Les gradients s'ACCUMULENT : un deuxième backward les additionne
nn.functional.binary_cross_entropy(torch.sigmoid(X @ w + b), y).backward()
print("après un 2e backward :", w.grad.numpy().round(4))
w.grad.zero_()                                  # ce que fait optimizer.zero_grad()

# 4. Vérifier autograd par différences finies (en float64, sinon l'arrondi domine)
f = lambda w_: nn.functional.binary_cross_entropy(torch.sigmoid(X.double() @ w_), y.double())
w64 = torch.tensor([0.3, -0.7], dtype=torch.float64, requires_grad=True)
print("gradcheck :", torch.autograd.gradcheck(f, (w64,)))
Sortie :
torch.Size([4, 2]) torch.float32 cpu | GPU disponible : False
perte 0.6931 | graphe : BinaryCrossEntropyBackward0 <- SigmoidBackward0 <- AddBackward0
autograd : [-0.325  -0.2375] | à la main X^T(p - y)/n : [-0.325  -0.2375]
après un 2e backward : [-0.65  -0.475]
gradcheck : True
- Le graphe est lisible : la perte vient d’une sigmoïde, qui vient d’une addition (le biais), elle-même issue du produit
X @ w. C’est la liste des maillons de la règle de la chaîne. - Autograd retrouve la formule de M12 au bit près : .
- Un deuxième
backward()double le gradient au lieu de le remplacer. Retiens cette ligne, elle explique le pire des bugs de la section suivante. gradcheckcompare le gradient d’autograd à des différences finies centrées (M4), enfloat64.Trueveut dire « d’accord à la tolérance près ».
Les données en tenseurs, et le MLP de M12 vérifié contre autograd
On reprend le découpage de la partie 15 : entraînement
, validation
, test
. Les features sont très asymétriques (depuis_dernier va de 0 à 500) : on applique log1p, puis une standardisation dont la moyenne et l’écart-type viennent du seul entraînement (la règle anti-fuite de la partie 14).
# Le découpage de la partie 15 : entraînement t < 1390, validation 1400 <= t < 1790, test t >= 1800
tr = df[df.t < 1390]
va = df[(df.t >= 1400) & (df.t < 1790)]
te = df[df.t >= 1800]


def tenseurs(d, log=True, standardiser=True):
    """Features -> tenseur float32. log1p écrase les queues ; la standardisation n'utilise que le train."""
    A, R = d[FEATURES], tr[FEATURES]
    if log:
        A, R = np.log1p(A), np.log1p(R)
    if standardiser:
        A = (A - R.mean()) / R.std()
    return (torch.tensor(A.to_numpy(), dtype=torch.float32),
            torch.tensor(d.y.to_numpy(), dtype=torch.float32))


Xtr, ytr = tenseurs(tr)
Xva, yva = tenseurs(va)
Xte, yte = tenseurs(te)
print(tuple(Xtr.shape), tuple(Xva.shape), tuple(Xte.shape), Xtr.dtype)

# Le MLP de M12 (9 -> 32 -> 1), gradient écrit à la main, puis comparé à autograd
D, C = len(FEATURES), 32
g = torch.Generator().manual_seed(0)
W1 = torch.randn(D, C, generator=g) * np.sqrt(2 / D)     # initialisation de He (M12)
b1 = torch.zeros(C)
w2 = torch.randn(C, generator=g) * np.sqrt(2 / C)
b2 = torch.zeros(1)
Xb, yb = Xtr[:512], ytr[:512]

z1 = Xb @ W1 + b1                        # M2 : transformation affine
h = torch.relu(z1)                       # non-linéarité
p = torch.sigmoid(h @ w2 + b2)
d2 = (p - yb) / len(yb)                  # M5 : l'erreur qui arrive en sortie
grad_main = [Xb.T @ (torch.outer(d2, w2) * (z1 > 0)),   # on remonte w2, puis la dérivée de ReLU
             (torch.outer(d2, w2) * (z1 > 0)).sum(0), h.T @ d2, d2.sum(0, keepdim=True)]

params = [t.clone().requires_grad_() for t in (W1, b1, w2, b2)]
W1a, b1a, w2a, b2a = params
pa = torch.sigmoid(torch.relu(Xb @ W1a + b1a) @ w2a + b2a)
nn.functional.binary_cross_entropy(pa, yb).backward()
print(f"écart main / autograd : {max((q.grad - m).abs().max().item() for q, m in zip(params, grad_main)):.1e}")
Sortie : (123840, 9) (37440, 9) (114240, 9) torch.float32, puis écart main / autograd : 6.0e-08.
L’écart de
est celui de l’arrondi float32, pas d’une erreur de formule : en float64, le contrôle par différences finies de l’exercice 1 descend à
. Les gradients écrits à la main en M12 et ceux d’autograd sont donc les mêmes. À partir d’ici, on peut laisser autograd faire le travail, en sachant exactement ce qu’il calcule.
La boucle d’entraînement, et la comparaison honnête
from sklearn.metrics import roc_auc_score


class MLP(nn.Module):
    """9 -> 32 -> 32 -> 1. nn.Module enregistre tout seul les paramètres des couches."""
    def __init__(self, d_in, cachee=32, p_dropout=0.0):
        super().__init__()
        self.reseau = nn.Sequential(
            nn.Linear(d_in, cachee), nn.ReLU(), nn.Dropout(p_dropout),
            nn.Linear(cachee, cachee), nn.ReLU(), nn.Dropout(p_dropout),
            nn.Linear(cachee, 1))

    def forward(self, x):
        return self.reseau(x).squeeze(-1)        # des logits : la sigmoïde est dans la perte


def evaluer(modele, X, y):
    modele.eval()                                # Dropout désactivé (et BatchNorm figé)
    with torch.no_grad():                        # pas de graphe : plus rapide, moins de mémoire
        p = torch.sigmoid(modele(X)).numpy()
    return roc_auc_score(y.numpy(), p), log_loss(y.numpy(), p)


def entrainer(Xtr, ytr, Xva, yva, epoques=20, graine=0, zero_grad=True, p_dropout=0.0, verbeux=False):
    torch.manual_seed(graine)
    modele = MLP(Xtr.shape[1], p_dropout=p_dropout)
    opt = torch.optim.AdamW(modele.parameters(), lr=1e-3, weight_decay=1e-4)   # M10 + M11
    perte_fn = nn.BCEWithLogitsLoss()            # sigmoïde + log-loss, numériquement stable
    chargeur = DataLoader(TensorDataset(Xtr, ytr), batch_size=512, shuffle=True)
    meilleure, etat, hist = np.inf, None, []
    for epoque in range(1, epoques + 1):
        modele.train()
        somme = 0.0
        for xb, yb in chargeur:
            if zero_grad:
                opt.zero_grad()                  # 1. effacer les gradients du pas précédent
            perte = perte_fn(modele(xb), yb)     # 2. forward + 3. perte
            perte.backward()                     # 4. backward : remplit .grad de chaque paramètre
            opt.step()                           # 5. un pas d'AdamW
            somme += perte.item() * len(yb)
        auc_va, ll_va = evaluer(modele, Xva, yva)
        hist.append((epoque, somme / len(ytr), ll_va, auc_va))
        if ll_va < meilleure:                    # on garde la meilleure époque sur la validation
            meilleure, etat = ll_va, {k: v.clone() for k, v in modele.state_dict().items()}
        if verbeux and epoque in (1, 2, 5, 10, 15, 20):
            print(f"époque {epoque:>2} | log-loss train {somme / len(ytr):.4f} | val {ll_va:.4f} | AUC val {auc_va:.3f}")
    modele.load_state_dict(etat)
    return modele, hist


t0 = time.perf_counter()
modele, hist = entrainer(Xtr, ytr, Xva, yva, verbeux=True)
best = min(hist, key=lambda r: r[2])
print(f"{sum(q.numel() for q in modele.parameters())} paramètres | {time.perf_counter() - t0:.0f} s | "
      f"meilleure époque {best[0]} (log-loss val {best[2]:.4f})")

# Une seule fois sur le test, avec deux références entraînées sur le même découpage
lr = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)).fit(tr[FEATURES], tr.y)
hgb = HistGradientBoostingClassifier(max_iter=200, random_state=0).fit(tr[FEATURES], tr.y)
modele.eval()
with torch.no_grad():
    p_mlp = {"va": torch.sigmoid(modele(Xva)).numpy(), "te": torch.sigmoid(modele(Xte)).numpy()}
probas = {"régression logistique": {k: lr.predict_proba(d[FEATURES])[:, 1] for k, d in (("va", va), ("te", te))},
          "boosting (partie 15)": {k: hgb.predict_proba(d[FEATURES])[:, 1] for k, d in (("va", va), ("te", te))},
          "MLP PyTorch": p_mlp}


def cout_moyen(y, p, seuil, c_fn=10, c_fp=1):
    """Le coût de la partie 15 : un faux froid coûte 10, un faux chaud 1."""
    return (c_fn * np.sum((y == 1) & (p < seuil)) + c_fp * np.sum((y == 0) & (p >= seuil))) / len(y)


seuils = np.linspace(0.01, 0.99, 99)
print(f"ne jamais compresser : coût test {cout_moyen(te.y.to_numpy(), np.ones(len(te)), 0.5):.3f}")
for nom, p in probas.items():
    s = seuils[np.argmin([cout_moyen(va.y.to_numpy(), p["va"], s) for s in seuils])]   # seuil choisi sur la validation
    print(f"{nom:>22} | AUC val {roc_auc_score(va.y, p['va']):.3f} | AUC test {roc_auc_score(te.y, p['te']):.3f}"
          f" | log-loss test {log_loss(te.y, p['te']):.4f} | seuil {s:.2f}"
          f" | coût test {cout_moyen(te.y.to_numpy(), p['te'], s):.3f} | compressées {(p['te'] < s).mean():.1%}")
| Époque | Log-loss d’entraînement | Log-loss de validation | AUC de validation |
|---|---|---|---|
| 1 | 0,4793 | 0,4101 | 0,851 |
| 2 | 0,3879 | 0,3558 | 0,873 |
| 5 | 0,3099 | 0,3058 | 0,899 |
| 10 | 0,2931 | 0,2965 | 0,902 |
| 15 | 0,2867 | 0,2918 | 0,904 |
| 20 | 0,2836 | 0,2901 | 0,906 |
1 409 paramètres, 17 secondes d’entraînement. La meilleure époque est la dernière : en 20 époques, la validation n’a pas encore commencé à remonter. Les deux courbes restent collées (panneau B de la figure) : pas de surapprentissage à ce stade, ce qui est attendu avec 123 840 exemples pour 1 409 paramètres.
Puis, une seule fois, le test, avec deux références entraînées sur exactement les mêmes lignes. Comme en partie 16, on ne s’arrête pas à l’AUC : on choisit le seuil sur la validation avec le coût de la partie 15 (un faux froid coûte 10, un faux chaud 1), et on compare à la vraie référence, « ne jamais compresser », qui coûte 0,689 par région sur le test.
| Modèle | AUC val | AUC test | Log-loss test | Seuil (val) | Coût test | Compressées (test) |
|---|---|---|---|---|---|---|
| Régression logistique (partie 16) | 0,808 | 0,793 | 0,4621 | 0,14 | 0,723 | 17,6 % |
| Boosting (partie 15) | 0,911 | 0,858 | 0,3717 | 0,11 | 0,707 | 32,9 % |
| MLP PyTorch | 0,906 | 0,868 | 0,3502 | 0,08 | 0,653 | 21,0 % |
| Ne jamais compresser | 0,689 | 0 % |
- Le MLP fait beaucoup mieux que la régression logistique (+7,5 points d’AUC de test) avec les mêmes 9 features : ses couches cachées construisent elles-mêmes les transformations non linéaires que la partie 16 devait ajouter à la main (
proche_cycle,log_depuis). C’est le résultat de M12, à l’échelle du vrai dataset. - Il est légèrement derrière le boosting en validation, mais devant sur le test (0,868 contre 0,858), avec une log-loss plus basse (0,350 contre 0,372). Le test contient le changement de régime de ; une fonction lisse semble moins dépendre des seuils appris avant le changement.
- C’est surtout le seul des trois à passer sous « ne jamais compresser » : 0,653 contre 0,689, en compressant 21 % des régions. Le LightGBM retenu en partie 17 y arrivait aussi (0,666), avec un écart non significatif. Ici aussi, prudence : sur une seule graine, l’intervalle de confiance du gain touche zéro, et le boosting comparé n’est pas réglé. L’exercice 3 teste cinq graines et fait le bootstrap ; la comparaison sérieuse avec le LightGBM réglé de la partie 18 se fera dans le projet fil rouge (partie 24), avec le protocole de la partie 18.
Trois oublis classiques, mesurés
Ces bugs ne lèvent aucune erreur. Le code tourne, la perte baisse, et le modèle est simplement moins bon. Le seul moyen de les voir, c’est de les mesurer.
# 4. Trois oublis classiques, mesurés : même réseau, même graine, mêmes 20 époques
variantes = {
    "référence (log1p + standardisation)": (Xtr, Xva, Xte, {}),
    "standardisation sans log1p": (*[tenseurs(d, log=False)[0] for d in (tr, va, te)], {}),
    "aucune mise à l'échelle": (*[tenseurs(d, log=False, standardiser=False)[0] for d in (tr, va, te)], {}),
    "zero_grad() oublié": (Xtr, Xva, Xte, {"zero_grad": False}),
}
for nom, (A, B, Cte, options) in variantes.items():
    m, _ = entrainer(A, ytr, B, yva, **options)
    print(f"{nom:>36} | AUC val {evaluer(m, B, yva)[0]:.3f} | AUC test {evaluer(m, Cte, yte)[0]:.3f}")

# Dropout : oublier model.eval() rend les prédictions aléatoires
m_drop, _ = entrainer(Xtr, ytr, Xva, yva, p_dropout=0.2)
m_drop.train()                                   # l'oubli : on prédit en mode entraînement
with torch.no_grad():
    p1, p2 = torch.sigmoid(m_drop(Xte)), torch.sigmoid(m_drop(Xte))
print(f"dropout 0,2 | même entrée, deux appels : écart max {(p1 - p2).abs().max():.3f} | "
      f"AUC test en mode train {roc_auc_score(yte.numpy(), p1.numpy()):.3f} | "
      f"en mode eval {evaluer(m_drop, Xte, yte)[0]:.3f}")

# Latence : une décision pour 96 régions, comme le ferait le démon toutes les 100 ms
x96 = Xte[:96]
modele.eval()
with torch.inference_mode():
    for _ in range(100):
        modele(x96)                              # chauffe
    t0 = time.perf_counter()
    for _ in range(1000):
        modele(x96)
print(f"96 régions : {(time.perf_counter() - t0) / 1000 * 1e6:.0f} µs par appel")
| Variante (même graine, 20 époques) | AUC val | AUC test |
|---|---|---|
Référence (log1p + standardisation) |
0,906 | 0,868 |
Standardisation sans log1p |
0,907 | 0,867 |
| Aucune mise à l’échelle | 0,895 | 0,864 |
zero_grad() oublié |
0,858 | 0,828 |
Puis, avec un réseau qui contient du dropout (0,2) : le même lot de test passé deux fois en mode train() donne des probabilités qui diffèrent jusqu’à 0,950 pour une même région, et l’AUC de test tombe de 0,868 (mode eval()) à 0,862.
zero_grad()oublié est le pire : −4 points d’AUC de test. Chaque pas utilise la somme de tous les gradients depuis le début de l’entraînement, un « momentum » sans oubli que l’optimiseur n’a pas prévu. La courbe rouge de la figure ne descend jamais de façon stable.- Oublier
eval()rend le modèle aléatoire : deux appels sur la même entrée, deux réponses qui peuvent aller d’une région « sûrement froide » à « sûrement chaude ». Pour le démon, ce serait une page compressée puis décompressée au hasard. - La mise à l’échelle compte moins qu’on ne le dit, ici. Sans aucune normalisation, on perd 1,1 point de validation et 0,4 point de test. AdamW divise chaque pas par l’amplitude récente du gradient de chaque paramètre, ce qui compense en partie les écarts d’échelle. Avec une descente de gradient simple, l’effet est plus fort : c’est l’exercice 2. Quant au
log1p, il ne change rien ici (0,907 contre 0,906), mais il ne coûte rien et protège des valeurs extrêmes.
Latence. Une décision pour 96 régions prend entre 30 et 40 µs sur notre CPU à deux cœurs (34, 36 et 39 µs sur trois exécutions complètes du script, 28 µs mesurés isolément). C’est l’ordre de grandeur du LightGBM à 10 arbres de la partie 17, et des milliers de fois moins que la période d’agrégation de DAMON (100 ms).
Fil rouge : ce que ça change pour le mémoire
- Le MLP devient une référence de plus. Avec les mêmes features et le même découpage, il bat la régression logistique de loin, rivalise avec le boosting, et passe sous « ne jamais compresser » sur les cinq graines testées. Pour le chapitre Expériences, la question n’est donc plus « un réseau peut-il apprendre ce problème ? » mais « une architecture séquentielle (LSTM, partie 23) apporte-t-elle quelque chose au-delà d’un MLP sur les mêmes features ? ». C’est la bonne référence pour un LSTM : si le LSTM ne bat pas ce MLP, la mémoire de séquence n’apporte rien.
- Vérifie tes gradients une fois, puis fais confiance. Si tu écris une couche ou une perte maison (par exemple une perte asymétrique qui pénalise davantage les faux froids, comme le coût de la partie 15), passe-la dans
torch.autograd.gradcheckenfloat64avant de t’en servir. - Les trois oublis vont dans la checklist de relecture du code.
zero_grad()dans la boucle,eval()+no_grad()(ouinference_mode()) à chaque évaluation, statistiques de normalisation calculées sur l’entraînement seul et sauvegardées avec le modèle : le démon devra appliquer exactement les mêmes. - La latence n’est pas un obstacle. Quelques dizaines de microsecondes pour 96 régions laissent de la marge pour des milliers de régions par agrégation. Le vrai coût sera l’export du modèle hors de Python (TorchScript ou ONNX, partie 26).
Exercice pratique
- Différences finies sur le MLP. Après
torch.manual_seed(0), crée unMLPneuf et convertis-le enfloat64(.double()), calcule la perte sur 256 lignes d’entraînement et son gradient par autograd. Pour le premier et le dernier élément de chaque tenseur de paramètres, compare avec , . Quel est le plus grand écart ? Recommence enfloat32: pourquoi l’écart explose-t-il ? - Sans Adam. Remplace AdamW par
torch.optim.SGD(..., lr=0.05, momentum=0.9)et entraîne 20 époques sur les entrées de référence puis sur les entrées brutes (log=False, standardiser=False). Recommence aveclr=0.005. Que remarques-tu sur le meilleur pas selon la mise à l’échelle ? - Le gain est-il réel ? Entraîne le MLP avec
grainede 0 à 4 et donne, pour chacune, l’AUC de test et le coût de test (seuil choisi sur la validation). Le MLP bat-il le boosting (0,858) et « ne jamais compresser » (0,689) à chaque fois ? Puis, pour la graine 0, calcule un intervalle de confiance à 95 % sur la différence de coût MLP − « ne jamais compresser » par bootstrap sur les 96 régions (2 000 tirages, comme en partie 16). Conclus. - Plus longtemps. Passe à 60 époques. Quelle est la meilleure époque sur la validation ? Le surapprentissage apparaît-il ? Qu’en conclus-tu pour la partie 22 ?
- Fil rouge. Réécris la boucle d’entraînement sans regarder cet article, puis compare ligne à ligne. Mesure ensuite la latence d’un appel pour le nombre de régions de ton vrai workload DAMON, sur la machine cible du démon.
Indices. Question 1 : plus grand écart
en float64, mais
en float32 : autour d’une perte de 0,73, deux float32 voisins sont séparés de
, et une variation de
d’un poids ne change la perte que de quelques-uns de ces pas : la différence finie est dominée par l’arrondi. Question 2 : en gardant la meilleure époque comme entrainer, avec lr=0.05, AUC de validation 0,912 sur les entrées de référence (un peu mieux qu’AdamW) contre 0,859 sur les entrées brutes ; avec lr=0.005, 0,889 contre 0,891. Sans mise à l’échelle, le bon pas change, et il faut le rechercher. Question 3 : AUC de test 0,868 · 0,871 · 0,872 · 0,870 · 0,872 (moyenne 0,871, écart-type 0,001), toujours au-dessus de 0,858 ; coûts de test 0,653 · 0,619 · 0,665 · 0,637 · 0,623 (seuils 0,06 à 0,10), toujours sous 0,689. Pour la graine 0, la différence vaut −0,035 et l’intervalle [−0,079 ; +0,002] (graine 0 pour le bootstrap) : il touche à peine zéro. Les cinq graines vont dans le même sens, mais une seule graine ne suffirait pas à l’affirmer. Question 4 : la meilleure époque est la 60e (log-loss de validation 0,2817, AUC de validation 0,912, AUC de test 0,874) : toujours aucun surapprentissage. Avec 1 409 paramètres pour 123 840 exemples, le réseau n’en est pas encore à apprendre le bruit. Savoir quand s’arrêter, régulariser et régler le pas sont l’objet de la partie 22.
Ressources pour aller plus loin
- Tutoriels officiels PyTorch : Learn the Basics (tenseurs,
Dataset/DataLoader,nn.Module, autograd, boucle d’optimisation) et A Gentle Introduction to torch.autograd. - Andrej Karpathy, micrograd et la série Neural Networks: Zero to Hero : un autograd écrit en 100 lignes, le meilleur moyen de ne plus voir
backward()comme de la magie. - Baydin et al., Automatic Differentiation in Machine Learning: a Survey (JMLR, 2018) : mode direct, mode inverse, et pourquoi le second domine en apprentissage.
- Documentation PyTorch :
torch.autograd.gradchecket la note Autograd mechanics (accumulation des gradients,no_grad,inference_mode). - Rappels : M5 · Règle de la chaîne et rétropropagation, Keras : mon premier réseau de neurones.
Ce que tu dois savoir faire avant de passer à la suite
- Créer des tenseurs, lire leur forme, leur type et leur appareil, et passer de NumPy à PyTorch
- Expliquer ce qu’autograd enregistre pendant le forward et ce que fait
loss.backward() - Expliquer pourquoi les gradients s’accumulent et où placer
zero_grad() - Vérifier un gradient d’autograd contre une formule écrite à la main et avec
gradcheck - Écrire de mémoire une boucle d’entraînement :
nn.Module,DataLoader, perte sur logits, AdamW, validation, meilleure époque - Évaluer correctement :
eval(),no_grad(), statistiques de normalisation venues de l’entraînement - Comparer un réseau à des références entraînées sur le même découpage, en regardant le test une seule fois
Partie suivante : Bien entraîner un réseau de neurones (partie 22). Ici, le réseau n’a jamais surappris et on a pris le pas d’AdamW par défaut. On verra comment choisir le pas, quand arrêter l’entraînement, et ce qu’apportent dropout, weight decay et normalisation quand le réseau devient assez grand pour apprendre le bruit.