M9 · Statistique inférentielle pour comparer des modèles
Intervalles de confiance, bootstrap, McNemar, t corrigé et Kolmogorov-Smirnov : prouver qu'un modèle est vraiment meilleur qu'un autre, et détecter un drift.
Mastering AI · Required Maths · Semaine 3 (probabilités et statistiques) · Partie 9
Objectif de l’étape
« LightGBM obtient un F1 de 0,681, la régression logistique 0,582 : LightGBM est meilleur. » Cette phrase ne vaut rien tant qu’on ne sait pas si l’écart dépasse le bruit. Un score de test est une estimation calculée sur un échantillon fini : avec un autre jeu de test, il aurait été différent. Cet article donne les outils pour affirmer « A est meilleur que B » avec une rigueur défendable devant un jury de mémoire.
À la fin de cet article, tu sauras :
- expliquer ce qu’est un estimateur, son biais et son erreur standard ;
- construire un intervalle de confiance et dire ce que « 95 % » signifie vraiment ;
- construire un intervalle par bootstrap pour n’importe quelle métrique (F1 compris) ;
- formuler un test d’hypothèse et interpréter une p-valeur sans contresens ;
- comparer deux modèles sur le même jeu de test (bootstrap apparié, McNemar) et sur plusieurs plis de validation croisée (t corrigé, 5x2cv, Wilcoxon) ;
- détecter un drift avec Kolmogorov-Smirnov et te méfier des comparaisons multiples.
Notions clés
1. Estimateur, biais et erreur standard
Intuition. Le F1 que tu mesures sur ton jeu de test n’est pas « le F1 du modèle » : c’est une estimation de la performance qu’il aurait sur toutes les régions mémoire possibles. Change le jeu de test, et le chiffre bouge. L’erreur standard mesure de combien il bouge typiquement.
Un estimateur est une fonction des données qui vise une quantité inconnue . Deux propriétés comptent :
- le biais : se trompe-t-il en moyenne ? ;
- l’erreur standard : de combien fluctue-t-il d’un échantillon à l’autre ?
Pour une accuracy mesurée sur exemples, chaque prédiction est correcte ou non : c’est une Bernoulli de paramètre (M7). L’accuracy est leur moyenne, donc :
Une accuracy de 0,80 mesurée sur 200 exemples a une erreur standard d’environ 0,028 : le deuxième chiffre après la virgule est déjà incertain.
2. L’intervalle de confiance, et ce qu’il signifie vraiment
Intuition. Plutôt qu’un chiffre, on donne une fourchette. Grâce au théorème central limite (M7), une moyenne suit approximativement une loi normale, et 95 % de la masse d’une loi normale tient à écart-type de son centre :
où est l’écart-type empirique. Pour une proportion, devient (intervalle de Wald).
Ce que « 95 % » veut dire. Ce n’est pas « il y a 95 % de chances que la vraie valeur soit dans cet intervalle ». La vraie valeur est fixe ; c’est l’intervalle qui est aléatoire. La phrase correcte : si on répétait l’expérience un grand nombre de fois, 95 % des intervalles construits ainsi contiendraient la vraie valeur. On le vérifie par simulation plus bas.
La largeur décroît en : pour diviser l’incertitude par 10, il faut 100 fois plus d’exemples de test.
3. Le bootstrap : des intervalles sans formule
Intuition. Pour le F1, l’AUC ou une médiane, il n’y a pas de formule simple d’erreur standard. Idée d’Efron (1979) : le jeu de test est notre meilleure image de la population. On rééchantillonne avec remise exemples parmi les du jeu de test, on recalcule la métrique, et on recommence fois (typiquement à ). La dispersion des valeurs imite la dispersion qu’on aurait observée avec de nouveaux jeux de test.
L’intervalle percentile à 95 % est simplement :
Limite importante : le bootstrap suppose des exemples indépendants. Des agrégations successives d’une même région mémoire sont autocorrélées (M7) : il faut alors rééchantillonner par blocs (des régions entières, ou des tranches de temps) plutôt qu’exemple par exemple.
4. Tests d’hypothèse et p-valeur
Intuition. On joue l’avocat du diable : on suppose qu’il n’y a aucune différence (l’hypothèse nulle ) et on se demande si ce qu’on a observé serait surprenant dans ce monde-là.
- La p-valeur est la probabilité, si est vraie, d’observer un résultat au moins aussi extrême que celui qu’on a obtenu.
- Si (souvent ), on rejette .
Deux façons de se tromper :
| vraie (pas de différence) | fausse (vraie différence) | |
|---|---|---|
| On rejette | Erreur de type I (faux positif), probabilité | Bonne décision, probabilité = puissance |
| On ne rejette pas | Bonne décision | Erreur de type II (faux négatif), probabilité |
Trois contresens à éviter :
- la p-valeur n’est pas . C’est : pour inverser la flèche, il faudrait Bayes et un a priori (M8) ;
- « non significatif » ne veut pas dire « pas de différence » : peut-être que le test manquait de puissance (trop peu d’exemples) ;
- « significatif » ne veut pas dire « important » : avec un million d’exemples, un écart de F1 de 0,001 devient significatif. Regarde toujours la taille de l’effet et son intervalle, pas seulement .
5. Comparer deux modèles sur le même jeu de test
Intuition. Les deux modèles sont évalués sur les mêmes exemples. Les exemples faciles sont réussis par les deux, les très difficiles ratés par les deux : ces exemples-là ne disent rien sur la différence. Il faut exploiter cet appariement, sinon on noie la différence dans le bruit commun.
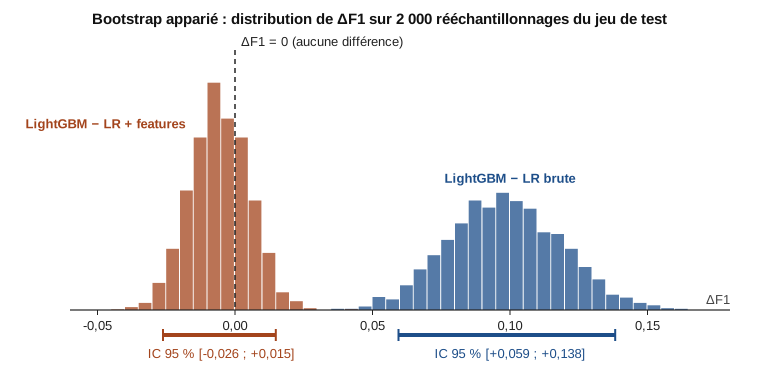
Bootstrap apparié. À chaque rééchantillonnage, on tire les mêmes indices pour les deux modèles et on calcule directement . Si l’intervalle de exclut 0, la différence est significative.
Test de McNemar. On ne regarde que les désaccords : exemples où A a raison et B tort, où c’est l’inverse. Sous , chaque désaccord penche d’un côté ou de l’autre avec probabilité , donc suit une binomiale . Pour de grands effectifs, on utilise l’approximation :
C’est le test recommandé par Dietterich (1998) quand on ne peut entraîner chaque modèle qu’une fois.
6. Comparer sur plusieurs plis de validation croisée
Intuition. Avec une validation croisée, on obtient une différence par pli. Le réflexe est un t-test apparié sur ces différences. Problème : les plis partagent une grande partie de leurs données d’entraînement, donc les sont corrélés et leur variance est sous-estimée. Le t-test naïf est beaucoup trop optimiste (M7 l’avait annoncé : la corrélation empêche la variance de baisser en ).
Deux corrections classiques, pour différences de moyenne et de variance empirique :
Le t corrigé de Nadeau et Bengio (2003) ajoute le terme pour tenir compte du chevauchement ; il se compare à une loi de Student à degrés de liberté.
Le 5x2cv de Dietterich : 5 répétitions d’une validation croisée à 2 plis. Pour la répétition , on note les deux différences, leur moyenne et . Alors :
suit approximativement une loi de Student à 5 degrés de liberté.
Enfin, le test de Wilcoxon (signé des rangs) ne suppose pas de loi normale : il ne regarde que le signe et le rang des différences. Avec 10 différences toutes positives, sa p-valeur exacte vaut : c’est le plus petit possible avec 10 plis.
7. Kolmogorov-Smirnov pour détecter un drift
Intuition. En production, la loi des features peut changer (nouveau workload, nouvelle version du noyau). Le test de Kolmogorov-Smirnov à deux échantillons compare deux distributions entières, pas seulement leurs moyennes. Sa statistique est l’écart maximal entre les deux fonctions de répartition empiriques :
mesure la taille du drift (entre 0 et 1), la p-valeur dit seulement s’il est détectable. Avec beaucoup de données, le moindre drift devient significatif : en monitoring (partie 28), on alerte sur un seuil de , pas sur .
8. Comparaisons multiples
Intuition. Si tu fais 20 tests à alors que rien n’est vrai, tu as en moyenne un faux positif. La probabilité d’en avoir au moins un est :
C’est le piège classique du tuning : tester 20 variantes d’hyperparamètres sur le même jeu de test et garder « la meilleure ». La correction de Bonferroni teste chaque hypothèse au seuil : simple, conservatrice, et elle ramène le risque global sous . Mieux encore : garder un jeu de test qu’on ne regarde qu’une fois (partie 18).
Exemple de code
Intervalle de confiance d’une accuracy, et sa couverture
import numpy as np

rng = np.random.default_rng(0)
p_vrai = 0.80                      # vraie accuracy du modèle (inconnue en pratique)

# 1. un seul jeu de test de 200 exemples
correct = rng.binomial(1, p_vrai, 200)     # 1 = prédiction correcte
acc = correct.mean()
se = np.sqrt(acc * (1 - acc) / 200)
print(f"accuracy = {acc:.3f} | erreur standard = {se:.4f} | IC 95 % = [{acc - 1.96 * se:.3f} ; {acc + 1.96 * se:.3f}]")

# 2. la largeur de l'intervalle en fonction de n
for n in (200, 2_000, 20_000):
    print(f"n = {n:>6} : demi-largeur ≈ ±{1.96 * np.sqrt(p_vrai * (1 - p_vrai) / n):.3f}")

# 3. que veut dire « 95 % » ? on répète l'expérience 10 000 fois
n, couverts = 200, 0
for _ in range(10_000):
    a = rng.binomial(1, p_vrai, n).mean()
    s = np.sqrt(a * (1 - a) / n)
    couverts += (a - 1.96 * s <= p_vrai <= a + 1.96 * s)
print(f"taux de couverture : {couverts / 10_000:.1%}")
Résultat :
- le premier jeu de test donne une accuracy de 0,725, une erreur standard de 0,0316 et l’intervalle . Pas de chance : il ne contient pas la vraie valeur 0,80. C’est exactement ce que « 95 % » autorise : environ un intervalle sur vingt rate la cible, et on ne sait jamais lequel ;
- la demi-largeur vaut pour 200 exemples, pour 2 000 et pour 20 000 : en données, en incertitude ;
- sur 10 000 répétitions, 94,0 % des intervalles contiennent 0,80. Un peu moins que 95 % : l’intervalle de Wald est légèrement trop étroit pour une proportion avec (l’exercice 2 propose mieux).
Le fil rouge : trois modèles, un jeu de test
On génère des régions mémoire synthétiques. Une région est chaude dans la prochaine fenêtre si elle a été beaucoup accédée récemment, si son dernier accès est proche, ou si elle est périodique et que son pic approche. Cette dernière règle est une interaction : un arbre la trouve seul, une régression logistique ne la voit que si on la lui donne.
import numpy as np
import lightgbm as lgb
from scipy import stats
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import f1_score
from sklearn.model_selection import train_test_split


def make_regions(n, rng):
    """Régions mémoire synthétiques : label 1 = chaude dans la prochaine fenêtre."""
    taux = rng.gamma(0.6, 4, n)                          # popularité très inégale
    acces_recents = rng.poisson(taux)
    depuis_dernier = np.round(rng.exponential(30 / (1 + acces_recents)), 1)
    periodique = rng.binomial(1, 0.25, n)
    avant_pic = rng.integers(0, 12, n)                   # pas restants avant le prochain pic
    logit = (0.9 * np.log1p(acces_recents) - 0.05 * depuis_dernier
             + 3.0 * periodique * (avant_pic < 3) - 1.5 + rng.normal(0, 0.8, n))
    X = np.column_stack([acces_recents, depuis_dernier, periodique, avant_pic])
    return X, (logit > 0).astype(int)


def features_metier(X):
    """Ce qu'un humain ajouterait : log des accès et interaction « périodique et pic imminent »."""
    return np.column_stack([np.log1p(X[:, 0]), X[:, 1], X[:, 2], X[:, 2] * (X[:, 3] < 3)])


rng = np.random.default_rng(0)
X, y = make_regions(5000, rng)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)

preds = {
    "LR brute": LogisticRegression(max_iter=1000).fit(Xtr, ytr).predict(Xte),
    "LR + features": LogisticRegression(max_iter=1000).fit(features_metier(Xtr), ytr).predict(features_metier(Xte)),
    "LightGBM": lgb.LGBMClassifier(n_estimators=200, learning_rate=0.05, num_leaves=15,
                                   verbose=-1).fit(Xtr, ytr).predict(Xte),
}

# bootstrap apparié : on rééchantillonne les MÊMES indices pour tous les modèles
B, n_test = 2000, len(yte)
idx = rng.integers(0, n_test, (B, n_test))
f1_boot = {nom: np.array([f1_score(yte[i], p[i]) for i in idx]) for nom, p in preds.items()}
for nom, p in preds.items():
    lo, hi = np.percentile(f1_boot[nom], [2.5, 97.5])
    print(f"{nom:<14} F1 = {f1_score(yte, p):.3f}  IC 95 % bootstrap [{lo:.3f} ; {hi:.3f}]")


def comparer(a, b):
    diff = f1_boot[b] - f1_boot[a]
    lo, hi = np.percentile(diff, [2.5, 97.5])
    ok_a, ok_b = preds[a] == yte, preds[b] == yte
    n01, n10 = int(np.sum(ok_a & ~ok_b)), int(np.sum(~ok_a & ok_b))   # désaccords
    p_mcnemar = stats.binomtest(n01, n01 + n10, 0.5).pvalue
    print(f"{b} − {a} : ΔF1 = {f1_score(yte, preds[b]) - f1_score(yte, preds[a]):+.3f}, "
          f"IC 95 % [{lo:+.3f} ; {hi:+.3f}] | McNemar : {n01} contre {n10}, p = {p_mcnemar:.2g}")


comparer("LR brute", "LightGBM")
comparer("LR + features", "LightGBM")
Environ 22 % des régions sont chaudes. Sur les 1 500 régions de test :
| Modèle | F1 | IC 95 % bootstrap |
|---|---|---|
| LR brute | 0,582 | |
| LR + features | 0,686 | |
| LightGBM | 0,681 |
| Comparaison | IC 95 % apparié | McNemar ( contre ) | p | |
|---|---|---|---|---|
| LightGBM − LR brute | +0,099 | 44 contre 84 | 0,00052 | |
| LightGBM − LR + features | −0,005 | 28 contre 25 | 0,78 |
Deux conclusions très différentes :
- LightGBM bat nettement la LR brute : l’intervalle apparié est loin de 0 et McNemar donne . Sur les 128 régions où les deux modèles sont en désaccord, LightGBM a raison 84 fois ;
- LightGBM et la LR avec les bonnes features sont à égalité : l’écart de 0,005 est noyé dans le bruit ( ). Annoncer « la LR fait mieux » serait faux, annoncer « LightGBM est inutile » aussi : on ne peut pas les départager avec ce jeu de test.
Remarque aussi la force de l’appariement : les intervalles individuels des deux derniers modèles font environ 0,08 de large, mais l’intervalle de leur différence ne fait que 0,04. Comparer deux intervalles qui se chevauchent n’est pas un test : seul l’intervalle de la différence compte.
Plusieurs plis : t naïf, t corrigé, 5x2cv et Wilcoxon
# suite du bloc précédent (make_regions, X, y déjà définis)
from sklearn.model_selection import StratifiedKFold

diffs = np.zeros((5, 2))
for r in range(5):
    plis = StratifiedKFold(n_splits=2, shuffle=True, random_state=r).split(X, y)
    for k, (tr, te) in enumerate(plis):
        f_lr = f1_score(y[te], LogisticRegression(max_iter=1000).fit(X[tr], y[tr]).predict(X[te]))
        f_gb = f1_score(y[te], lgb.LGBMClassifier(n_estimators=200, learning_rate=0.05, num_leaves=15,
                                                  verbose=-1).fit(X[tr], y[tr]).predict(X[te]))
        diffs[r, k] = f_gb - f_lr

d = diffs.ravel()
t_naif = d.mean() / (d.std(ddof=1) / np.sqrt(len(d)))
t_nb = d.mean() / np.sqrt((1 / len(d) + 1.0) * d.var(ddof=1))     # Nadeau-Bengio, n_test/n_train = 1
s2 = ((diffs - diffs.mean(axis=1, keepdims=True)) ** 2).sum(axis=1)
t_5x2 = diffs[0, 0] / np.sqrt(s2.mean())                            # Dietterich, 5 ddl
print(f"ΔF1 moyen sur 10 plis = {d.mean():+.3f} (min {d.min():+.3f}, max {d.max():+.3f})")
print(f"t naïf      = {t_naif:5.2f}, p = {2 * stats.t.sf(abs(t_naif), 9):.2g}")
print(f"t corrigé   = {t_nb:5.2f}, p = {2 * stats.t.sf(abs(t_nb), 9):.2g}")
print(f"t 5x2cv     = {t_5x2:5.2f}, p = {2 * stats.t.sf(abs(t_5x2), 5):.2g}")
print(f"Wilcoxon    : p = {stats.wilcoxon(d).pvalue:.2g}")
Sur les 10 plis, LightGBM bat la LR brute de en moyenne (entre et selon le pli).
| Test | Statistique | p |
|---|---|---|
| t apparié naïf (9 ddl) | 20,82 | |
| t corrigé de Nadeau-Bengio (9 ddl) | 6,28 | 0,00014 |
| t 5x2cv de Dietterich (5 ddl) | 6,07 | 0,0018 |
| Wilcoxon signé des rangs | — | 0,002 |
Les quatre tests concluent dans le même sens, mais le t naïf est trois fois trop confiant (20,8 contre 6,3) : il traite 10 plis qui se chevauchent comme 10 expériences indépendantes. Ici, l’effet est assez grand pour que ça ne change pas la décision. Sur un écart plus fin, le t naïf déclarerait significatif ce qui ne l’est pas : c’est pour ça qu’on utilise le t corrigé ou le 5x2cv dans un mémoire.
Drift et comparaisons multiples
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)

# drift : le temps depuis le dernier accès, avant et après un changement de workload
reference = rng.exponential(10, 2000)          # semaine d'entraînement
meme_loi = rng.exponential(10, 2000)           # semaine suivante, rien n'a changé
derive = rng.exponential(12, 2000)             # nouveau workload : accès 20 % plus espacés
for nom, x in (("même loi", meme_loi), ("dérive", derive)):
    res = stats.ks_2samp(reference, x)
    print(f"{nom:<9} : D = {res.statistic:.3f}, p = {res.pvalue:.2g}")

# comparaisons multiples : 20 features de bruit pur testées contre le label
n_exp, m, alpha = 2000, 20, 0.05
au_moins_un, au_moins_un_bonf = 0, 0
for _ in range(n_exp):
    label = rng.binomial(1, 0.3, 200)
    bruit = rng.normal(size=(200, m))
    p = np.array([stats.ttest_ind(bruit[label == 1, j], bruit[label == 0, j]).pvalue for j in range(m)])
    au_moins_un += (p < alpha).any()
    au_moins_un_bonf += (p < alpha / m).any()
print(f"au moins un faux positif : {au_moins_un / n_exp:.1%} (théorie {1 - (1 - alpha) ** m:.1%}) | "
      f"avec Bonferroni : {au_moins_un_bonf / n_exp:.1%}")
- Même loi : , , rien à signaler. Dérive de 20 % sur la moyenne : , , détectée avec 2 000 points par semaine.
- Comparaisons multiples : avec 20 features de bruit pur, 64,0 % des expériences trouvent au moins une feature « significative » (la théorie donne 64,2 %). Avec Bonferroni ( ), on retombe à 5,5 %.
Exercice pratique
- À la main. Un modèle a une accuracy de 0,80. Combien d’exemples de test faut-il pour que la demi-largeur de l’intervalle de confiance à 95 % soit inférieure à 0,01 ? Et à 0,001 ?
- Un meilleur intervalle. Refais la simulation de couverture avec
et une vraie accuracy de 0,95. Compare la couverture de l’intervalle de Wald avec celle de l’intervalle de Wilson (
stats.binomtest(k, n).proportion_ci(method="wilson")). Lequel tient ses promesses ? - Bootstrap d’autres métriques. Sur le jeu de test du fil rouge, construis les intervalles bootstrap de la précision et du rappel de LightGBM. Lequel est le plus large, et pourquoi ? (Indice : sur combien d’exemples chacun est-il calculé ?)
- Peu de données. Refais le 5x2cv avec
make_regions(600, ...)au lieu de 5 000, pour LightGBM contre LR brute puis contre LR + features. Les conclusions tiennent-elles ? Que disent le t naïf et le t corrigé ? - Fil rouge. Sur le dataset de la partie 14, coupe la trace en deux moitiés temporelles et applique Kolmogorov-Smirnov à chaque feature. Combien de features dérivent au seuil 0,05, puis après Bonferroni ? Classe-les par plutôt que par .
Indice pour la question 1 : , soit environ 6 150 exemples. Pour 0,001, cent fois plus.
Ressources pour aller plus loin
- Dietterich, Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms (Neural Computation, 1998) : McNemar et 5x2cv.
- Nadeau et Bengio, Inference for the Generalization Error (Machine Learning, 2003) : le t corrigé.
- Efron et Tibshirani, An Introduction to the Bootstrap (1993).
- Demšar, Statistical Comparisons of Classifiers over Multiple Data Sets (JMLR, 2006) : Wilcoxon, Friedman et les comparaisons multiples.
- Wasserstein et Lazar, The ASA Statement on p-Values (2016) : ce qu’une p-valeur dit, et ce qu’elle ne dit pas.
Ce que tu dois savoir faire avant de passer à la suite
- Calculer l’erreur standard d’une accuracy et expliquer la décroissance en
- Construire un intervalle de confiance et dire correctement ce que « 95 % » signifie
- Construire un intervalle bootstrap pour une métrique sans formule (F1, AUC)
- Définir p-valeur, erreur de type I, erreur de type II et puissance
- Comparer deux modèles sur un même jeu de test avec un bootstrap apparié et McNemar
- Expliquer pourquoi le t-test naïf sur des plis est trop optimiste, et utiliser le t corrigé ou le 5x2cv
- Détecter un drift avec Kolmogorov-Smirnov et corriger des comparaisons multiples
Partie suivante : M10 · Descente de gradient et ses variantes. Comment on trouve concrètement le minimum de toutes ces fonctions de perte.