M10 · Descente de gradient et ses variantes
SGD, momentum, Adam et gradient boosting : comment on minimise réellement une fonction de perte, et pourquoi le learning rate compte tant.
Mastering AI · Required Maths · Semaine 4 (optimisation) · Partie 10
Objectif de l’étape
Depuis M4, tu sais calculer un gradient, et depuis M5, l’obtenir gratuitement par rétropropagation. Il reste à t’en servir : partir d’un point au hasard et descendre jusqu’au fond de la perte. C’est ce que fait en coulisses chaque fit() que tu as appelé, de la régression logistique au LSTM du mémoire.
À la fin de cet article, tu sauras :
- écrire la mise à jour de la descente de gradient et la justifier avec Taylor (M6) ;
- expliquer pourquoi le learning rate décide de tout, et reconnaître un pas trop petit, trop grand, ou « juste un peu trop grand » ;
- expliquer ce qu’apportent les gradients stochastiques et mini-batch, et pourquoi leur bruit oblige à baisser le learning rate ;
- écrire de mémoire momentum, RMSProp et Adam, et dire ce que chacun corrige ;
- voir le gradient boosting comme une descente de gradient dans un espace de fonctions ;
- implémenter tout ça en NumPy et vérifier ton Adam contre
torch.optim.Adam.
Notions clés
1. La descente de gradient
Intuition. Tu es en montagne dans le brouillard. Tu ne vois pas la vallée, seulement la pente sous tes pieds. Le gradient pointe vers le haut (M4) : fais un petit pas dans l’autre sens, et recommence.
est le learning rate (pas d’apprentissage). Pourquoi ça marche ? Le développement de Taylor d’ordre 2 (M6), avec et la hessienne, donne :
Le deuxième terme fait toujours baisser la perte ; le troisième, dû à la courbure, la fait remonter. Pour assez petit, le terme linéaire l’emporte et la perte diminue. Comme , un pas suffit à garantir la baisse sur une quadratique : c’est le pas maximal de M6.
2. Le learning rate : l’hyperparamètre le plus important
Intuition. Trop petit, tu avances à pas de fourmi. Trop grand, tu rebondis d’un bord à l’autre de la vallée, ou tu en es éjecté.
M6 a donné les deux résultats clés sur une quadratique de conditionnement :
- convergence seulement si ;
- même avec le meilleur pas, l’erreur ne diminue que d’un facteur par itération.
Sur une fonction non convexe, est la courbure locale, qui change en chemin. Prends la fonction de Rosenbrock, banc d’essai classique de l’optimisation :
Son minimum est en , au fond d’une vallée courbe et étroite. Là, la hessienne a pour valeurs propres et : , et le pas maximal vaut . On verra qu’avec , à peine 5 % de trop, la descente n’atteint jamais le minimum : elle finit par rebondir sur les parois.
C’est aussi pour ça qu’on standardise les features (partie 14) : des features d’échelles très différentes donnent une hessienne mal conditionnée, donc un pas maximal minuscule et une descente qui se traîne dans les directions plates. On le mesure sur le fil rouge plus bas.
3. Gradients stochastiques et mini-batch
Intuition. La perte est une moyenne sur exemples, donc son gradient aussi. Pour décider de la direction, pas besoin de sonder les exemples : un échantillon aléatoire de d’entre eux donne une bonne estimation, fois moins chère.
Avec un mini-batch tiré au hasard, est un estimateur sans biais du vrai gradient (M7 : son espérance vaut ), et sa variance diminue en (M9 : l’erreur standard décroît en ).
- Descente de gradient complète ( ) : un pas précis par passage sur les données (une époque).
- SGD ( ) et mini-batch ( à typiquement) : beaucoup de pas approximatifs par époque. Sur de gros jeux de données, c’est bien plus rapide pour s’approcher du minimum.
Le prix : avec constant, le bruit ne disparaît jamais. Près du minimum, le vrai gradient tend vers 0 mais non : on tremble autour du minimum, à une distance qui grandit avec et diminue avec . Deux remèdes : faire décroître au cours du temps (un schedule : décroissance par paliers, cosinus, warm-up linéaire puis décroissance), ou augmenter . La théorie classique (Robbins et Monro, 1951) demande (aller assez loin) et (finir par s’arrêter).
Ce bruit a aussi une vertu : il aide à sortir des points selles (M6) et des zones plates, où le gradient exact est presque nul.
4. Le momentum
Intuition. Une bille qui dévale une vallée prend de la vitesse dans la direction où la pente est constante, et son inertie annule les allers-retours d’une paroi à l’autre.
est une accumulation des gradients passés, avec un facteur d’oubli (typiquement ). Si le gradient pointe toujours dans le même sens, grandit jusqu’à : le pas effectif vaut , soit 10 fois plus avec . S’il change de signe à chaque pas (le zigzag d’une vallée mal conditionnée), les contributions s’annulent. Le momentum accélère donc les directions plates sans faire exploser les directions pentues. Sur une quadratique, un bon choix de et fait passer le facteur à : avec , c’est 0,96 par pas au lieu de 0,9992.
La variante de Nesterov calcule le gradient au point où le momentum va t’emmener, , plutôt qu’en : elle anticipe un peu le virage.
5. RMSProp et Adam : un pas par coordonnée
Intuition. Un seul learning rate pour tous les paramètres est un mauvais compromis quand les gradients ont des échelles très différentes d’une coordonnée à l’autre. Idée : diviser chaque coordonnée par la taille typique de ses gradients récents. Les coordonnées aux gros gradients sont freinées, les timides sont poussées.
RMSProp (Hinton, 2012) garde une moyenne mobile des carrés des gradients et divise par sa racine. Adam (Kingma et Ba, 2015) y ajoute le momentum :
avec par défaut , , ; les opérations sur les vecteurs se font coordonnée par coordonnée.
- est le momentum (moyenne des gradients), la moyenne de leurs carrés (une estimation de leur échelle).
- et corrigent le biais dû à l’initialisation à 0 : à , serait sinon 10 fois trop petit.
- Le rapport vaut à peu près entre et : chaque coordonnée bouge d’environ par pas, quelle que soit l’échelle de son gradient. C’est ce qui rend Adam beaucoup moins sensible aux features mal mises à l’échelle, et est un défaut raisonnable presque partout.
Le revers : comme le pas reste proche de même quand le gradient devient minuscule, Adam à constant ne se pose pas proprement au minimum. Tu le verras sur la figure plus bas. En pratique, on l’associe à un schedule décroissant. Et pour régulariser, on utilise AdamW, qui applique le weight decay en dehors de la normalisation par (M11).
6. Le gradient boosting : une descente de gradient sur des fonctions
Intuition. Au lieu de déplacer un vecteur de paramètres , on déplace les prédictions elles-mêmes. À chaque étape, on calcule dans quel sens chaque prédiction devrait bouger pour faire baisser la perte, puis on ajuste un petit arbre qui pointe à peu près dans ce sens.
Note le score du modèle (le log-odds, en classification). La perte dépend des valeurs ; son gradient par rapport à ces valeurs se calcule exemple par exemple. Pour la log-loss (M8), avec :
Le gradient négatif est simplement le résidu « label moins probabilité prédite ». Le gradient boosting fait alors :
(le learning_rate de LightGBM et XGBoost) joue exactement le rôle de
. La différence avec la section 1 : on ne peut pas déplacer librement chaque
(ce serait apprendre le jeu d’entraînement par cœur), donc on projette le pas sur ce qu’un petit arbre sait représenter, ce qui généralise aux nouveaux exemples.
LightGBM va un cran plus loin : il utilise le gradient et la dérivée seconde pour calculer la valeur de chaque feuille, . C’est un pas de Newton (M6) par feuille : il converge bien plus vite que les résidus seuls, comme tu le verras à l’exercice 5.
Exemple de code
GD, momentum, Adam et SGD bruité sur Rosenbrock
Tous les optimiseurs sont écrits avec la même signature : ils reçoivent le gradient, la position, le pas et leur état interne, et renvoient la nouvelle position et le nouvel état.
import numpy as np


def rosenbrock(p):
    x, y = p
    return (1 - x) ** 2 + 100 * (y - x ** 2) ** 2


def grad_rosenbrock(p):
    x, y = p
    return np.array([-2 * (1 - x) - 400 * x * (y - x ** 2), 200 * (y - x ** 2)])


def sgd(g, p, eta, etat, t):
    return p - eta * g, None


def momentum(g, p, eta, etat, t, beta=0.9):
    v = g if etat is None else beta * etat + g          # vitesse : somme des gradients passés
    return p - eta * v, v


def adam(g, p, eta, etat, t, b1=0.9, b2=0.999, eps=1e-8):
    m, v = (np.zeros_like(p), np.zeros_like(p)) if etat is None else etat
    m = b1 * m + (1 - b1) * g                           # moyenne mobile des gradients
    v = b2 * v + (1 - b2) * g ** 2                      # moyenne mobile des carrés
    m_hat, v_hat = m / (1 - b1 ** t), v / (1 - b2 ** t) # correction du biais
    return p - eta * m_hat / (np.sqrt(v_hat) + eps), (m, v)


def lancer(pas, eta, n_pas=20_000, bruit=0.0, seed=0):
    """Optimise depuis (-1.2, 1). bruit > 0 simule un gradient stochastique."""
    rng = np.random.default_rng(seed)
    p, etat, chemin = np.array([-1.2, 1.0]), None, []
    for t in range(1, n_pas + 1):
        g = grad_rosenbrock(p) + bruit * rng.normal(size=2)
        p, etat = pas(g, p, eta, etat, t)
        chemin.append(p.copy())
    return np.array(chemin)


essais = {
    "GD, eta = 0.001": lancer(sgd, 1e-3),
    "GD, eta = 0.0021": lancer(sgd, 2.1e-3),
    "momentum 0.9, eta = 0.001": lancer(momentum, 1e-3),
    "Adam, eta = 0.01": lancer(adam, 1e-2),
    "SGD bruité, eta = 0.001": lancer(sgd, 1e-3, bruit=10.0),
}
for nom, chemin in essais.items():
    dist = np.linalg.norm(chemin - 1.0, axis=1)        # distance au minimum (1, 1)
    premier = int(np.argmax(dist < 1e-3)) + 1 if (dist < 1e-3).any() else "jamais"
    print(f"{nom:<26} f(θ_20000) = {rosenbrock(chemin[-1]):.1e} | premier pas à < 1e-3 : {premier:>6} | "
          f"distance moyenne (1 000 derniers pas) = {dist[-1000:].mean():.1e}")
Après 20 000 pas depuis :
| Optimiseur | après 20 000 pas | Premier pas à moins de du minimum | Distance moyenne sur les 1 000 derniers pas |
|---|---|---|---|
| GD, | 17 082 | ||
| GD, | jamais | ||
| Momentum 0,9, | 1 580 | ||
| Adam, | 4 409 | ||
| SGD bruité, | 13 180 (par hasard) |
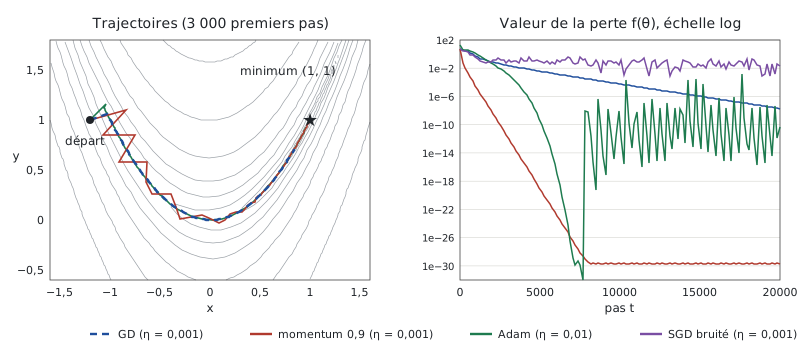
Ce qu’il faut retenir :
- La GD simple trouve vite la vallée, puis s’y traîne : il lui faut 17 082 pas pour arriver à du minimum. C’est la direction plate ( ), qu’on ne peut pas accélérer sans faire exploser la direction pentue ( ).
- 5 % de trop suffisent à échouer. Avec , la GD ne converge jamais : au fond de la vallée, elle rebondit sur les parois et reste bloquée à . Rien ne diverge de façon spectaculaire : c’est un échec silencieux, de ceux qu’on ne voit qu’en traçant la perte.
- Le momentum zigzague au début (la figure de gauche), puis sa vitesse accumulée l’emporte le long de la vallée : à en 1 580 pas, plus de 10 fois plus vite que la GD au même , et jusqu’à la précision machine ensuite.
- Adam s’approche en 4 409 pas, puis oscille : la courbe de droite montre des pics entre et . Près du minimum, les gradients deviennent minuscules, suit lentement (mémoire de 1 000 pas), et le rapport lui fait refaire des pas de taille environ. D’où l’intérêt d’un schedule décroissant.
- Le SGD bruité (bruit gaussien d’écart-type 10 ajouté au gradient) descend la vallée mais reste à une distance moyenne de 0,11 du minimum : c’est le plancher de bruit d’un learning rate constant. Il est passé à moins de une fois, au pas 13 180, par hasard, sans y rester.
Fil rouge : entraîner une régression logistique à la main
On reprend les régions mémoire synthétiques de M9 et la régression logistique avec features métier (log des accès, interaction « périodique et pic imminent »). Cette fois, on l’entraîne nous-mêmes, en comparant les optimiseurs à nombre d’époques égal (passages sur les 3 500 régions d’entraînement), la mesure honnête du coût de calcul.
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import log_loss
from sklearn.model_selection import train_test_split


def make_regions(n, rng):
    """Régions mémoire synthétiques (même générateur que M9) : label 1 = chaude dans la prochaine fenêtre."""
    taux = rng.gamma(0.6, 4, n)
    acces_recents = rng.poisson(taux)
    depuis_dernier = np.round(rng.exponential(30 / (1 + acces_recents)), 1)
    periodique = rng.binomial(1, 0.25, n)
    avant_pic = rng.integers(0, 12, n)
    logit = (0.9 * np.log1p(acces_recents) - 0.05 * depuis_dernier
             + 3.0 * periodique * (avant_pic < 3) - 1.5 + rng.normal(0, 0.8, n))
    X = np.column_stack([acces_recents, depuis_dernier, periodique, avant_pic])
    return X, (logit > 0).astype(int)


def features_metier(X):
    return np.column_stack([np.log1p(X[:, 0]), X[:, 1], X[:, 2], X[:, 2] * (X[:, 3] < 3)])


rng = np.random.default_rng(0)
X, y = make_regions(5000, rng)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
Ftr = features_metier(Xtr)
Ztr = (Ftr - Ftr.mean(axis=0)) / Ftr.std(axis=0)          # features standardisées
A_brut = np.column_stack([np.ones(len(Ftr)), Ftr])        # colonne de 1 = intercept
A_std = np.column_stack([np.ones(len(Ztr)), Ztr])


def perte_grad(w, A, y):
    """Log-loss moyenne d'une régression logistique (M8) et son gradient."""
    p = np.clip(1 / (1 + np.exp(-(A @ w))), 1e-12, 1 - 1e-12)
    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p)), A.T @ (p - y) / len(y)


# optimum de référence (sans régularisation)
ref = LogisticRegression(C=np.inf, max_iter=10_000, tol=1e-10).fit(Ztr, ytr)
L_star = log_loss(ytr, ref.predict_proba(Ztr)[:, 1])
print(f"log-loss optimale (sklearn) = {L_star:.4f}")

# conditionnement : en w = 0, la hessienne vaut Aᵀ A / (4n)
for nom, A in (("brutes", A_brut), ("standardisées", A_std)):
    vp = np.linalg.eigvalsh(A.T @ A / (4 * len(A)))
    print(f"{nom:<14}: λ_max = {vp[-1]:.3g}, λ_min = {vp[0]:.3g}, conditionnement = {vp[-1] / vp[0]:.0f}")


def entrainer(A, y, optimiseur, eta, epoques=200, batch=None, seed=0):
    """Renvoie la log-loss d'entraînement (tout le jeu) après chaque époque."""
    rng = np.random.default_rng(seed)
    n, w = len(y), np.zeros(A.shape[1])
    m, v, t, historique = np.zeros_like(w), np.zeros_like(w), 0, []
    for _ in range(epoques):
        ordre = rng.permutation(n)
        for debut in range(0, n, batch or n):          # batch=None : un pas par époque (GD complète)
            i = ordre[debut:debut + (batch or n)]
            _, g = perte_grad(w, A[i], y[i])
            t += 1
            if optimiseur == "sgd":
                w -= eta * g
            else:                                      # adam
                m = 0.9 * m + 0.1 * g
                v = 0.999 * v + 0.001 * g ** 2
                w -= eta * (m / (1 - 0.9 ** t)) / (np.sqrt(v / (1 - 0.999 ** t)) + 1e-8)
        historique.append(perte_grad(w, A, y)[0])
    return np.array(historique)


configs = {
    "GD, brutes, eta = 0.005": (A_brut, "sgd", 0.005, None),
    "GD, brutes, eta = 0.2": (A_brut, "sgd", 0.2, None),
    "GD, standardisées, eta = 4": (A_std, "sgd", 4.0, None),
    "SGD b=32, standardisées, eta = 0.1": (A_std, "sgd", 0.1, 32),
    "SGD b=32, standardisées, eta = 0.3": (A_std, "sgd", 0.3, 32),
    "Adam b=32, brutes, eta = 0.003": (A_brut, "adam", 0.003, 32),
    "Adam b=32, standardisées, eta = 0.01": (A_std, "adam", 0.01, 32),
}
for nom, (A, opt, eta, batch) in configs.items():
    h = entrainer(A, ytr, opt, eta, batch=batch)
    ecart = h - L_star
    atteint = int(np.argmax(ecart < 1e-3)) + 1 if (ecart < 1e-3).any() else "jamais"
    print(f"{nom:<37} perte après 1 / 10 / 200 époques = {h[0]:.4f} / {h[9]:.4f} / {h[-1]:.4f} | "
          f"écart < 0,001 à l'époque {atteint}")
L’optimum calculé par scikit-learn est une log-loss de 0,2692. D’abord, le conditionnement en :
| Features | |||
|---|---|---|---|
| brutes | 204 | 0,011 | 18 565 |
| standardisées | 0,367 | 0,132 | 3 |
Le temps depuis le dernier accès monte jusqu’à 206 alors que les autres features restent entre 0 et 3,5 : la hessienne est 18 565 fois plus pentue dans une direction que dans une autre. Après standardisation, .
| Optimiseur (200 époques) | Perte après 1 époque | après 10 | après 200 | À 0,001 de l’optimum à l’époque |
|---|---|---|---|---|
| GD, brutes, | 0,5288 | 0,4586 | 0,4407 | jamais |
| GD, brutes, | 1,5607 | 0,4348 | 0,3416 | jamais |
| GD, standardisées, | 0,3403 | 0,2799 | 0,2692 | 57 |
| SGD , standardisées, | 0,3246 | 0,2733 | 0,2693 | 23 |
| SGD , standardisées, | 0,2853 | 0,2701 | 0,2698 | 10 |
| Adam , brutes, | 0,4255 | 0,3224 | 0,2692 | 54 |
| Adam , standardisées, | 0,3644 | 0,2715 | 0,2696 | 13 |
Quatre leçons, toutes prévues par la théorie :
- Sans standardisation, la GD est coincée. Avec , elle est stable mais encore à 0,44 après 200 époques. Avec , la première époque déborde (perte 1,56) ; la courbure de la logistique baisse quand s’éloigne de 0,5, donc elle survit, mais reste à 0,34. La direction plate ( ) n’avance presque pas.
- Standardiser change tout : la même GD atteint l’optimum en 57 époques, avec un pas de 4 qui serait absurde sur les features brutes.
- Le mini-batch rentabilise chaque époque : le SGD avec fait 110 pas par époque au lieu d’un et arrive à 0,001 de l’optimum en 10 à 23 époques. Mais avec , il reste ensuite à 0,2698 au lieu de descendre à 0,2692 : c’est le plancher de bruit, et la raison d’être d’un schedule décroissant (exercice 4).
- Adam pardonne une mauvaise échelle : sur les features brutes, il atteint l’optimum (0,2692) là où la GD cale, parce que chaque coordonnée a son propre pas. Standardiser reste une bonne pratique, mais ce n’est plus une question de vie ou de mort.
Le gradient boosting à la main
On code maintenant la descente de gradient fonctionnelle de la section 6 : chaque arbre ajuste les résidus , et on fait un pas dans sa direction.
# suite du bloc précédent (make_regions déjà défini)
from sklearn.metrics import f1_score
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(0)
X, y = make_regions(5000, rng)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)

sigmoide = lambda f: 1 / (1 + np.exp(-f))
nu = 0.1                                               # shrinkage = learning rate dans l'espace des fonctions
F_tr = np.full(len(ytr), np.log(ytr.mean() / (1 - ytr.mean())))   # F_0 : log-odds constant
F_te = np.full(len(yte), F_tr[0])
for m in range(1, 201):
    residu = ytr - sigmoide(F_tr)                      # = −∂(log-loss)/∂F : le gradient négatif
    arbre = DecisionTreeRegressor(max_depth=3, random_state=0).fit(Xtr, residu)
    F_tr += nu * arbre.predict(Xtr)                    # un pas de gradient... sur une fonction
    F_te += nu * arbre.predict(Xte)
    if m in (1, 10, 50, 200):
        print(f"{m:>3} arbres : log-loss d'entraînement = {log_loss(ytr, sigmoide(F_tr)):.4f} | "
              f"F1 de test = {f1_score(yte, (F_te > 0).astype(int)):.3f}")
| Arbres | Log-loss d’entraînement | F1 de test |
|---|---|---|
| 1 | 0,5200 | 0,000 |
| 10 | 0,4708 | 0,000 |
| 50 | 0,3694 | 0,404 |
| 200 | 0,2954 | 0,680 |
Vingt lignes de code, sur les features brutes, sans feature engineering, et on obtient un F1 de test de 0,680, au niveau de LightGBM en M9 (0,681 sur le même jeu de test). Les 10 premiers arbres ne prédisent aucune région chaude (F1 = 0) : les résidus seuls sont petits (moins de 1 en valeur absolue), donc avec les scores s’éloignent lentement du log-odds de départ, environ , et restent sous le seuil de 0. C’est la lenteur des pas du premier ordre ; le pas de Newton de LightGBM l’accélère (exercice 5).
Exercice pratique
- À la main. Sur avec , quel est le facteur de réduction de l’erreur par pas sur chaque axe ? Combien de pas faut-il pour diviser l’erreur par ? Que changerait le momentum ?
- Recode Adam et vérifie-le contre PyTorch. Fais tourner ton
adamNumPy (enfloat64) ettorch.optim.Adam(lr=0.01)pendant 1 000 pas sur Rosenbrock depuis , avec l’autograd pour le gradient côté torch. Les positions finales doivent coïncider à environ près. Retrouve ensuite la ligne de la documentation PyTorch qui correspond à la correction du biais. - Régler le momentum. Sur Rosenbrock, essaie avec . Combien de pas pour arriver à du minimum ? Que se passe-t-il avec , et comment l’expliques-tu avec le pas effectif ?
- Schedule. Dans le fil rouge, prends le SGD , et remplace le pas constant par , où compte les pas. La perte finale passe-t-elle sous le plancher de bruit (0,2698) ? Essaie ensuite à pas constant.
- Boosting de Newton. Remplace les valeurs des feuilles du code de boosting par le pas de Newton : pour chaque feuille,
(utilise
arbre.applypour savoir dans quelle feuille tombe chaque exemple). Combien d’arbres faut-il pour dépasser un F1 de 0,6 ?
Indice pour la question 1 : le facteur vaut , soit 0,9 et 0. Il faut pas, entièrement à cause de l’axe plat.
Ressources pour aller plus loin
- Sebastian Ruder, An overview of gradient descent optimization algorithms (2016) : toutes les variantes sur une page, avec les équations.
- Gabriel Goh, Why Momentum Really Works (Distill, 2017) : le momentum en images interactives, et la démonstration du .
- Kingma et Ba, Adam: A Method for Stochastic Optimization (ICLR 2015) ; Loshchilov et Hutter, Decoupled Weight Decay Regularization (ICLR 2019) pour AdamW.
- Friedman, Greedy Function Approximation: A Gradient Boosting Machine (Annals of Statistics, 2001) : l’article fondateur du gradient boosting.
- Goodfellow, Bengio et Courville, Deep Learning, chapitre 8 (optimisation pour l’entraînement des modèles profonds), gratuit en ligne.
Ce que tu dois savoir faire avant de passer à la suite
- Écrire la mise à jour de la descente de gradient et la justifier par le développement de Taylor
- Expliquer le pas maximal et l’effet du conditionnement, et pourquoi on standardise
- Expliquer pourquoi un mini-batch donne un gradient sans biais mais bruité, et pourquoi on baisse le learning rate en fin d’entraînement
- Implémenter SGD, momentum et Adam en NumPy (Adam conforme à
torch.optim.Adam) - Expliquer ce que corrigent le momentum et la normalisation par coordonnée d’Adam
- Décrire le gradient boosting comme une descente de gradient sur les prédictions, avec les résidus comme gradient négatif
Partie suivante : M11 · Contraintes et régularisation vues géométriquement. Pourquoi L1 produit des zéros et L2 non, vu comme une contrainte sur la zone que la descente de gradient a le droit d’explorer.