M8 · Vraisemblance, Bayes et entropie
D'où viennent la MSE, la cross-entropie, la régularisation L2 et le gain d'information des arbres : les fonctions de perte vues comme des probabilités.
Mastering AI · Required Maths · Semaine 3 (probabilités et statistiques) · Partie 8
Objectif de l’étape
Jusqu’ici, on a pris la MSE et la log-loss comme des données. Elles ne tombent pas du ciel : elles découlent d’une seule idée, le maximum de vraisemblance. Avec le théorème de Bayes et la notion d’entropie, on obtient aussi la régularisation et le critère de découpage des arbres de décision.
À la fin de cet article, tu sauras :
- appliquer le théorème de Bayes et expliquer l’effet de l’a priori ;
- estimer un paramètre par maximum de vraisemblance ;
- dériver la MSE d’un bruit gaussien et la cross-entropie d’un label de Bernoulli ;
- interpréter la régularisation comme un a priori gaussien (MAP) ;
- calculer entropie, cross-entropie, divergence KL et gain d’information.
Notions clés
1. Le théorème de Bayes
Intuition. On connaît souvent (« si la région est froide, mon détecteur le dit dans 95 % des cas ») mais on veut (« le détecteur dit froide : quelle chance qu’elle le soit vraiment ? »). Bayes retourne la flèche, à condition de connaître la fréquence de base, l’a priori.
Exemple fil rouge : 70 % des régions sont froides. Un détecteur dit « froide » pour 95 % des régions froides et, par erreur, pour 20 % des chaudes. Quand il dit « froide », la probabilité que la région soit en fait chaude (un faux froid) est :
Le même détecteur, sur un workload où seulement 20 % des régions sont froides, donne 46 % de faux froids. La qualité d’un classifieur ne se lit jamais sans la fréquence de base : on le reverra en partie 15 avec la précision.
2. La vraisemblance
Intuition. On a des données et un modèle avec un paramètre . La vraisemblance est la probabilité d’avoir observé exactement ces données si le paramètre valait . Le maximum de vraisemblance (MLE) choisit le qui rend les données les plus probables.
Pour des observations indépendantes, la vraisemblance est un produit, qu’on transforme en somme avec le logarithme (plus stable numériquement, et même maximum) :
Exemple : des comptages d’accès supposés suivre une loi de Poisson( ). En annulant la dérivée de la log-vraisemblance, on trouve : l’estimateur du maximum de vraisemblance est la moyenne empirique.
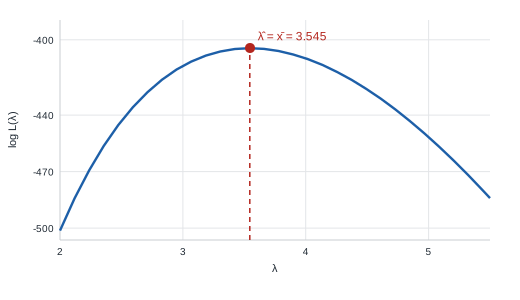
Minimiser une perte, c’est maximiser une vraisemblance. En ML, on écrit tout comme une minimisation : la perte est la log-vraisemblance négative (NLL) moyenne.
3. Bruit gaussien ⇒ MSE
Hypothèse : avec un bruit indépendant. La NLL vaut :
Pour fixé, seul le second terme dépend de : c’est la somme des carrés des erreurs. Maximiser la vraisemblance gaussienne revient exactement à minimiser la MSE. Et l’estimateur de est la racine de la MSE.
Corollaire : la MSE suppose un bruit symétrique, sans valeurs extrêmes. Avec des valeurs aberrantes, une loi de Laplace donne la perte (MAE), plus robuste.
4. Label de Bernoulli ⇒ cross-entropie
Hypothèse : suit une loi de Bernoulli de paramètre . La probabilité d’un label s’écrit , d’où :
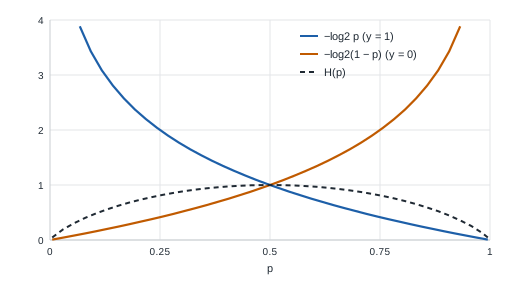
C’est exactement la log-loss (ou cross-entropie binaire) de la régression logistique. Elle punit très fort une prédiction confiante et fausse : prédire pour une région qui sera accédée coûte bits.
5. MAP : la régularisation comme a priori
Intuition. Avant de voir les données, on peut avoir une opinion : « les poids sont probablement petits ». Bayes permet de combiner cet a priori avec la vraisemblance. On maximise alors la probabilité a posteriori (MAP) :
Avec un a priori gaussien , on a : on retrouve la régularisation (Ridge), avec . Un a priori de Laplace donnerait (Lasso). La régularisation, ce n’est pas une astuce : c’est une croyance a priori sur les poids (M11, partie 16).
6. Entropie, cross-entropie et divergence KL
Intuition. L’entropie mesure l’incertitude d’une loi, en bits : le nombre moyen de questions oui/non nécessaires pour deviner le résultat. Une pièce équilibrée vaut 1 bit, une pièce truquée qui tombe toujours sur pile vaut 0.
La cross-entropie mesure le coût moyen quand la vérité suit mais qu’on code (ou prédit) avec . L’écart est la divergence de Kullback-Leibler :
La KL est nulle si et seulement si , et elle n’est pas symétrique. Comme ne dépend pas du modèle, minimiser la cross-entropie revient à minimiser la KL entre la vraie loi des labels et celle que prédit le modèle.
7. Le gain d’information des arbres
Un arbre de décision (partie 17) choisit, à chaque nœud, le découpage qui réduit le plus l’entropie des labels :
Un découpage qui sépare bien les régions chaudes des froides produit des enfants « purs », d’entropie faible, donc un gain élevé.
Exemple de code
Bayes et le poids de l’a priori
p_froide = 0.70             # a priori : 70 % des régions sont froides (Zipf)
p_dit_froide_si_froide = 0.95
p_dit_froide_si_chaude = 0.20
p_dit_froide = p_dit_froide_si_froide * p_froide + p_dit_froide_si_chaude * (1 - p_froide)
p_chaude_si_dit_froide = p_dit_froide_si_chaude * (1 - p_froide) / p_dit_froide
print(f"P(dit froide) = {p_dit_froide:.3f} | P(en fait chaude | dit froide) = {p_chaude_si_dit_froide:.3f}")
for prior in (0.9, 0.5, 0.2):
    pdf = p_dit_froide_si_froide * prior + p_dit_froide_si_chaude * (1 - prior)
    print(f"  a priori froide = {prior:.1f} -> P(chaude | dit froide) = {p_dit_froide_si_chaude * (1 - prior) / pdf:.3f}")
| Part de régions froides | |
|---|---|
| 90 % | 2,3 % |
| 70 % | 8,3 % |
| 50 % | 17,4 % |
| 20 % | 45,7 % |
Même détecteur, mêmes taux d’erreur : la proportion de faux froids parmi les régions déclarées froides passe de 2 % à 46 % selon le workload.
Maximum de vraisemblance : Poisson, gaussienne et Ridge
import numpy as np
from scipy.optimize import minimize, minimize_scalar
from scipy.special import gammaln

rng = np.random.default_rng(0)

# 1. Poisson : le MLE de λ est la moyenne
acces = rng.poisson(3.2, 200)
nll_poisson = lambda lam: -np.sum(acces * np.log(lam) - lam - gammaln(acces + 1))
res = minimize_scalar(nll_poisson, bounds=(0.1, 10), method="bounded")
print(f"Poisson : λ MLE numérique = {res.x:.4f} | moyenne empirique = {acces.mean():.4f}")

# 2. Bruit gaussien => MSE
n, d = 300, 3
X = rng.normal(size=(n, d))
y = X @ np.array([2.0, -1.0, 0.5]) + rng.normal(0, 0.5, n)

def nll_gauss(params):
    w, log_sigma = params[:d], params[d]
    sigma2 = np.exp(2 * log_sigma)
    r = y - X @ w
    return 0.5 * n * np.log(2 * np.pi * sigma2) + (r @ r) / (2 * sigma2)

opt = minimize(nll_gauss, np.zeros(d + 1))
w_mc = np.linalg.lstsq(X, y, rcond=None)[0]
print(f"w MLE gaussien    : {opt.x[:d].round(4)} | σ MLE = {np.exp(opt.x[d]):.4f}")
print(f"w moindres carrés : {w_mc.round(4)} | √(MSE) = {np.sqrt(np.mean((y - X @ w_mc) ** 2)):.4f}")

# 3. MAP avec a priori gaussien => Ridge
lam = 10.0
w_ridge = np.linalg.solve(X.T @ X + lam * np.eye(d), X.T @ y)
w_map = minimize(lambda w: np.sum((y - X @ w) ** 2) + lam * w @ w, np.zeros(d)).x
print(f"Ridge (forme fermée) : {w_ridge.round(4)} | MAP numérique : {w_map.round(4)}")
| Méthode | Résultat |
|---|---|
| MLE Poisson (optimisation numérique) | |
| Moyenne empirique | |
| MLE gaussien | , |
| Moindres carrés | , |
| Ridge, forme fermée ( ) | |
| MAP numérique, a priori gaussien |
Trois paires de méthodes, trois coïncidences exactes : le MLE de Poisson est la moyenne, le MLE gaussien est la solution des moindres carrés, et le MAP gaussien est la régression Ridge. Remarque aussi que Ridge rétrécit tous les poids vers 0, comme le prévoit l’a priori.
Entropie, KL et gain d’information
import numpy as np


def H(p):
    p = np.asarray(p, float)
    p = p[p > 0]
    return -np.sum(p * np.log2(p))


def CE(p, q):
    return -np.sum(np.asarray(p) * np.log2(q))


def KL(p, q):
    return CE(p, q) - H(p)


p = np.array([0.7, 0.2, 0.1])
q = np.array([0.2, 0.3, 0.5])
print(f"H(p) = {H(p):.3f} bits | H(uniforme sur 3) = {H([1/3] * 3):.3f} bits")
print(f"CE(p, q) = {CE(p, q):.3f} = H(p) + KL(p||q) = {H(p):.3f} + {KL(p, q):.3f}")
print(f"KL(p||q) = {KL(p, q):.3f} | KL(q||p) = {KL(q, p):.3f}")

# gain d'information d'un découpage sur 100 régions (30 chaudes, 70 froides)
y_noeud = np.array([1] * 30 + [0] * 70)
gauche = np.array([1] * 27 + [0] * 8)                   # depuis_dernier < seuil
droite = np.array([1] * 3 + [0] * 62)
Hb = lambda v: H([v.mean(), 1 - v.mean()])
gain = Hb(y_noeud) - (len(gauche) * Hb(gauche) + len(droite) * Hb(droite)) / len(y_noeud)
print(f"entropie du nœud {Hb(y_noeud):.3f} | gauche {Hb(gauche):.3f} | droite {Hb(droite):.3f} | gain {gain:.3f} bits")
- bit, contre pour la loi uniforme sur 3 valeurs (le maximum possible) : est assez prévisible.
- : la cross-entropie est bien l’entropie plus la KL.
- mais : la KL n’est pas une distance symétrique.
- Le découpage fait passer l’entropie de bit (nœud) à (gauche) et (droite) : un gain de bit. La branche droite (62 froides, 3 chaudes) est presque pure.
Exercice pratique
- Bayes à la main. Un test de détection a une sensibilité de 99 % et une spécificité de 99 %. Si la condition touche 1 personne sur 1 000, quelle est la probabilité d’être concerné quand le test est positif ? Vérifie par simulation.
- MLE de Bernoulli. Pour
observations 0/1, écris la log-vraisemblance de
et montre que
est la proportion de 1. Vérifie avec
minimize_scalar. - Laplace et MAE. Montre que si le bruit suit une loi de Laplace, la NLL est proportionnelle à
. Ajoute 5 valeurs aberrantes dans
yet compare les poids obtenus par MSE et par MAE (scipy.optimize.minimize). - La KL n’est pas symétrique. Trouve deux lois et sur 2 valeurs pour lesquelles et diffèrent d’un facteur au moins 3.
- Fil rouge. Sur le dataset de la partie 14, calcule le gain d’information du découpage
depuis_dernier < spour plusieurs seuils . Quel seuil maximise le gain ? Compare avec le premier découpage d’unDecisionTreeClassifier(criterion="entropy", max_depth=1).
Indice pour la question 1 : la réponse est autour de 9 %, pas 99 %.
Ressources pour aller plus loin
- Bishop, Pattern Recognition and Machine Learning, chapitres 1 et 2 : vraisemblance, MAP et Bayes appliqués au ML.
- Murphy, Probabilistic Machine Learning: An Introduction, chapitres 4 et 6 (estimation et théorie de l’information), gratuit en ligne.
- 3Blue1Brown, Bayes theorem, the geometry of changing beliefs (vidéo).
- Christopher Olah, Visual Information Theory (blog colah.github.io).
Ce que tu dois savoir faire avant de passer à la suite
- Appliquer Bayes et expliquer l’effet de la fréquence de base
- Écrire une log-vraisemblance et trouver son maximum
- Dériver la MSE d’un bruit gaussien et la log-loss d’un label de Bernoulli
- Expliquer la régularisation comme un a priori gaussien
- Calculer entropie, cross-entropie et KL, et relier les trois
- Calculer le gain d’information d’un découpage
Partie suivante : M9 · Statistique inférentielle pour comparer des modèles. Comment affirmer, chiffres et intervalles de confiance à l’appui, qu’un modèle est meilleur qu’un autre.