M11 · Contraintes et régularisation vues géométriquement
Multiplicateurs de Lagrange, conditions KKT et géométrie des normes : pourquoi la régularisation L1 annule des poids, pourquoi L2 les rétrécit, et comment s'en servir pour choisir ses features.
Mastering AI · Required Maths · Semaine 4 (optimisation) · Partie 11
Objectif de l’étape
En M10, la descente de gradient avait le droit d’aller n’importe où. En pratique, on la retient souvent : on veut des poids petits, ou peu nombreux. Cet article montre que régulariser, c’est optimiser sous contrainte, et que la forme de la contrainte décide de tout. C’est la démonstration promise depuis M1 : pourquoi les pointes du losange mettent des poids exactement à zéro.
À la fin de cet article, tu sauras :
- résoudre un problème d’optimisation sous contrainte avec un multiplicateur de Lagrange, et interpréter ce multiplicateur comme le prix de la contrainte ;
- écrire les conditions KKT pour une contrainte d’inégalité et reconnaître une contrainte active ;
- expliquer pourquoi pénaliser par revient à imposer ;
- expliquer géométriquement, puis par le calcul, pourquoi annule des poids et les rétrécit ;
- lire un chemin de régularisation et t’en servir pour sélectionner des features sur le fil rouge ;
- situer les SVM et AdamW dans ce cadre.
Notions clés
1. Optimiser sous contrainte : les multiplicateurs de Lagrange
Intuition. Tu marches sur une colline, mais tu dois rester sur un sentier. Le point le plus bas du sentier n’est pas le fond de la vallée : c’est l’endroit où le sentier effleure une ligne de niveau sans la traverser. En ce point, la ligne de niveau et le sentier sont tangents, donc leurs normales sont alignées. Or la normale à une ligne de niveau, c’est le gradient (M4).
Pour minimiser sous la contrainte , la condition s’écrit :
Le nombre est le multiplicateur de Lagrange. On retrouve ces deux équations en annulant le gradient du lagrangien :
par rapport à et à : la contrainte n’est plus un obstacle, c’est une variable de plus.
Le prix de la contrainte. a un sens concret : si on desserre la contrainte de , la valeur optimale change d’environ . Un grand signifie que la contrainte coûte cher ; signifie qu’elle ne gêne pas.
Exemple : minimiser sous . Les deux équations donnent et , et la contrainte impose , d’où l’optimum et . On le vérifie en code plus bas.
La PCA était un problème de Lagrange. En M3, la première composante est la direction qui maximise la variance , avec . Le lagrangien donne en l’annulant :
Les points critiques sont les vecteurs propres de la covariance, et la variance atteinte vaut : le multiplicateur est la valeur propre.
2. Contraintes d’inégalité : les conditions KKT
Intuition. Avec une contrainte , deux cas seulement. Soit le minimum libre est déjà dans la zone autorisée : la contrainte ne sert à rien, elle est inactive. Soit il est dehors : l’optimum est alors sur le bord, la contrainte est active, et on retombe sur le cas de Lagrange.
Les conditions de Karush-Kuhn-Tucker (KKT) résument les deux cas :
La dernière ligne, la complémentarité, dit qu’un des deux facteurs est nul : soit (contrainte inactive, elle ne coûte rien), soit (contrainte active). Le signe traduit que la contrainte ne peut que gêner, jamais aider. Pour un problème convexe (M6), ces conditions sont nécessaires et suffisantes.
3. Pénalité ou contrainte : c’est la même chose
Intuition. Il y a deux façons de dire « je veux des poids petits » : interdire aux poids de sortir d’une boule de rayon , ou leur faire payer une amende proportionnelle à leur taille. Les conditions KKT montrent que ce sont deux écritures du même problème :
Pour un problème convexe, à chaque rayon correspond une pénalité qui donne la même solution, et réciproquement : est exactement le multiplicateur KKT de la contrainte. Plus est grand, plus la boule est petite. On le vérifie numériquement plus bas.
C’est aussi ce que disait M8 sous un autre angle : la pénalité est un a priori gaussien sur les poids, la pénalité un a priori de Laplace. Trois lectures, un seul objet : une boule, une amende, une croyance.
4. La géométrie : une ellipse qui touche une boule
Intuition. Près de son minimum, la perte ressemble à une parabole (Taylor, M6) : ses lignes de niveau sont des ellipses centrées sur le minimum sans contrainte. On gonfle l’ellipse jusqu’à ce qu’elle touche la boule autorisée. Le point de contact est la solution régularisée.
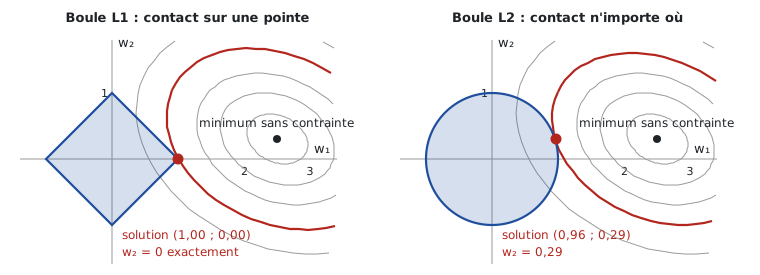
- La boule est ronde : l’ellipse peut la toucher n’importe où, et il n’y a aucune raison que ce soit pile sur un axe. Les poids sont rapprochés de 0, mais restent non nuls.
- La boule a des pointes sur les axes, c’est-à-dire là où une coordonnée vaut exactement 0. Une ellipse qui grossit a toutes les chances de heurter une pointe avant une arête. Sur la figure, le minimum libre est en : n’est pas nul sans contrainte, mais la solution le met exactement à 0.
En grande dimension, l’effet s’amplifie : le losange devient un polytope dont les sommets et les arêtes vivent sur des sous-espaces où beaucoup de coordonnées sont nulles. D’où des modèles parcimonieux : peu de poids non nuls.
5. Le même résultat par le calcul : seuillage doux contre division
Intuition. Regarde la pente de chaque pénalité près de 0. Celle de vaut : elle s’éteint quand approche de 0, donc le moindre signal dans les données suffit à garder un petit poids. Celle de vaut : elle pousse vers 0 avec une force constante. Si les données tirent moins fort que , le poids reste exactement à 0.
En une dimension, avec la solution des moindres carrés, on minimise plus la pénalité :
Pour , la valeur absolue n’est pas dérivable en 0 : on utilise son sous-gradient, l’intervalle . La condition d’optimalité en devient , c’est-à-dire . C’est le seuillage doux : tout ce qui est sous le seuil tombe à zéro, le reste est raboté de . divise tout par le même facteur et n’annule rien.
Cette formule est exacte en plusieurs dimensions quand les features sont orthogonales ( ). Dans le cas général, c’est l’étape de base des algorithmes qui résolvent le Lasso (descente par coordonnée, gradient proximal).
Une conséquence pratique : standardiser. La pénalité traite tous les poids de la même façon. Une feature exprimée en millisecondes a un poids minuscule, presque pas pénalisé ; la même feature en secondes aurait un poids 1 000 fois plus grand, écrasé par la pénalité. Sans standardisation, la régularisation dépend des unités : on standardise toujours avant (M1, partie 14).
6. Aperçu : les SVM et les vecteurs de support
Une SVM linéaire cherche l’hyperplan qui sépare les classes avec la plus grande marge. C’est un problème sous contraintes : minimiser sous pour chaque exemple , avec . Chaque contrainte a son multiplicateur , et la complémentarité KKT dit :
- les exemples loin de la frontière ont une contrainte inactive, donc : ils n’influencent pas la solution ;
- seuls les exemples sur la marge ont . Ce sont les vecteurs de support, et ne dépend que d’eux.
Les conditions KKT expliquent donc pourquoi une SVM se résume à quelques exemples. L’exercice 4 le vérifie.
7. Weight decay et AdamW
Avec la pénalité , le gradient gagne un terme et la mise à jour de M10 devient :
À chaque pas, les poids sont multipliés par un facteur un peu inférieur à 1 : c’est le weight decay. En SGD, pénalité et weight decay sont identiques. Avec Adam, non : si on ajoute au gradient, il passe dans la division par , et les poids aux gros gradients sont à peine rétrécis. AdamW (Loshchilov et Hutter, 2019) applique le facteur à part, après le pas d’Adam : c’est l’optimiseur par défaut pour entraîner les réseaux de la partie 22, LSTM du mémoire compris.
Exemple de code
Lagrange en pratique : le prix d’une contrainte, et la PCA
import numpy as np
from scipy.optimize import minimize

# 1. minimiser f(x, y) = (x - 2)² + (y - 2)² sous la contrainte g(x, y) = x + 2y = c
f = lambda p: (p[0] - 2) ** 2 + (p[1] - 2) ** 2
grad_f = lambda p: np.array([2 * (p[0] - 2), 2 * (p[1] - 2)])
grad_g = np.array([1.0, 2.0])


def optimum(c):
    contrainte = {"type": "eq", "fun": lambda p: p[0] + 2 * p[1] - c}
    return minimize(f, x0=np.zeros(2), constraints=[contrainte], method="SLSQP", tol=1e-12).x


p = optimum(2.0)
lam = -(grad_f(p) @ grad_g) / (grad_g @ grad_g)      # ∇f + λ∇g = 0  =>  λ
print(f"optimum = {p.round(4)} | f = {f(p):.4f} | ∇f = {grad_f(p).round(4)} | λ = {lam:.4f}")
print(f"résidu ∇f + λ∇g = {(grad_f(p) + lam * grad_g).round(8)}")
for c in (2.01, 2.1):                                # λ = prix de la contrainte
    print(f"c = {c}: f* = {f(optimum(c)):.4f} | variation {f(optimum(c)) - f(p):+.4f} "
          f"| prédiction -λ·Δc = {-lam * (c - 2):+.4f}")

# 2. la PCA est un problème de Lagrange : max wᵀCw sous wᵀw = 1
rng = np.random.default_rng(0)
z = rng.normal(size=(500, 2)) * [3.0, 0.5]           # le nuage de M3
R = np.array([[np.cos(0.6), -np.sin(0.6)], [np.sin(0.6), np.cos(0.6)]])
X = z @ R.T + [5.0, 2.0]
C = np.cov(X, rowvar=False)
norme = {"type": "eq", "fun": lambda w: w @ w - 1}
w = minimize(lambda w: -w @ C @ w, x0=np.array([1.0, 0.0]), constraints=[norme],
             method="SLSQP", tol=1e-12).x
print(f"w* = {w.round(4)} | multiplicateur wᵀCw = {w @ C @ w:.4f} | ‖Cw − λw‖ = {np.linalg.norm(C @ w - (w @ C @ w) * w):.1e}")
vals, vecs = np.linalg.eigh(C)
print(f"eigh : plus grande valeur propre {vals[-1]:.4f}, vecteur {vecs[:, -1].round(4)}")
- Le solveur trouve l’optimum avec et , exactement : , comme à la main.
- Le prix de la contrainte : en passant de à , baisse de , exactement . Pour , la baisse vaut contre prédit : la prédiction est du premier ordre, elle s’éloigne un peu quand grandit.
- La PCA : le maximum sous contrainte est , avec un multiplicateur de . C’est la plus grande valeur propre de la covariance (les de M3) et son vecteur propre, au signe près.
La géométrie, en chiffres
Ce script calcule les deux points de contact de la figure de la section 4 : une perte quadratique de minimum , contrainte à une boule de rayon 1.
import numpy as np
from scipy.optimize import minimize

A = np.array([[1.0, 0.3], [0.3, 1.5]])
w0 = np.array([2.5, 0.3])                            # minimum sans contrainte
perte = lambda w: (w - w0) @ A @ (w - w0)            # lignes de niveau = ellipses centrées en w0
t = 1.0                                              # rayon de la boule

boules = {
    "L1 (losange)": {"type": "ineq", "fun": lambda w: t - np.abs(w).sum()},
    "L2 (cercle)": {"type": "ineq", "fun": lambda w: t - np.sqrt(w @ w)},
}
for nom, contrainte in boules.items():
    meilleur = min((minimize(perte, x0=x0, constraints=[contrainte], method="SLSQP", tol=1e-12)
                    for x0 in ([0.1, 0.1], [0.5, -0.4], [-0.3, 0.6])), key=lambda r: r.fun)
    w = meilleur.x
    print(f"{nom:<13} w* = ({w[0]:.4f}, {w[1]:.4f}) | perte = {meilleur.fun:.4f} | gradient = {(2 * A @ (w - w0)).round(3)}")
| Boule | Solution | Perte | Gradient de la perte en |
|---|---|---|---|
| (losange) | 2,6550 | ||
| (cercle) | 2,3901 |
La solution tombe exactement sur la pointe . La solution garde , et son gradient est bien parallèle à : . C’est la condition de Lagrange, puisque le gradient de pointe dans la direction de . Pour , le gradient n’est pas parallèle à la normale d’une arête : en une pointe, la boule n’a pas de normale unique, et c’est précisément ce qui permet à la solution de s’y arrêter.
Seuillage doux, conditions KKT et équivalence pénalité/contrainte
On fabrique 5 features orthogonales ( ) pour que les formules de la section 5 soient exactes, avec des vrais poids .
import numpy as np
from scipy.optimize import minimize
from sklearn.linear_model import Lasso, Ridge

rng = np.random.default_rng(0)
n = 200
Q, _ = np.linalg.qr(rng.normal(size=(n, 5)))
X = Q * np.sqrt(n)                                   # colonnes orthogonales : XᵀX / n = I
w_vrai = np.array([3.0, -2.0, 1.0, 0.5, 0.0])
y = X @ w_vrai + rng.normal(0, 1, n)

z = X.T @ y / n                                      # moindres carrés (car XᵀX / n = I)
lam = 0.8
seuillage = np.sign(z) * np.maximum(np.abs(z) - lam, 0)   # solution L1 : seuillage doux
retrecie = z / (1 + lam)                                  # solution L2 : simple division
lasso = Lasso(alpha=lam, fit_intercept=False).fit(X, y).coef_
ridge = Ridge(alpha=n * lam, fit_intercept=False).fit(X, y).coef_   # Ridge ne divise pas par n
print("moindres carrés  :", z.round(3))
print("L1 (formule)     :", seuillage.round(3), "| sklearn Lasso :", lasso.round(3))
print("L2 (formule)     :", retrecie.round(3), "| sklearn Ridge :", ridge.round(3))

# conditions KKT du Lasso : |Xᵀ(y − Xw)/n| = λ sur les poids non nuls, ≤ λ sur les poids nuls
corr = X.T @ (y - X @ lasso) / n
print("|Xᵀr/n| :", np.abs(corr).round(3), "| poids nuls :", np.isclose(lasso, 0))

# pénalité <=> contrainte : on résout min (1/2n)‖y − Xw‖² sous ‖w‖₁ ≤ t, avec t = ‖w_lasso‖₁
t = np.abs(lasso).sum()
perte = lambda uv: np.sum((y - X @ (uv[:5] - uv[5:])) ** 2) / (2 * n)   # w = u − v, u, v ≥ 0
res = minimize(perte, x0=np.zeros(10), method="SLSQP", bounds=[(0, None)] * 10,
               constraints=[{"type": "ineq", "fun": lambda uv: t - uv.sum()}], tol=1e-12)
w_contraint = res.x[:5] - res.x[5:]
print(f"t = {t:.3f} | solution contrainte : {w_contraint.round(3)} | écart max avec le Lasso {np.abs(w_contraint - lasso).max():.1e}")
| Vrais poids | 3 | −2 | 1 | 0,5 | 0 |
| Moindres carrés | 2,946 | −1,923 | 0,971 | 0,455 | −0,106 |
| , (formule = scikit-learn) | 2,146 | −1,123 | 0,171 | 0 | 0 |
| , (formule = scikit-learn) | 1,637 | −1,069 | 0,539 | 0,253 | −0,059 |
Ce qu’on lit :
- les formules de la section 5 coïncident avec scikit-learn au millième près. Attention aux conventions :
Lassodivise la perte par ,Ridgene la divise pas, d’où lealpha=n * lam; - rabote chaque poids de exactement 0,8 et met à zéro ceux qui étaient sous le seuil ( et ). divise tout par 1,8 et n’annule rien ;
- le revers : a aussi supprimé , dont le vrai poids vaut 0,5. Un effet réel mais faible ressemble à du bruit. Et les poids gardés sont biaisés vers 0 : en pratique, on réajuste souvent un modèle non régularisé sur les features sélectionnées ;
- les conditions KKT se lisent dans la corrélation entre les features et le résidu : elle vaut exactement sur les trois poids non nuls (contrainte « active » pour chacun), et reste sous ( et ) sur les deux poids nuls ;
- pénalité = contrainte : en imposant avec (la norme de la solution Lasso), on retrouve la même solution à près. Le du Lasso est le multiplicateur de cette contrainte.
Fil rouge : un chemin de régularisation pour choisir ses features
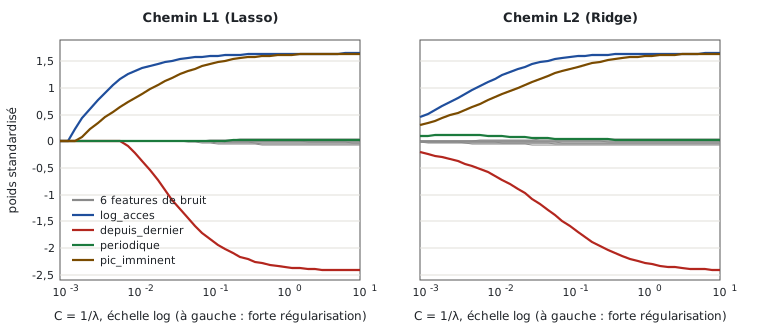
On reprend les régions mémoire synthétiques de M9 et M10, avec les 4 features métier, et on ajoute 6 features de bruit pur. Un bon modèle devrait les ignorer. On fait varier la régularisation de très forte à presque nulle et on suit chaque poids : c’est le chemin de régularisation. Dans scikit-learn, le paramètre est .
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import f1_score, log_loss
from sklearn.model_selection import train_test_split


def make_regions(n, rng):
    """Régions mémoire synthétiques (même générateur que M9 et M10) : label 1 = chaude dans la prochaine fenêtre."""
    taux = rng.gamma(0.6, 4, n)
    acces_recents = rng.poisson(taux)
    depuis_dernier = np.round(rng.exponential(30 / (1 + acces_recents)), 1)
    periodique = rng.binomial(1, 0.25, n)
    avant_pic = rng.integers(0, 12, n)
    logit = (0.9 * np.log1p(acces_recents) - 0.05 * depuis_dernier
             + 3.0 * periodique * (avant_pic < 3) - 1.5 + rng.normal(0, 0.8, n))
    X = np.column_stack([acces_recents, depuis_dernier, periodique, avant_pic])
    return X, (logit > 0).astype(int)


def features_metier(X):
    return np.column_stack([np.log1p(X[:, 0]), X[:, 1], X[:, 2], X[:, 2] * (X[:, 3] < 3)])


rng = np.random.default_rng(0)
X, y = make_regions(5000, rng)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
# 4 features utiles + 6 features de bruit pur, que le modèle devrait ignorer
noms = ["log_acces", "depuis_dernier", "periodique", "pic_imminent"] + [f"bruit_{k}" for k in range(1, 7)]
Ftr = np.column_stack([features_metier(Xtr), rng.normal(size=(len(Xtr), 6))])
Fte = np.column_stack([features_metier(Xte), rng.normal(size=(len(Xte), 6))])
mu, sd = Ftr.mean(axis=0), Ftr.std(axis=0)
Ztr, Zte = (Ftr - mu) / sd, (Fte - mu) / sd          # standardiser : la pénalité doit traiter chaque poids pareil

Cs = np.logspace(-3, 1, 41)                          # C = 1/λ : petit C = forte régularisation
chemins = {}
for penalite, l1_ratio in (("l1", 1.0), ("l2", 0.0)):
    coefs = []
    for C in Cs:
        m = LogisticRegression(C=C, l1_ratio=l1_ratio, solver="saga", max_iter=20_000, tol=1e-8).fit(Ztr, ytr)
        coefs.append(m.coef_[0])
        if C in Cs[[0, 8, 16, 24, 40]]:
            p = m.predict_proba(Zte)[:, 1]
            print(f"{penalite} C = {C:<7.3g} poids non nuls = {np.sum(np.abs(m.coef_[0]) > 1e-6):>2} | "
                  f"‖w‖₁ = {np.abs(m.coef_[0]).sum():6.3f} | log-loss test = {log_loss(yte, p):.4f} | "
                  f"F1 test = {f1_score(yte, (p > 0.5).astype(int)):.3f}")
    chemins[penalite] = np.array(coefs)

# ordre d'entrée des features dans le chemin L1 (plus petit C où le poids devient non nul)
entree = [Cs[np.argmax(np.abs(chemins["l1"][:, j]) > 1e-6)] if (np.abs(chemins["l1"][:, j]) > 1e-6).any()
          else np.inf for j in range(len(noms))]
for j in np.argsort(entree):
    print(f"  {noms[j]:<15} entre à C = {entree[j]:.3g} | poids à C = 10 : L1 {chemins['l1'][-1, j]:+.3f}, L2 {chemins['l2'][-1, j]:+.3f}")
print("plus petit |poids| L2 sur tout le chemin :", f"{np.abs(chemins['l2']).min():.1e}")
| Pénalité | Poids non nuls (sur 10) | Log-loss de test | F1 de test | ||
|---|---|---|---|---|---|
| 0,001 | 0 | 0,000 | 0,5278 | 0,000 | |
| 0,0063 | 2 | 1,816 | 0,3309 | 0,575 | |
| 0,040 | 3 | 4,058 | 0,2921 | 0,681 | |
| 0,25 | 9 | 5,522 | 0,2884 | 0,680 | |
| 10 | 10 | 5,967 | 0,2884 | 0,685 | |
| 0,001 | 10 | 1,110 | 0,3921 | 0,289 | |
| 0,040 | 10 | 4,070 | 0,2933 | 0,679 | |
| 10 | 10 | 5,957 | 0,2884 | 0,685 |
Ordre d’entrée dans le chemin
: log_acces (
), pic_imminent (
), depuis_dernier (
), puis un premier bruit à
, et periodique seulement à
.
Ce que montre le chemin :
- avec une régularisation très forte, annule tout. Le modèle prédit alors la fréquence de base (log-loss 0,528, F1 nul). , au même , garde les 10 poids non nuls : sur tout le chemin, le plus petit poids vaut , jamais exactement 0 ;
- à
,
ne garde que 3 features sur 10, et ce sont les bonnes :
log_acces,pic_imminentetdepuis_dernier. Avec elles seules, le F1 de test vaut 0,681, contre 0,685 pour le modèle complet. Les 6 bruits n’apportaient rien ; periodiqueentre après le premier bruit, et son poids final reste minuscule (+0,03). C’est juste : dans le générateur, être périodique ne compte qu’à l’approche du pic, et cette information est déjà danspic_imminent. Le chemin a retrouvé la structure du problème sans qu’on la lui dise ;- sans régularisation ( ), et donnent le même modèle : quand la boule est assez grande pour contenir le minimum libre, la contrainte est inactive ( ), quelle que soit sa forme.
Pour choisir
en vrai, on ne regarde pas le test : on fait une validation croisée sur le chemin (LogisticRegressionCV, partie 18). Le chemin, lui, sert à comprendre quelles features portent le signal.
Exercice pratique
- À la main. Maximise sous avec un multiplicateur de Lagrange. Vérifie ensuite l’interprétation de comme prix de la contrainte : de combien augmente le maximum quand on passe à ?
- Seuillage doux. Retrouve la formule en traitant séparément les cas , et . Puis, sur les features orthogonales de l’exemple, compte les poids nuls du Lasso pour et prédis le résultat avant de lancer le code.
- Features corrélées. Dans le fil rouge, ajoute une copie bruitée de
log_acces(même colonne plus un bruit d’écart-type 0,05). Compare les poids des deux copies avec et avec à . Lequel des deux répartit le poids, lequel en choisit une ? Essaie ensuite l’elastic net avecl1_ratio=0.5. - SVM et KKT. Entraîne
SVC(kernel="linear", C=1.0)sur les 4 features métier standardisées du fil rouge (2 000 exemples suffisent). Combien de vecteurs de support (support_) ? Vérifie que les exemples avec (calculé avecdecision_functionet ) ne sont jamais des vecteurs de support. - Adam contre AdamW. Dans l’entraîneur Adam de M10, sur les features brutes, ajoute une régularisation de deux façons :
ajouté au gradient avant Adam, puis le facteur
appliqué après le pas (AdamW), avec
. Quel poids est le plus rétréci dans chaque cas ? Relie la réponse à l’échelle de
depuis_dernier. - Fil rouge. Sur les 9 features de la partie 14, trace le chemin . Quelles features entrent en premier ? Lesquelles n’entrent qu’à faible régularisation ? Compare avec l’importance des features de la partie 19.
Indice pour la question 1 : l’optimum est avec . Pour , le maximum vaut : il passe de 25 à 25,5025, soit environ .
Ressources pour aller plus loin
- James, Witten, Hastie et Tibshirani, An Introduction to Statistical Learning (ISLR), chapitre 6, section 6.2 : Ridge, Lasso et la figure des boules, gratuit en ligne.
- Hastie, Tibshirani et Friedman, The Elements of Statistical Learning, section 3.4 : les méthodes de rétrécissement et les chemins de régularisation.
- Tibshirani, Regression Shrinkage and Selection via the Lasso (Journal of the Royal Statistical Society B, 1996) : l’article fondateur du Lasso.
- Boyd et Vandenberghe, Convex Optimization, chapitre 5 (dualité et conditions KKT), gratuit en ligne.
- Bishop, Pattern Recognition and Machine Learning, annexe E (multiplicateurs de Lagrange) et chapitre 7 (SVM).
- Loshchilov et Hutter, Decoupled Weight Decay Regularization (ICLR 2019) : AdamW.
Ce que tu dois savoir faire avant de passer à la suite
- Résoudre un problème simple avec un multiplicateur de Lagrange et interpréter comme le prix de la contrainte
- Écrire les conditions KKT et dire si une contrainte est active ou inactive
- Expliquer pourquoi une pénalité équivaut à une contrainte
- Expliquer géométriquement pourquoi annule des poids et les rétrécit
- Retrouver le seuillage doux et le facteur
- Lire un chemin de régularisation et expliquer pourquoi on standardise avant de régulariser
- Dire ce qu’AdamW change par rapport à une pénalité dans Adam
Partie suivante : M12 · Synthèse : tout relire avec les maths. On reprend tout le programme de maths et on le relie aux modèles de la phase technique, du produit scalaire au LSTM du mémoire.