M5 · Règle de la chaîne et rétropropagation
Jacobiennes et règle de la chaîne : refaire à la main la rétropropagation d'un petit réseau, écrire un mini-autograd et comprendre le gradient qui disparaît.
Mastering AI · Required Maths · Semaine 2 (calcul différentiel) · Partie 5
Objectif de l’étape
Un réseau de neurones est une composition de fonctions : une couche, puis une autre, puis une autre. Pour l’entraîner, il faut le gradient de la perte par rapport à chaque poids, y compris ceux de la première couche, enfouis sous toutes les autres. La règle de la chaîne, appliquée intelligemment, donne tous ces gradients d’un coup : c’est la rétropropagation.
À la fin de cet article, tu sauras :
- appliquer la règle de la chaîne en une et plusieurs variables ;
- lire un graphe de calcul et y faire circuler les gradients à la main ;
- écrire un mini-moteur d’autograd en 80 lignes et le comparer à PyTorch ;
- rétropropager à la main dans un MLP à deux couches ;
- expliquer pourquoi le gradient disparaît dans les réseaux profonds à sigmoïdes.
Notions clés
1. La règle de la chaîne
Intuition. Si dépend de et dépend de , alors un petit changement de se propage : il change , qui change . Les taux de variation se multiplient. Si bouge 3 fois plus vite que , et 2 fois plus vite que , alors bouge 6 fois plus vite que .
Exemple : . Avec , on obtient . En , cela vaut , exactement ce que donne la différence finie de M4.
2. En plusieurs variables : on additionne les chemins
Intuition. Si influence par plusieurs chemins, les contributions de chaque chemin s’additionnent.
Sous forme matricielle, les dérivées partielles d’une fonction se rangent dans la matrice jacobienne , de taille . La règle de la chaîne devient un produit de jacobiennes :
On retrouve le produit matriciel = composition de M2, cette fois appliqué aux transformations « locales » que sont les dérivées. Pour une couche linéaire , la jacobienne de par rapport à est tout simplement .
3. Le graphe de calcul
Intuition. On découpe le calcul de la perte en opérations élémentaires (additions, produits, sigmoïdes, logarithmes). Chaque opération connaît sa propre dérivée locale. La perte finale s’obtient en avançant dans le graphe (passe avant) ; les gradients s’obtiennent en reculant (passe arrière), en multipliant les dérivées locales.
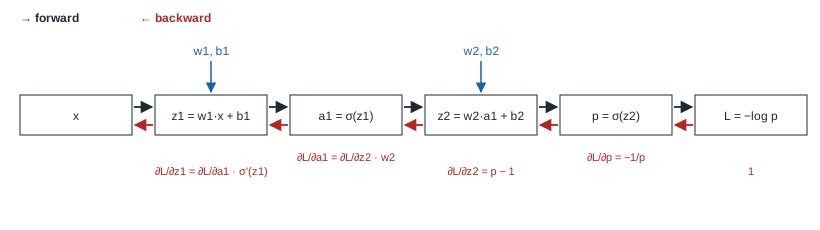
Sur ce petit réseau (un neurone caché, un neurone de sortie, label ), la passe arrière part de et remonte :
- ;
- en traversant la sigmoïde, (la même simplification qu’en M4) ;
- en traversant la couche linéaire, et ;
- et ainsi de suite jusqu’à et .
4. Pourquoi « en arrière » ?
Intuition. Une perte est un seul nombre, mais il y a des millions de paramètres. En partant de la perte et en remontant, chaque nœud est visité une seule fois, et à la fin on a le gradient par rapport à tous les paramètres. Le coût total est du même ordre que celui de la passe avant.
C’est le mode reverse de la différentiation automatique. Le mode forward (partir des entrées) donnerait la dérivée par rapport à une seule entrée à chaque passe : il faudrait une passe par paramètre. Pour un réseau d’un million de poids, c’est la différence entre 2 passes et un million de passes.
5. Le gradient qui disparaît
Intuition. Dans un réseau de couches, le gradient de la première couche est un produit de facteurs. Si chaque facteur est plus petit que 1, le produit s’effondre exponentiellement.
La dérivée de la sigmoïde vaut au plus . Chaque couche sigmoïde multiplie donc le gradient par un facteur souvent bien inférieur à 1 :
Les premières couches n’apprennent presque plus rien. C’est le même mécanisme que les puissances de matrices de M3 : des facteurs plus petits que 1 répétés font disparaître le signal. Deux remèdes classiques, qu’on verra en partie 22 :
- remplacer la sigmoïde par ReLU, dont la dérivée vaut 1 sur la partie active ;
- initialiser les poids avec la bonne échelle (initialisation de He pour ReLU, de Xavier pour tanh).
Exemple de code
Un mini-autograd en Python
Chaque Valeur garde ses parents et sait propager son gradient. backward() trie le graphe et applique la règle de la chaîne nœud par nœud, du dernier au premier.
import math
import torch


class Valeur:
    """Un nombre qui se souvient de comment il a été calculé."""

    def __init__(self, data, parents=(), op=""):
        self.data, self.grad = data, 0.0
        self._parents, self._op = parents, op
        self._backward = lambda: None

    def __add__(self, other):
        other = other if isinstance(other, Valeur) else Valeur(other)
        out = Valeur(self.data + other.data, (self, other), "+")
        def _backward():
            self.grad += out.grad            # d(a+b)/da = 1
            other.grad += out.grad           # d(a+b)/db = 1
        out._backward = _backward
        return out

    def __mul__(self, other):
        other = other if isinstance(other, Valeur) else Valeur(other)
        out = Valeur(self.data * other.data, (self, other), "*")
        def _backward():
            self.grad += other.data * out.grad   # d(ab)/da = b
            other.grad += self.data * out.grad   # d(ab)/db = a
        out._backward = _backward
        return out

    def sigmoide(self):
        s = 1 / (1 + math.exp(-self.data))
        out = Valeur(s, (self,), "σ")
        def _backward():
            self.grad += s * (1 - s) * out.grad
        out._backward = _backward
        return out

    def log(self):
        out = Valeur(math.log(self.data), (self,), "log")
        def _backward():
            self.grad += (1 / self.data) * out.grad
        out._backward = _backward
        return out

    def backward(self):
        # tri topologique : on traite chaque nœud après tous ceux qui dépendent de lui
        ordre, vus = [], set()
        def visiter(v):
            if v not in vus:
                vus.add(v)
                for p in v._parents:
                    visiter(p)
                ordre.append(v)
        visiter(self)
        self.grad = 1.0
        for v in reversed(ordre):
            v._backward()


# le réseau de la figure, avec y = 1
x, w1, b1, w2, b2 = Valeur(0.5), Valeur(-1.2), Valeur(0.3), Valeur(2.0), Valeur(-0.5)
a1 = (w1 * x + b1).sigmoide()
p = (w2 * a1 + b2).sigmoide()
L = p.log() * -1.0
L.backward()
print(f"mini-autograd : L = {L.data:.5f} | dL/dw1 = {w1.grad:.5f} | dL/db1 = {b1.grad:.5f} | dL/dw2 = {w2.grad:.5f} | dL/db2 = {b2.grad:.5f}")

# la même chose avec PyTorch
t = {k: torch.tensor(v, requires_grad=True, dtype=torch.float64)
     for k, v in dict(w1=-1.2, b1=0.3, w2=2.0, b2=-0.5).items()}
a1t = torch.sigmoid(t["w1"] * 0.5 + t["b1"])
pt = torch.sigmoid(t["w2"] * a1t + t["b2"])
Lt = -torch.log(pt)
Lt.backward()
print("PyTorch       : L = {:.5f} | dL/dw1 = {:.5f} | dL/db1 = {:.5f} | dL/dw2 = {:.5f} | dL/db2 = {:.5f}".format(
    Lt.item(), t["w1"].grad.item(), t["b1"].grad.item(), t["w2"].grad.item(), t["b2"].grad.item()))
| mini-autograd | 0,53292 | −0,10099 | −0,20198 | −0,17580 | −0,41311 |
| PyTorch | 0,53292 | −0,10099 | −0,20198 | −0,17580 | −0,41311 |
Identique au dernier chiffre. Remarque que : c’est la règle de la chaîne à travers .
Rétropropagation à la main dans un MLP
Un MLP à 9 entrées (comme nos features), 16 neurones cachés sigmoïdes et une sortie, sur 64 exemples. On écrit la passe arrière couche par couche, en suivant le graphe.
import numpy as np
import torch

rng = np.random.default_rng(0)
n, d, hdim = 64, 9, 16
X = rng.normal(size=(n, d))
y = (X[:, 0] - X[:, 1] + 0.5 * rng.normal(size=n) > 0).astype(float).reshape(-1, 1)
W1, B1 = rng.normal(0, 0.5, (d, hdim)), np.zeros((1, hdim))
W2, B2 = rng.normal(0, 0.5, (hdim, 1)), np.zeros((1, 1))
sig = lambda z: 1 / (1 + np.exp(-z))

# passe avant
Z1 = X @ W1 + B1
A1 = sig(Z1)
Z2 = A1 @ W2 + B2
P = sig(Z2)
loss = -np.mean(y * np.log(P) + (1 - y) * np.log(1 - P))

# passe arrière : on remonte la chaîne, une couche à la fois
dZ2 = (P - y) / n                     # dL/dZ2 (sigmoïde + log-loss se simplifient)
dW2 = A1.T @ dZ2
dB2 = dZ2.sum(axis=0, keepdims=True)
dA1 = dZ2 @ W2.T                      # on traverse la couche 2 : jacobienne = W2
dZ1 = dA1 * A1 * (1 - A1)             # on traverse la sigmoïde
dW1 = X.T @ dZ1
dB1 = dZ1.sum(axis=0, keepdims=True)

# même calcul avec autograd
T = lambda a: torch.tensor(a, requires_grad=True)
W1t, B1t, W2t, B2t = T(W1), T(B1), T(W2), T(B2)
Pt = torch.sigmoid(torch.sigmoid(torch.tensor(X) @ W1t + B1t) @ W2t + B2t)
losst = torch.nn.functional.binary_cross_entropy(Pt, torch.tensor(y))
losst.backward()
for nom, a, b in (("W1", dW1, W1t), ("B1", dB1, B1t), ("W2", dW2, W2t), ("B2", dB2, B2t)):
    print(f"{nom}: écart max main/autograd = {np.abs(a - b.grad.numpy()).max():.1e}")
print(f"perte : main {loss:.6f} | torch {losst.item():.6f}")
Les écarts sont de l’ordre de : la précision machine. Six lignes suffisent pour la passe arrière d’un MLP. Le motif se répète pour chaque couche : gradient des poids = activation d’entrée transposée × gradient de sortie ; gradient à transmettre = gradient de sortie × poids transposés ; traversée de l’activation = multiplication terme à terme par sa dérivée.
Le gradient qui disparaît, mesuré
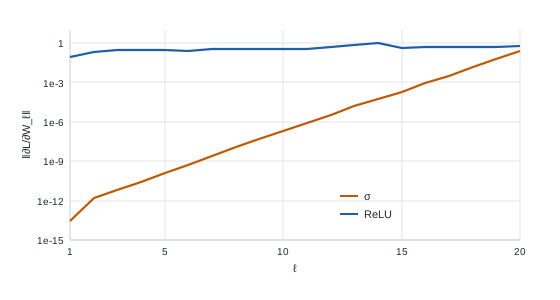
On empile 20 couches de 32 neurones et on mesure la norme du gradient de chaque couche après une seule passe arrière.
import math
import torch


def normes_gradient(activation, profondeur=20, largeur=32, seed=0):
    torch.manual_seed(seed)
    couches = []
    for _ in range(profondeur):
        lin = torch.nn.Linear(largeur, largeur)
        gain = 2.0 if activation is torch.nn.ReLU else 1.0   # init de He pour ReLU (partie 22)
        torch.nn.init.normal_(lin.weight, 0, math.sqrt(gain / largeur))
        torch.nn.init.zeros_(lin.bias)
        couches += [lin, activation()]
    reseau = torch.nn.Sequential(*couches, torch.nn.Linear(largeur, 1))
    xb = torch.randn(256, largeur)
    reseau(xb).pow(2).mean().backward()
    return [reseau[2 * i].weight.grad.norm().item() for i in range(profondeur)]


for act in (torch.nn.Sigmoid, torch.nn.ReLU):
    g = normes_gradient(act)
    print(f"{act.__name__:<8} couche 1 : {g[0]:.2e} | couche 10 : {g[9]:.2e} | couche 20 : {g[19]:.2e}")
| Activation | Couche 1 (entrée) | Couche 10 | Couche 20 (sortie) |
|---|---|---|---|
| sigmoïde | |||
| ReLU + init de He |
Avec des sigmoïdes, le gradient perd environ un facteur 5 par couche : treize ordres de grandeur entre la sortie et l’entrée. Les premières couches ne bougeront jamais. Avec ReLU et la bonne initialisation, il reste du même ordre partout.
Exercice pratique
- À la main. Calcule et avec la règle de la chaîne, puis vérifie avec une différence centrée.
- Étendre le mini-autograd. Ajoute
__pow__,tanhetreluàValeur, puis recalcule les gradients du petit réseau avectanhà la place de la sigmoïde. Compare avec PyTorch. - Un chemin double. Avec ton autograd, calcule le gradient de
par rapport à
. Pourquoi faut-il
+=et pas=dans les fonctions_backward? Que se passe-t-il si tu mets=? - MLP à la main, avec ReLU. Reprends la rétropropagation NumPy en remplaçant la sigmoïde cachée par ReLU. Quelle ligne change ? Vérifie avec PyTorch.
- Gradient qui disparaît. Dans
normes_gradient, utilise ReLU sans l’initialisation de He (gain = 1). Que deviennent les normes ? Essaie aussitorch.nn.Tanh.
Indice pour la question 3 : quand une valeur est utilisée deux fois, les contributions des deux chemins doivent s’additionner (section 2).
Ressources pour aller plus loin
- Andrej Karpathy, The spelled-out intro to neural networks and backpropagation: building micrograd (vidéo YouTube) : l’inspiration directe du mini-autograd de cet article.
- 3Blue1Brown, Neural Networks, épisodes 3 et 4 : la rétropropagation en animation.
- Christopher Olah, Calculus on Computational Graphs: Backpropagation (blog colah.github.io).
- Goodfellow, Bengio, Courville, Deep Learning, section 6.5.
Ce que tu dois savoir faire avant de passer à la suite
- Appliquer la règle de la chaîne à une composition de fonctions
- Expliquer pourquoi les contributions de plusieurs chemins s’additionnent
- Dessiner le graphe de calcul d’un petit réseau et y propager les gradients à la main
- Écrire la passe arrière d’un MLP à deux couches en NumPy
- Expliquer pourquoi on rétropropage en mode reverse plutôt qu’en mode forward
- Expliquer le gradient qui disparaît et citer deux remèdes
Partie suivante : M6 · Hessienne, convexité et développement de Taylor. Le gradient donne la pente ; la courbure dit si la pente est fiable, et pourquoi certaines pertes sont faciles à optimiser et d’autres non.