M12 · Synthèse : tout relire avec les maths
Régression logistique et MLP reconstruits en NumPy, chaque ligne justifiée par une notion de M1 à M11 : gradient, hessienne, Newton, rétropropagation, AdamW, bootstrap apparié. Puis le bilan du programme de maths.
Mastering AI · Required Maths · Semaine 4 (optimisation et synthèse) · Partie 12, la dernière partie de maths
Objectif de l’étape
Onze articles, onze outils : vecteurs, matrices, valeurs propres, gradient, règle de la chaîne, hessienne, variables aléatoires, vraisemblance, statistique inférentielle, descente de gradient, régularisation. Pris séparément, chacun a l’air d’un chapitre de cours. Cet article les remet ensemble : on reconstruit deux modèles complets, sans aucune bibliothèque de ML, et à chaque ligne de code on dit quelle notion la justifie.
À la fin de cet article, tu sauras :
- dériver la régression logistique de A à Z : modèle, perte, gradient, hessienne, convexité, optimisation, régularisation ;
- l’entraîner en NumPy par descente de gradient et par la méthode de Newton, et vérifier ton gradient par différences finies ;
- écrire un MLP à une couche cachée, sa rétropropagation et son entraînement AdamW, toujours en NumPy ;
- comparer les deux modèles proprement (M9) et regarder dans la couche cachée avec une PCA (M3) ;
- situer chaque notion de maths dans la phase technique qui commence à la partie 13.
Notions clés
1. La régression logistique de A à Z
Intuition. Une régression logistique, c’est un produit scalaire passé dans une fonction en S. Tout le reste (la perte, le gradient, l’algorithme) découle de ce choix, et chaque étape mobilise un article du programme.
Le modèle (M1, M2). Pour une région mémoire décrite par un vecteur (avec un 1 en tête pour l’intercept), le score est un produit scalaire (M1) et la probabilité d’être chaude s’obtient par la sigmoïde :
Pour régions empilées dans une matrice (M2), tous les scores tiennent en un produit matrice-vecteur : .
La perte (M7, M8). Le label est une Bernoulli de paramètre (M7). Maximiser la vraisemblance revient à minimiser la log-vraisemblance négative moyenne, c’est-à-dire l’entropie croisée (M8). On ajoute la pénalité de M11 :
Le gradient (M4, M5). La règle de la chaîne (M5) découpe le calcul en trois maillons : . La dérivée de la sigmoïde vaut , et elle se simplifie avec celle de l’entropie croisée :
Le gradient (M4) est une somme d’erreurs pondérées par les features : une région prédite à 0,9 alors qu’elle est froide tire fort sur les poids, une région bien prédite ne tire presque pas.
La hessienne et la convexité (M6). En dérivant encore une fois :
Pour tout vecteur , : la hessienne est semi-définie positive partout, donc la perte est convexe (M6). Avec , elle est strictement convexe : un seul minimum, que n’importe quel algorithme raisonnable finit par trouver.
L’optimisation (M10). Deux options :
- la descente de gradient de M10, , avec un pas limité par la plus grande valeur propre de la hessienne ;
- la méthode de Newton, qui utilise le développement de Taylor d’ordre 2 de M6 et saute directement au minimum de la parabole locale :
Newton coûte une résolution de système linéaire par itération, mais converge quadratiquement : près du minimum, le nombre de chiffres exacts double à chaque pas. Pour la régression logistique, on l’appelle aussi IRLS (moindres carrés repondérés itérativement). Avec 5 paramètres, c’est imbattable ; avec un million, la hessienne ne tient plus en mémoire et on revient au gradient.
La régularisation (M11). Le terme ajoute au gradient et à la hessienne : il rend le problème strictement convexe et mieux conditionné. En pratique, on ne pénalise pas l’intercept, qui ne fait que fixer le taux de base.
L’évaluation (M9). Un F1 de test n’est qu’une estimation. Pour dire qu’un modèle est meilleur qu’un autre, il faut l’intervalle de la différence (bootstrap apparié) et un test sur les désaccords (McNemar) : c’est ce que fait le troisième bloc de code.
2. Le MLP de A à Z
Intuition. La régression logistique ne voit que ce qu’on lui donne. En M9, la LR sur features brutes plafonnait à un F1 de 0,582, parce que la règle « périodique et pic imminent » est une interaction qu’un produit scalaire ne peut pas exprimer. Un MLP fabrique lui-même ses features : une couche cachée transforme l’entrée, et une régression logistique travaille sur ces nouvelles coordonnées.
Les couches (M2). Avec neurones cachés :
La première ligne est une transformation affine suivie d’une non-linéarité. Sans le ReLU, deux couches affines se composeraient en une seule (M2) et le MLP ne serait qu’une régression logistique déguisée.
La rétropropagation (M5). On applique la règle de la chaîne en partant de la sortie. Le premier maillon est le même que pour la LR, puis on remonte à travers et la dérivée du ReLU (1 si , 0 sinon) :
Chaque gradient est « erreur qui arrive × activation qui entre ». C’est exactement ce que PyTorch calcule pour toi à la partie 21.
La perte n’est plus convexe (M6). Permute deux neurones cachés (et leurs poids) : le réseau calcule la même fonction, avec des paramètres différents. Il y a donc plusieurs minima équivalents, et la perte ne peut pas être convexe. Conséquences :
- l’initialisation compte : on tire les poids au hasard avec une variance , où est le nombre d’entrées du neurone (initialisation de He), pour que la variance des activations ne s’effondre ni n’explose d’une couche à l’autre (le calcul de variance de M7) ;
- l’optimiseur compte : on utilise Adam en mini-batchs (M10), avec le weight decay découplé d’AdamW (M11) ;
- le surapprentissage guette : avec 97 paramètres pour 3 500 régions, la perte de test peut remonter alors que celle d’entraînement baisse encore. On le voit dans le code.
3. PCA et comparaison de modèles, revisitées
Deux outils servent à regarder un modèle plutôt qu’à l’entraîner :
- la PCA (M3) sur les activations de la couche cachée dit combien de directions le réseau utilise vraiment. Si 16 neurones ne portent que 3 ou 4 directions, la couche est plus large que nécessaire (M3) ;
- le bootstrap apparié et McNemar (M9) disent si l’écart entre deux modèles dépasse le bruit du jeu de test (M9).
4. La carte : chaque notion, et où elle sert
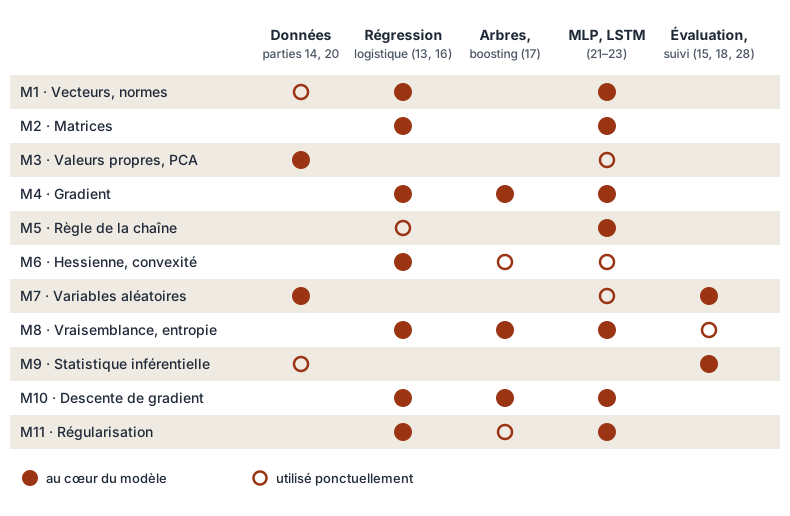
Trois lignes de la carte méritent un mot :
- le gradient, la descente de gradient et l’entropie croisée sont partout, arbres compris : le gradient boosting est une descente de gradient sur des fonctions (M10), et LightGBM fait même un pas de Newton dans chaque feuille (M6) ;
- la statistique inférentielle ne sert à entraîner aucun modèle, mais c’est elle qui décide si un modèle est meilleur qu’un autre, et si les données de production ont dérivé (partie 28) ;
- les variables aléatoires sont dans la colonne « Données » : un échantillon autocorrélé ne se découpe pas en train/test comme un échantillon indépendant (M7, partie 14).
Exemple de code
La régression logistique, entièrement en NumPy
On reprend le générateur de régions mémoire de M9 à M11 et les 4 features métier. Le modèle, sa perte, son gradient, sa hessienne et ses deux optimiseurs sont écrits à la main. scikit-learn ne sert qu’à deux choses : retrouver le même découpage train/test que dans les articles précédents, et vérifier le résultat à la fin.
import numpy as np
from sklearn.model_selection import train_test_split   # uniquement pour retrouver le même jeu de test que M9–M11


def make_regions(n, rng):
    """Régions mémoire synthétiques (même générateur que M9–M11) : label 1 = chaude dans la prochaine fenêtre."""
    taux = rng.gamma(0.6, 4, n)
    acces_recents = rng.poisson(taux)
    depuis_dernier = np.round(rng.exponential(30 / (1 + acces_recents)), 1)
    periodique = rng.binomial(1, 0.25, n)
    avant_pic = rng.integers(0, 12, n)
    logit = (0.9 * np.log1p(acces_recents) - 0.05 * depuis_dernier
             + 3.0 * periodique * (avant_pic < 3) - 1.5 + rng.normal(0, 0.8, n))
    X = np.column_stack([acces_recents, depuis_dernier, periodique, avant_pic])
    return X, (logit > 0).astype(int)


def features_metier(X):
    return np.column_stack([np.log1p(X[:, 0]), X[:, 1], X[:, 2], X[:, 2] * (X[:, 3] < 3)])


def f1(y, yhat):
    tp = np.sum((yhat == 1) & (y == 1))
    return 2 * tp / (np.sum(yhat == 1) + np.sum(y == 1))


rng = np.random.default_rng(0)
X, y = make_regions(5000, rng)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
Ftr, Fte = features_metier(Xtr), features_metier(Xte)
mu, sd = Ftr.mean(axis=0), Ftr.std(axis=0)                     # M1 : standardiser avec les stats du train
A_tr = np.column_stack([np.ones(len(Ftr)), (Ftr - mu) / sd])   # M2 : une matrice, une ligne par région
A_te = np.column_stack([np.ones(len(Fte)), (Fte - mu) / sd])
lam = 1e-3                                                     # M11 : pénalité L2 (pas sur l'intercept)
masque = np.r_[0.0, np.ones(4)]


def sigmoide(z):
    return 1 / (1 + np.exp(-z))


def perte(w, A, y):
    """M8 : log-vraisemblance négative moyenne d'une Bernoulli, + M11 : (λ/2)‖w‖²."""
    p = sigmoide(A @ w)                                        # M1 + M2 : produits scalaires en bloc
    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p)) + lam / 2 * np.sum(masque * w ** 2)


def gradient(w, A, y):
    """M4 + M5 : règle de la chaîne, σ' = σ(1 − σ) se simplifie, il reste Aᵀ(p − y)/n."""
    return A.T @ (sigmoide(A @ w) - y) / len(y) + lam * masque * w


def hessienne(w, A):
    """M6 : Aᵀ S A / n avec S = diag(p(1 − p)) : semi-définie positive, donc perte convexe."""
    p = sigmoide(A @ w)
    return (A * (p * (1 - p))[:, None]).T @ A / len(A) + lam * np.diag(masque)


# 1. vérifier le gradient par différences finies (M4)
w = rng.normal(size=5)
h = 1e-6
num = np.array([(perte(w + h * e, A_tr, ytr) - perte(w - h * e, A_tr, ytr)) / (2 * h) for e in np.eye(5)])
print(f"écart gradient analytique / numérique : {np.abs(num - gradient(w, A_tr, ytr)).max():.1e}")

# 2. Newton (M6 + M10) : w ← w − H⁻¹ ∇L
w = np.zeros(5)
for it in range(1, 8):
    w = w - np.linalg.solve(hessienne(w, A_tr), gradient(w, A_tr, ytr))
    print(f"Newton itération {it} : perte = {perte(w, A_tr, ytr):.6f} | ‖∇L‖ = {np.linalg.norm(gradient(w, A_tr, ytr)):.1e}")
vp = np.linalg.eigvalsh(hessienne(w, A_tr))
print(f"hessienne à l'optimum : valeurs propres de {vp[0]:.4f} à {vp[-1]:.4f} (toutes > 0), conditionnement {vp[-1] / vp[0]:.1f}")

# 3. descente de gradient (M10) avec le pas 1/λ_max, pour comparer
w_gd, L_star, pas = np.zeros(5), perte(w, A_tr, ytr), 1 / vp[-1]
for k in range(1, 5001):
    w_gd -= pas * gradient(w_gd, A_tr, ytr)
    if perte(w_gd, A_tr, ytr) - L_star < 1e-6:
        break
print(f"GD (pas = 1/λ_max = {pas:.2f}) : écart < 1e-6 en {k} itérations")

# 4. le modèle, lu et évalué
print("poids (intercept, log_acces, depuis_dernier, periodique, pic_imminent) :", w.round(3))
p_te = sigmoide(A_te @ w)
print(f"F1 de test (seuil 0,5) = {f1(yte, (p_te > 0.5).astype(int)):.3f}")

# 5. vérification (la seule ligne de ML « toute faite ») : scikit-learn, même pénalité
from sklearn.linear_model import LogisticRegression
ref = LogisticRegression(C=1 / (lam * len(ytr)), tol=1e-10, max_iter=10_000).fit(A_tr[:, 1:], ytr)
print(f"écart max avec scikit-learn : {np.abs(np.r_[ref.intercept_, ref.coef_[0]] - w).max():.1e}")
| Étape | Ce qu’on observe | Notion |
|---|---|---|
| Vérification du gradient | écart de avec les différences finies | M4, M5 |
| Newton, itérations 4 → 7 | : , , , | M6, M10 |
| Hessienne à l’optimum | valeurs propres de 0,0056 à 0,2000, toutes positives, conditionnement 35,8 | M6 |
| Descente de gradient | 146 itérations pour arriver à de la perte optimale (0,274160) | M10 |
| Vérification finale | écart de avec les poids de scikit-learn |
Ce qu’on lit :
- Newton converge en 7 itérations, et la convergence quadratique se voit dans la colonne du gradient : sur les dernières itérations, chaque norme vaut environ 40 fois le carré de la précédente ( , puis , , ). Le nombre de chiffres exacts double à chaque pas. La descente de gradient, avec le pas classique , en demande 146 ;
- le conditionnement vaut 35,8 à l’optimum, contre 3 en dans M10. La hessienne pondère chaque région par : une fois le modèle entraîné, la plupart des régions sont prédites avec confiance et pèsent peu, et la courbure devient plus inégale. Newton s’en moque, la descente de gradient le paie ;
- les poids se lisent (features standardisées) :
depuis_dernier( ),log_acces( ) etpic_imminent( ) portent le modèle,periodique( ) ne sert à rien une fois l’interaction donnée. C’est ce que le chemin de M11 avait trouvé ; - F1 de test : 0,689, au niveau de la LR avec features de M9 (0,686, avec une autre échelle et une autre régularisation) et de LightGBM (0,681).
Le MLP, entièrement en NumPy
Cette fois, on donne au modèle les 4 features brutes, standardisées, sans le log ni l’interaction. 16 neurones cachés, rétropropagation à la main, AdamW en mini-batchs de 64.
# suite du bloc précédent (make_regions, f1, sigmoide, Xtr, Xte, ytr, yte déjà définis)
# un MLP sur les 4 features BRUTES (standardisées) : il doit trouver seul l'interaction « périodique × pic imminent »
m_b, s_b = Xtr.mean(axis=0), Xtr.std(axis=0)
Btr, Bte = (Xtr - m_b) / s_b, (Xte - m_b) / s_b
H = 16                                                         # neurones cachés


def init(rng):
    """Initialisation de He (M7 : variance 2/fan_in) pour des couches ReLU."""
    return {"W1": rng.normal(0, np.sqrt(2 / 4), (4, H)), "b1": np.zeros(H),
            "W2": rng.normal(0, np.sqrt(2 / H), H), "b2": 0.0}


def forward(P, X):
    Z1 = X @ P["W1"] + P["b1"]                                 # M2 : une transformation affine...
    A1 = np.maximum(Z1, 0)                                     # ... puis une non-linéarité
    return Z1, A1, sigmoide(A1 @ P["W2"] + P["b2"])


def backward(P, X, y):
    """M5 : rétropropagation écrite à la main, couche par couche."""
    Z1, A1, p = forward(P, X)
    n = len(y)
    d2 = (p - y) / n                                           # ∂L/∂z2, même simplification que la LR
    d1 = np.outer(d2, P["W2"]) * (Z1 > 0)                      # ∂L/∂z1 : on remonte W2, puis la dérivée de ReLU
    return {"W1": X.T @ d1, "b1": d1.sum(axis=0), "W2": A1.T @ d2, "b2": d2.sum()}


def log_loss(P, X, y):
    p = np.clip(forward(P, X)[2], 1e-12, 1 - 1e-12)
    return -np.mean(y * np.log(p) + (1 - y) * np.log(1 - p))


# 1. vérifier la rétropropagation par différences finies (M4) sur 200 exemples
P = init(np.random.default_rng(1))
Xs, ys = Btr[:200], ytr[:200]
g = backward(P, Xs, ys)
ecart = 0.0
for k, idx in (("W1", (0, 0)), ("W1", (3, 7)), ("W2", (5,)), ("b1", (2,))):
    plus, moins = {c: np.copy(a) for c, a in P.items()}, {c: np.copy(a) for c, a in P.items()}
    plus[k][idx] += 1e-6
    moins[k][idx] -= 1e-6
    num = (log_loss(plus, Xs, ys) - log_loss(moins, Xs, ys)) / 2e-6
    ecart = max(ecart, abs(num - g[k][idx]))
print(f"écart rétropropagation / différences finies : {ecart:.1e}")

# 2. entraîner avec AdamW (M10 + M11), mini-batchs de 64
P, rng_b = init(np.random.default_rng(1)), np.random.default_rng(2)
m = {k: np.zeros_like(v) for k, v in P.items()}
v = {k: np.zeros_like(v) for k, v in P.items()}
eta, wd, t = 0.01, 1e-4, 0
for epoque in range(1, 101):
    ordre = rng_b.permutation(len(ytr))
    for debut in range(0, len(ytr), 64):
        i = ordre[debut:debut + 64]
        g, t = backward(P, Btr[i], ytr[i]), t + 1
        for k in P:
            m[k] = 0.9 * m[k] + 0.1 * g[k]
            v[k] = 0.999 * v[k] + 0.001 * g[k] ** 2
            P[k] = P[k] - eta * (m[k] / (1 - 0.9 ** t)) / (np.sqrt(v[k] / (1 - 0.999 ** t)) + 1e-8)
            if k.startswith("W"):
                P[k] = P[k] * (1 - eta * wd)                   # AdamW : le weight decay à part
    if epoque in (1, 10, 50, 100):
        p_te_mlp = forward(P, Bte)[2]
        print(f"époque {epoque:>3} : log-loss train = {log_loss(P, Btr, ytr):.4f} | test = {log_loss(P, Bte, yte):.4f} "
              f"| F1 de test = {f1(yte, (p_te_mlp > 0.5).astype(int)):.3f}")

# 3. le MLP a-t-il trouvé l'interaction ? probabilité moyenne prédite par groupe (test)
per, pic = Xte[:, 2] == 1, Xte[:, 3] < 3
for nom, g_ in (("périodique, pic imminent", per & pic), ("périodique, pic lointain", per & ~pic),
                ("non périodique", ~per)):
    print(f"{nom:<25} : p moyen MLP = {p_te_mlp[g_].mean():.3f} | fréquence réelle = {yte[g_].mean():.3f} | n = {g_.sum()}")
| Époque | Log-loss d’entraînement | Log-loss de test | F1 de test |
|---|---|---|---|
| 1 | 0,3308 | 0,3496 | 0,643 |
| 10 | 0,2864 | 0,2980 | 0,684 |
| 50 | 0,2780 | 0,3004 | 0,692 |
| 100 | 0,2750 | 0,3011 | 0,682 |
| Groupe (jeu de test) | moyen prédit par le MLP | Fréquence réelle | Régions |
|---|---|---|---|
| périodique, pic imminent | 0,751 | 0,811 | 106 |
| périodique, pic lointain | 0,197 | 0,170 | 288 |
| non périodique | 0,205 | 0,177 | 1 106 |
Ce qu’on lit :
- la rétropropagation est juste : écart de avec les différences finies. C’est le test à faire chaque fois que tu écris un gradient à la main ;
- le MLP a trouvé l’interaction tout seul : il donne 0,751 aux régions périodiques dont le pic approche, et 0,197 aux autres régions périodiques, comme aux non périodiques. La LR sur ces mêmes features brutes ne pouvait pas faire cette distinction (F1 de 0,582 en M9) ; le MLP arrive à 0,682, au niveau de la LR à qui on a donné les bonnes features ;
- le surapprentissage se voit : la log-loss d’entraînement baisse jusqu’au bout (0,2750), celle de test est au plus bas vers l’époque 10 (0,2980) puis remonte. Le F1 fluctue entre 0,682 et 0,692 sans tendance claire. On arrêterait l’entraînement plus tôt, sur un jeu de validation (early stopping, partie 22).
Comparer et regarder dedans : M9 et M3
# suite des deux blocs précédents
from scipy import stats

# 1. M9 : bootstrap apparié et McNemar, LR + features (NumPy) contre MLP sur features brutes
pred_lr, pred_mlp = (p_te > 0.5).astype(int), (p_te_mlp > 0.5).astype(int)
idx = np.random.default_rng(0).integers(0, len(yte), (2000, len(yte)))
delta = np.array([f1(yte[i], pred_mlp[i]) - f1(yte[i], pred_lr[i]) for i in idx])
lo, hi = np.percentile(delta, [2.5, 97.5])
ok_lr, ok_mlp = pred_lr == yte, pred_mlp == yte
n01, n10 = int(np.sum(ok_lr & ~ok_mlp)), int(np.sum(~ok_lr & ok_mlp))
print(f"ΔF1 (MLP − LR) = {f1(yte, pred_mlp) - f1(yte, pred_lr):+.3f}, IC 95 % [{lo:+.3f} ; {hi:+.3f}] "
      f"| McNemar : {n01} contre {n10}, p = {stats.binomtest(n01, n01 + n10, 0.5).pvalue:.2g}")

# 2. M3 : la PCA de la couche cachée. Combien de dimensions le MLP utilise-t-il vraiment ?
A1 = forward(P, Bte)[1]
morts = int(np.sum(A1.max(axis=0) == 0))
s = np.linalg.svd(A1 - A1.mean(axis=0), compute_uv=False)
part = np.cumsum(s ** 2) / np.sum(s ** 2)
print(f"neurones jamais actifs : {morts} sur {H} | variance expliquée par 1, 2, 3, 4 composantes : {part[:4].round(3)}")
- M9 : les deux modèles sont à égalité. Le MLP fait de F1 par rapport à la LR avec features, avec un intervalle apparié qui contient 0. Sur les 39 régions où ils sont en désaccord, la LR a raison 24 fois et le MLP 15 fois, : rien de significatif. La bonne conclusion n’est pas « la LR est meilleure », c’est « le MLP retrouve, sans aide, ce que le feature engineering avait apporté ». Sur des traces réelles, où personne ne connaît la bonne interaction à l’avance, c’est tout l’intérêt.
- M3 : la couche cachée vit en peu de dimensions. Aucun des 16 neurones n’est mort (tous s’activent sur au moins une région de test). Mais la PCA de leurs activations montre que 4 directions portent 88,1 % de la variance (40,5 % pour la première, 65,7 % pour deux, 79,6 % pour trois). L’entrée a 4 dimensions, le réseau la redéploie sur 16 coordonnées, et l’essentiel reste dans un sous-espace de petite dimension, comme le nuage de points de M3.
Exercice pratique
- À la main. Dérive le gradient et la hessienne de la log-loss régularisée en partant de . Montre que la hessienne est définie positive dès que et que la colonne de l’intercept n’est pas nulle.
- Newton contre gradient. Refais le premier bloc avec , puis . Comment évoluent le nombre d’itérations de Newton, celui de la descente de gradient et le conditionnement de la hessienne à l’optimum ? Relie la réponse au terme .
- Deux couches cachées. Ajoute une deuxième couche cachée de 8 neurones au MLP. Réécris
backward(un de plus) et vérifie-le par différences finies avant d’entraîner : l’écart doit rester sous . - Early stopping. Sépare 20 % du jeu d’entraînement en validation. Entraîne le MLP 100 époques en gardant les paramètres de la meilleure log-loss de validation. À quelle époque s’arrête-t-il ? Compare le F1 de test avec celui de l’époque 100, puis fais le test de McNemar entre les deux.
- Le fil rouge, réécrit avec les maths. Reprends le projet de la partie 24 et annote chaque étape avec la notion qui la justifie : la standardisation (M1), le découpage temporel plutôt qu’aléatoire (M7), la perte (M8), l’optimiseur et son learning rate (M10), la régularisation (M11), la comparaison des modèles (M9), la surveillance du drift (M9), la rétropropagation à travers le temps du LSTM (M5). Si une étape n’a pas de justification, c’est un signal.
- Bonus. Donne au MLP les 4 features métier au lieu des features brutes. Gagne-t-il quelque chose par rapport à la LR ? Que dit le bootstrap apparié ?
Indice pour la question 1 : pour tout , . Le second terme est strictement positif dès que a une composante hors intercept ; sinon, pour tout et c’est le premier qui l’est.
Bilan du programme de maths, et la suite
Ce qui a été couvert. Trois blocs, qui répondent chacun à une question :
- comment représenter : vecteurs, normes, matrices, valeurs propres et SVD (M1 à M3) ;
- comment apprendre : gradient, règle de la chaîne, hessienne, descente de gradient et régularisation (M4 à M6, M10, M11) ;
- comment raisonner sous incertitude : variables aléatoires, vraisemblance, entropie et statistique inférentielle (M7 à M9).
Avec ça, tu peux lire un fit() comme une suite d’équations, ce qui était l’objectif de la feuille de route.
Ce qui reste à approfondir, quand le besoin s’en fera sentir :
- les séries temporelles : autocorrélation, stationnarité, validation par blocs. Les traces DAMON sont des séries, et c’est le sujet qu’on a le plus survolé (M7, M9) ;
- l’algèbre linéaire numérique : stabilité,
float32contrefloat64, pourquoi on résout un système au lieu d’inverser une matrice ; - l’optimisation convexe plus loin que KKT : dualité, méthodes proximales, garanties de convergence du SGD ;
- l’inférence bayésienne au-delà de l’a priori gaussien : incertitude sur les prédictions, utile pour décider quand une prédiction est assez sûre pour déplacer une page vers zswap.
La suite. La phase technique commence à la partie 13 et reprend tout ça avec de vrais outils : préparation des données sans fuite, évaluation, modèles linéaires, arbres, PyTorch, LSTM, puis la mise en production. Le projet fil rouge (partie 24) remplacera enfin les régions synthétiques par de vraies traces DAMON, et c’est là que le mémoire commence pour de bon.
Ressources pour aller plus loin
- Deisenroth, Faisal et Ong, Mathematics for Machine Learning, partie II (chapitres 8 à 12) : régression, PCA, mélanges gaussiens et SVM dérivés avec les outils de la partie I, gratuit en ligne.
- Goodfellow, Bengio et Courville, Deep Learning, partie I (chapitres 2 à 5) : la révision complète des maths du deep learning, gratuit en ligne.
- Bishop, Pattern Recognition and Machine Learning, section 4.3 (régression logistique et IRLS) et chapitre 5 (réseaux de neurones et rétropropagation).
- Andrew Ng, notes du cours CS229 de Stanford, partie sur la régression logistique et la méthode de Newton.
- Michael Nielsen, Neural Networks and Deep Learning, chapitre 2 : la rétropropagation dérivée pas à pas, gratuit en ligne.
- Andrej Karpathy, micrograd : un moteur d’autodiff en une centaine de lignes, pour voir la règle de la chaîne de M5 devenir un outil.
Ce que tu dois savoir faire avant de passer à la suite
- Dériver la perte, le gradient et la hessienne de la régression logistique, et dire d’où vient chaque terme (M1, M2, M4 à M8)
- Expliquer pourquoi la régression logistique est convexe et un MLP ne l’est pas
- Implémenter une régression logistique sans bibliothèque, par descente de gradient et par Newton
- Écrire la rétropropagation d’un MLP à une couche cachée et la vérifier par différences finies
- Expliquer mathématiquement chaque étape d’un entraînement : initialisation, perte, gradient, pas, régularisation, arrêt
- Comparer deux modèles avec un bootstrap apparié et McNemar, et conclure correctement à une égalité
- Placer chaque notion M1 à M11 dans au moins un modèle de la phase technique
Partie suivante : Partie 13 · Le cadre du ML supervisé, revu à froid. Le début de la phase technique : on reprend le ML supervisé avec les maths en main.