M6 · Hessienne, convexité et développement de Taylor
Pourquoi certaines pertes sont faciles à optimiser et d'autres non : courbure, convexité, conditionnement et méthode de Newton.
Mastering AI · Required Maths · Semaine 2 (calcul différentiel) · Partie 6
Objectif de l’étape
Le gradient (M4) dit dans quelle direction descendre. Il ne dit pas jusqu’où on peut aller sans se tromper, ni si le fond de la vallée est unique. Ces deux informations viennent de la courbure, mesurée par la dérivée seconde et, en plusieurs dimensions, par la matrice hessienne.
À la fin de cet article, tu sauras :
- approcher une fonction par un polynôme de Taylor d’ordre 1 ou 2, et estimer l’erreur commise ;
- calculer et interpréter une hessienne, avec ses valeurs propres ;
- reconnaître une fonction convexe, et montrer que la log-loss l’est ;
- expliquer le conditionnement, le pas maximal d’une descente de gradient et la méthode de Newton ;
- reconnaître un point selle.
Notions clés
1. Le développement de Taylor
Intuition. Près d’un point, une fonction lisse ressemble à une droite (ordre 1, la tangente de M4). Si on veut mieux, on ajoute un terme de courbure : elle ressemble alors à une parabole (ordre 2).
En une variable, autour de :
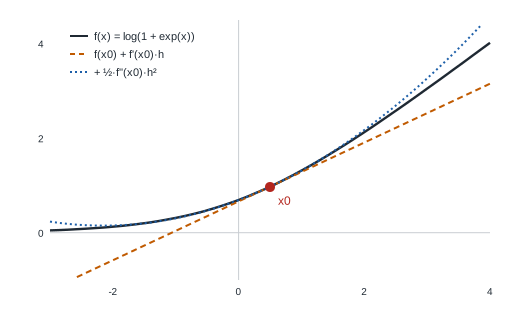
L’erreur de l’ordre 1 est proportionnelle à , celle de l’ordre 2 à . Diviser par 2 divise donc la première erreur par 4 et la seconde par 8. C’est ce qui explique l’avantage de la différence centrée en M4 : les termes en s’y annulent.
En plusieurs variables, le terme d’ordre 1 est un produit scalaire avec le gradient, et celui d’ordre 2 fait intervenir la hessienne :
2. La hessienne : la courbure dans toutes les directions
Intuition. Le gradient donne la pente dans chaque direction. La hessienne donne la courbure dans chaque direction : est-ce que la pente s’accentue (vallée), s’adoucit (sommet), ou les deux selon la direction (col) ?
Pour une fonction lisse, est symétrique. Le théorème spectral de M3 s’applique : a des valeurs propres réelles et des directions propres orthogonales. Chaque valeur propre est la courbure le long de sa direction propre :
- : la fonction remonte des deux côtés, comme une vallée ;
- : elle redescend des deux côtés, comme un sommet ;
- : elle est plate, au moins à l’ordre 2.
Exemple : pour la quadratique , la hessienne est simplement .
3. Convexité
Intuition. Une fonction convexe a la forme d’un bol : le segment entre deux points du graphe reste toujours au-dessus du graphe. Conséquence capitale : tout minimum local est un minimum global. Une descente ne peut pas rester coincée dans un mauvais creux.
Critère pratique : une fonction deux fois dérivable est convexe si et seulement si sa hessienne est semi-définie positive partout, c’est-à-dire si toutes ses valeurs propres sont , ou encore si pour tout .
La log-loss est convexe. Sa hessienne vaut :
Pour tout vecteur , , puisque chaque terme est un poids positif fois un carré. La régression logistique a donc un unique creux : on est sûr de trouver le meilleur modèle. La MSE de la régression linéaire est convexe aussi ( ).
Un réseau de neurones n’est pas convexe. Exemple simple : permuter deux neurones cachés donne exactement le même réseau, donc la même perte. Il y a plusieurs minima distincts, ce qu’une fonction strictement convexe ne permet pas.
4. Points selles
Intuition. Un col de montagne : en suivant la route, on est au point le plus haut ; en regardant vers les sommets de part et d’autre, on est au point le plus bas. Le gradient y est nul, mais ce n’est ni un minimum ni un maximum.
Pour , la hessienne en a pour valeurs propres et . En grande dimension, les points selles sont bien plus nombreux que les minima locaux : c’est une des raisons pour lesquelles les réseaux s’entraînent mieux qu’on ne le craignait.
5. Conditionnement et taille du pas
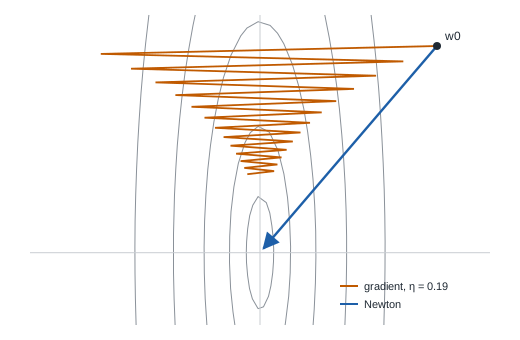
Intuition. Si la vallée est très pentue dans une direction et presque plate dans une autre, un pas assez grand pour avancer dans la direction plate fait rebondir dans la direction pentue. On zigzague.
Le conditionnement mesure cet écart. Pour une descente de gradient sur une quadratique, on peut montrer avec la hessienne que :
- elle converge seulement si ;
- avec le meilleur pas, l’erreur diminue d’un facteur environ par itération : très lentement si est grand.
C’est pour ça qu’on standardise les features (M1, partie 14) : des features d’échelles très différentes donnent une hessienne mal conditionnée.
6. La méthode de Newton
Intuition. Au lieu de suivre la pente, on remplace la fonction par sa parabole de Taylor d’ordre 2 et on saute directement au fond de cette parabole. En annulant le gradient de l’approximation, on obtient :
Sur une quadratique, Newton arrive au minimum en un seul pas, quel que soit . Sur la log-loss, il converge en quelques itérations. Son prix : stocker et résoudre un système avec la hessienne, de taille . Raisonnable pour 9 features, impossible pour un réseau d’un million de poids. C’est pourquoi le deep learning utilise des méthodes du premier ordre plus astucieuses (momentum, Adam, M10), qui imitent en partie l’effet de la courbure.
Exemple de code
Taylor : l’erreur en et en
import numpy as np

f = lambda x: np.log(1 + np.exp(x))            # softplus
f1 = lambda x: 1 / (1 + np.exp(-x))            # f'  = sigmoïde
f2 = lambda x: f1(x) * (1 - f1(x))             # f'' = σ(1 − σ)
x0 = 0.5
print("h        erreur ordre 1    erreur ordre 2")
for h in (0.5, 0.25, 0.125, 0.0625):
    t1 = f(x0) + f1(x0) * h
    t2 = t1 + 0.5 * f2(x0) * h**2
    print(f"{h:<8} {abs(f(x0 + h) - t1):.2e}          {abs(f(x0 + h) - t2):.2e}")
| Erreur ordre 1 | Erreur ordre 2 | |
|---|---|---|
| 0,5 | ||
| 0,25 | ||
| 0,125 | ||
| 0,0625 |
Quand est divisé par 2, l’erreur d’ordre 1 est divisée par 4 environ, celle d’ordre 2 par 8 environ : c’est bien du et du .
Conditionnement, pas maximal et Newton
import numpy as np

A = np.array([[10.0, 0.0], [0.0, 0.2]])        # courbures très différentes selon les axes
q = lambda w: 0.5 * w @ A @ w
grad_q = lambda w: A @ w
vals = np.linalg.eigvalsh(A)
print("valeurs propres de la hessienne :", vals, "| conditionnement κ =", vals.max() / vals.min())


def descente(w, eta, n_iter):
    chemin = [w.copy()]
    for _ in range(n_iter):
        w = w - eta * grad_q(w)
        chemin.append(w.copy())
    return np.array(chemin)


w0 = np.array([1.0, 2.0])
for eta in (0.05, 0.19, 0.21):
    ch = descente(w0, eta, 100)
    print(f"descente η={eta}: q après 100 itérations = {q(ch[-1]):.2e}")
newton = w0 - np.linalg.solve(A, grad_q(w0))
print("Newton, 1 itération :", newton, "| q =", q(newton))
| Méthode | après 100 itérations |
|---|---|
| gradient, | |
| gradient, | |
| gradient, | (divergence) |
| Newton, 1 itération |
Avec , la limite théorique est . À , ça converge en zigzaguant ; à , ça explose. Un pas prudent ( ) évite les rebonds mais avance à peine dans la direction plate ( ).
La log-loss est convexe, et Newton y excelle
On reprend les données de M4 et on calcule la hessienne .
import numpy as np

rng = np.random.default_rng(0)
n, d = 500, 3
X = rng.normal(size=(n, d))
sig = lambda z: 1 / (1 + np.exp(-z))
y = (rng.random(n) < sig(X @ np.array([1.5, -2.0, 0.5]))).astype(float)
loss = lambda w: -np.mean(y * np.log(sig(X @ w)) + (1 - y) * np.log(1 - sig(X @ w)))
grad = lambda w: X.T @ (sig(X @ w) - y) / n
hess = lambda w: (X.T * (sig(X @ w) * (1 - sig(X @ w)))) @ X / n

for _ in range(3):
    w = rng.normal(size=d) * 3
    print("valeurs propres de H en un w aléatoire :", np.linalg.eigvalsh(hess(w)).round(4))

# Newton contre descente de gradient
w_n, w_g = np.zeros(d), np.zeros(d)
for k in range(1, 201):
    w_n = w_n - np.linalg.solve(hess(w_n), grad(w_n)) if k <= 8 else w_n
    w_g = w_g - 1.0 * grad(w_g)
    if k in (1, 2, 3, 5, 8, 50, 200):
        print(f"itération {k:>3} | Newton : {loss(w_n):.6f} | gradient : {loss(w_g):.6f}")
En trois points tirés au hasard, toutes les valeurs propres de sont positives (par exemple , et ) : la log-loss est bien convexe.
| Itération | Newton | Descente de gradient |
|---|---|---|
| 1 | 0,486768 | 0,618094 |
| 3 | 0,463187 | 0,544190 |
| 5 | 0,463175 | 0,511440 |
| 50 | 0,463175 | 0,463258 |
| 200 | 0,463175 | 0,463175 |
Newton atteint l’optimum à six décimales en 5 itérations ; la descente de gradient en met 200. Chaque itération de Newton coûte plus cher (une hessienne à construire et un système à résoudre), mais avec 3 paramètres, c’est négligeable.
Exercice pratique
- Taylor à la main. Écris le développement d’ordre 2 de et de autour de 0. Pour , compare les approximations aux vraies valeurs.
- Hessienne d’un point selle. Calcule à la main la hessienne de (la « selle de singe »). Que valent ses valeurs propres en ? Et en ?
- Le pas maximal. Pour , prédis le pas maximal de la descente de gradient, puis vérifie-le en essayant et .
- Standardiser améliore le conditionnement. Construis une matrice
de 2 features, l’une en millisecondes (valeurs autour de 500), l’autre entre 0 et 1. Calcule le conditionnement de
avant et après
StandardScaler. Fais le lien avec la vitesse de la descente de gradient. - Fil rouge. Pour une régression logistique sur 9 features, la hessienne fait
. Est-ce raisonnable d’utiliser Newton ? C’est d’ailleurs ce que fait le solveur
newton-cgde scikit-learn. Et pour un LSTM de 50 000 poids ?
Indice pour la question 3 : la limite est .
Ressources pour aller plus loin
- Boyd et Vandenberghe, Convex Optimization, chapitre 3 (fonctions convexes) et section 9.5 (méthode de Newton), gratuit en ligne.
- Deisenroth et al., Mathematics for Machine Learning, sections 5.8 (Taylor) et 7.3 (optimisation convexe).
- Dauphin et al., Identifying and attacking the saddle point problem in high-dimensional non-convex optimization (NeurIPS 2014).
- Distill, Why Momentum Really Works : le conditionnement en images interactives (on y reviendra en M10).
Ce que tu dois savoir faire avant de passer à la suite
- Écrire un développement de Taylor d’ordre 2, en une et plusieurs variables
- Calculer une hessienne et interpréter ses valeurs propres comme des courbures
- Reconnaître une fonction convexe et montrer que la log-loss l’est
- Distinguer minimum, maximum et point selle avec la hessienne
- Expliquer le conditionnement et le pas maximal
- Expliquer pourquoi Newton converge vite et pourquoi on ne l’utilise pas pour les grands réseaux
Partie suivante : M7 · Variables aléatoires, lois, espérance et variance. On ouvre la semaine de probabilités : le vocabulaire minimal pour raisonner sur l’incertain.