M3 · Valeurs propres, SVD et PCA
Les directions qu'une matrice ne fait qu'étirer, la décomposition SVD, et ce que fait vraiment une PCA.
Mastering AI · Required Maths · Semaine 1 (algèbre linéaire) · Partie 3
Objectif de l’étape
M2 a montré qu’une matrice tord l’espace. Cet article répond à la question suivante : existe-t-il des directions que la matrice ne tord pas, qu’elle se contente d’étirer ? La réponse donne trois outils qu’on utilisera partout :
- les valeurs et vecteurs propres, qui décrivent une matrice par ses directions privilégiées ;
- la SVD, qui décompose n’importe quelle matrice en rotation, étirement, rotation ;
- la PCA, qui en découle directement et réduit la dimension des données en gardant l’essentiel de leur variance.
À la fin de cet article, tu sauras recoder une PCA à partir de zéro, interpréter la variance expliquée, et savoir ce qu’une PCA peut et ne peut pas voir dans des profils d’accès mémoire.
Notions clés
1. Vecteurs propres : les directions qui ne tournent pas
Intuition. Applique une matrice à tous les vecteurs du plan. La plupart changent de direction. Quelques directions spéciales sont seulement allongées, raccourcies ou retournées : ce sont les directions propres, et le facteur d’étirement est la valeur propre.
- : la direction est étirée ; : elle est contractée ; : elle est retournée ; : elle est écrasée (elle est dans le noyau, M2).
- Le déterminant est le produit des valeurs propres : . C’est cohérent avec l’idée de facteur de volume de M2 : on multiplie les étirements de chaque direction.
Pourquoi c’est utile. Dans la base des vecteurs propres, la matrice devient diagonale : elle n’est plus qu’une liste d’étirements indépendants. Appliquer cent fois revient à élever chaque à la puissance 100. Les directions où explosent et celles où disparaissent. C’est exactement le mécanisme des gradients qui explosent ou disparaissent dans un RNN, où la même matrice est appliquée à chaque pas de temps (partie 23).
2. Le cas des matrices symétriques
Intuition. Les matrices symétriques ( ) sont les plus agréables : elles étirent l’espace le long d’axes perpendiculaires, sans aucun cisaillement. Un cercle devient une ellipse dont les axes sont les vecteurs propres.
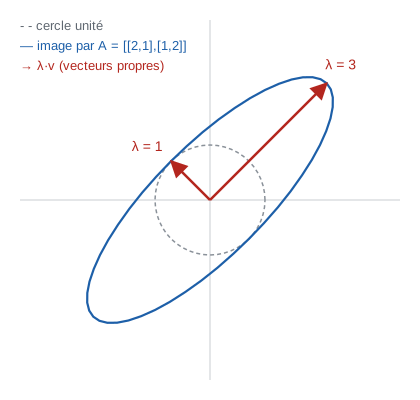
Sur cette figure, la matrice étire d’un facteur 3 la direction de la diagonale et laisse intacte la direction perpendiculaire. Ces deux directions sont exactement les axes de l’ellipse.
Théorème spectral. Une matrice symétrique réelle a des valeurs propres réelles et des vecteurs propres orthogonaux. On peut donc l’écrire :
avec orthogonale (ses colonnes sont les vecteurs propres, de norme 1) et diagonale (les valeurs propres). Lecture de droite à gauche : on tourne pour s’aligner sur les axes propres ( ), on étire chaque axe ( ), on tourne pour revenir ( ).
Les matrices symétriques sont partout en ML : la matrice de covariance des données, dans les moindres carrés, et la Hessienne d’une fonction de perte (M6).
3. La SVD : la décomposition universelle
Intuition. Le théorème spectral ne marche que pour les matrices carrées symétriques. La SVD généralise l’idée à n’importe quelle matrice, même rectangulaire : toute transformation linéaire est une rotation, puis un étirement le long des axes, puis une autre rotation.
- : une rotation dans l’espace de départ ;
- : un étirement le long des axes, par les valeurs singulières ;
- : une rotation dans l’espace d’arrivée.
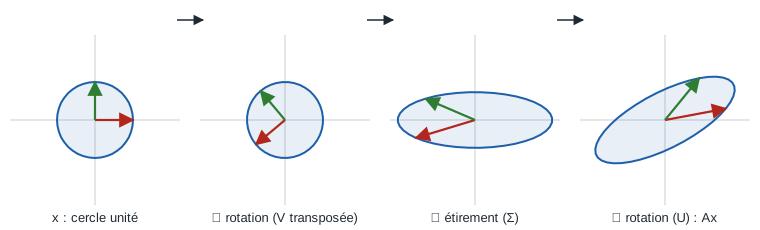
Les flèches rouge et verte suivent et à chaque étape. La rotation ne déforme rien ; tout l’aplatissement vient de ; la rotation oriente le résultat. Les trois étapes réunies donnent exactement l’effet de .
Le rang de est le nombre de valeurs singulières non nulles. Le lien avec ce qui précède : les valeurs singulières de sont les racines carrées des valeurs propres de , et les colonnes de en sont les vecteurs propres.
Approximation de rang . On peut écrire comme une somme de matrices de rang 1, classées par importance :
Garder les premiers termes donne la meilleure approximation possible de rang (théorème d’Eckart-Young). C’est la base de la compression, de la PCA et des systèmes de recommandation.
4. La PCA, déduite de tout ça
Intuition. Ton nuage de points vit dans , mais il est souvent « aplati » : il s’étale beaucoup dans certaines directions et très peu dans d’autres. La PCA trouve les directions où les données varient le plus, puis projette dessus.
En trois étapes :
- Centrer les données : .
- Calculer la matrice de covariance . Elle est symétrique, donc diagonalisable avec des axes orthogonaux.
- Ses vecteurs propres sont les composantes principales, et ses valeurs propres sont les variances le long de chaque composante → voir M7 pour la covariance.
En pratique, on ne calcule même pas : on fait directement la SVD de . Les lignes de sont les composantes, et la variance de la composante vaut . C’est plus stable numériquement.
Variance expliquée. La part de variance captée par la composante est :
Si les deux premières composantes captent 95 % de la variance, on peut représenter les données en 2D en perdant peu d’information.
Limites à garder en tête :
- la PCA ne voit que des structures linéaires et des directions de variance ; une variable très prédictive mais peu variable peut être écartée ;
- elle est sensible à l’échelle : il faut standardiser les features avant (M1) ;
- le signe des composantes est arbitraire : et sont la même direction.
Exemple de code
Vecteurs propres d’une matrice symétrique
Ce script reproduit la figure de la section 2.
import numpy as np
import matplotlib.pyplot as plt

A = np.array([[2.0, 1.0],
              [1.0, 2.0]])                  # symétrique
valeurs, vecteurs = np.linalg.eigh(A)       # eigh : pour les matrices symétriques
print("valeurs propres :", valeurs)
print("vecteurs propres (colonnes) :\n", vecteurs.round(4))
for lam, v in zip(valeurs, vecteurs.T):
    print(f"A v = {A @ v} ; lambda v = {lam * v}")
print("vecteurs orthogonaux ?", np.isclose(vecteurs[:, 0] @ vecteurs[:, 1], 0))

theta = np.linspace(0, 2 * np.pi, 200)
cercle = np.stack([np.cos(theta), np.sin(theta)])
ellipse = A @ cercle
fig, ax = plt.subplots(figsize=(5, 5))
ax.plot(*cercle, c="lightgray", label="cercle unité")
ax.plot(*ellipse, c="tab:blue", label="image par A")
for lam, v in zip(valeurs, vecteurs.T):
    ax.arrow(0, 0, *(lam * v), color="tab:red", width=0.03, length_includes_head=True)
ax.set_aspect("equal")
ax.legend()
ax.set_title("Les axes de l'ellipse sont les vecteurs propres")
plt.show()
Les valeurs propres sont et , pour les directions et , qui sont orthogonales. Vérifie : .
Une PCA à la main, comparée à scikit-learn
On fabrique un nuage 2D allongé, tourné et décalé, puis on retrouve ses axes.
import numpy as np
from sklearn.decomposition import PCA

rng = np.random.default_rng(0)
n = 500
z = rng.normal(size=(n, 2)) * [3.0, 0.5]                   # beaucoup de variance sur un axe
R = np.array([[np.cos(0.6), -np.sin(0.6)], [np.sin(0.6), np.cos(0.6)]])
X = z @ R.T + [5.0, 2.0]                                    # tourné et décalé

Xc = X - X.mean(axis=0)                                     # 1. centrer
U, S, Vt = np.linalg.svd(Xc, full_matrices=False)           # 2. SVD
composantes = Vt                                            # directions principales (lignes)
variance_expliquee = S**2 / (n - 1)
ratio = variance_expliquee / variance_expliquee.sum()
print("PCA à la main : composantes\n", composantes.round(4), "\nratio :", ratio.round(4))

pca = PCA().fit(X)
print("PCA sklearn   : composantes\n", pca.components_.round(4),
      "\nratio :", pca.explained_variance_ratio_.round(4))

C = np.cov(Xc, rowvar=False)
val_c, vec_c = np.linalg.eigh(C)
print("valeurs propres de la covariance :", val_c[::-1].round(4),
      "| S^2/(n-1) :", variance_expliquee.round(4))
Ce qu’on observe :
- la première composante capte 97,4 % de la variance, comme attendu pour un nuage presque unidimensionnel ;
- la direction trouvée, , correspond à l’angle de rotation de 0,6 radian utilisé pour fabriquer les données ( , ) ;
- notre version et celle de scikit-learn ont des signes opposés : c’est normal, la direction est la même ;
- les valeurs propres de la covariance ( et ) sont exactement : covariance et SVD disent la même chose.
Ce que la PCA voit dans des profils d’accès mémoire
On reprend l’idée de M1 : chaque région est décrite par ses accès sur 50 agrégations, soit un point de . On génère 400 profils de quatre types.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA

rng = np.random.default_rng(0)


def profil(type_, rng, L=50):
    t = np.arange(L)
    if type_ == "périodique":
        periode = rng.integers(8, 15)
        return (((t + rng.integers(0, periode)) % periode) < 2) * rng.uniform(3, 8)
    if type_ == "chaude":
        return rng.poisson(rng.uniform(2, 6), L).astype(float)
    if type_ == "froide":
        return rng.poisson(0.05, L).astype(float)
    # rafale : une seule période d'activité intense
    debut = rng.integers(0, L - 10)
    x = np.zeros(L)
    x[debut:debut + rng.integers(5, 10)] = rng.uniform(4, 8)
    return x


types = ["périodique", "chaude", "froide", "rafale"]
etiquettes = rng.choice(types, size=400)
P = np.array([profil(ty, rng) for ty in etiquettes])

pca_p = PCA(n_components=10).fit(P)
print("variance expliquée par composante :", pca_p.explained_variance_ratio_.round(3))
print("cumulée :", np.cumsum(pca_p.explained_variance_ratio_).round(3))
print("composante 1 (début) :", pca_p.components_[0, :10].round(3))

Z = pca_p.transform(P)[:, :2]
fig, ax = plt.subplots(figsize=(6, 5))
for ty in types:
    m = etiquettes == ty
    ax.scatter(Z[m, 0], Z[m, 1], s=10, label=ty)
ax.set_xlabel("composante 1")
ax.set_ylabel("composante 2")
ax.legend()
ax.set_title("400 profils de R^50 projetés sur 2 dimensions")
plt.show()
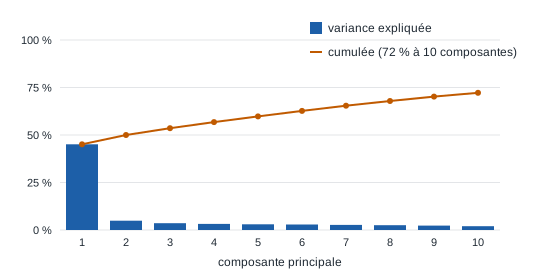
Résultats :
- la composante 1 capte 45 % de la variance. Ses coefficients sont tous positifs et presque égaux (autour de 0,14) : c’est simplement l’intensité globale du profil. Sur le nuage de points, elle sépare nettement les régions froides (à gauche) des régions chaudes (à droite) ;
- la composante 2 ne capte que 5 %. Elle étale les rafales selon qu’elles arrivent tôt ou tard dans la fenêtre ;
- au-delà, la variance est éparpillée : 10 composantes n’expliquent que 72 % du total ;
- les profils périodiques se superposent aux rafales. La PCA ne les distingue pas.
Le dernier point est le plus instructif. Comme dans M1, les profils périodiques ont des phases aléatoires : deux régions au même rythme mais décalées sont des vecteurs presque orthogonaux. Il n’existe donc pas de direction unique de qui représente « être périodique », et une méthode linéaire ne peut pas trouver ce qui n’est pas une direction. La solution reste la même : construire des features invariantes au décalage (période, phase, autocorrélation) avant toute analyse. On refera cette PCA en partie 20, sur les features de la partie 14 plutôt que sur les profils bruts.
Compresser une image par SVD tronquée
Une image en niveaux de gris est une matrice. Sa SVD tronquée en donne la meilleure approximation de rang .
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_sample_image

img = load_sample_image("china.jpg").mean(axis=2)   # niveaux de gris, 427 x 640
U, S, Vt = np.linalg.svd(img, full_matrices=False)

rangs = [5, 20, 50, 100]
fig, axes = plt.subplots(1, len(rangs) + 1, figsize=(18, 3.5))
axes[0].imshow(img, cmap="gray")
axes[0].set_title(f"original (rang {np.linalg.matrix_rank(img)})")
for ax, k in zip(axes[1:], rangs):
    approx = U[:, :k] @ np.diag(S[:k]) @ Vt[:k]
    erreur = np.linalg.norm(img - approx) / np.linalg.norm(img)
    taille = k * (img.shape[0] + img.shape[1] + 1) / img.size
    ax.imshow(approx, cmap="gray")
    ax.set_title(f"rang {k} : erreur {erreur:.1%}, taille {taille:.0%}")
    print(f"rang {k:>3} : erreur relative = {erreur:.3f}, taille = {taille:.3f}")
for ax in axes:
    ax.axis("off")
plt.tight_layout()
plt.show()
| Rang | Erreur relative | Taille stockée |
|---|---|---|
| 5 | 18,4 % | 2 % |
| 20 | 13,6 % | 8 % |
| 50 | 10,3 % | 20 % |
| 100 | 7,4 % | 39 % |
Pour un rang , on stocke colonnes de , lignes de et valeurs singulières, soit nombres au lieu de . Au rang 50, on garde 20 % des nombres pour une image tout à fait reconnaissable.
Exercice pratique
- À la main. Calcule les valeurs propres de
en résolvant
. Vérifie avec
np.linalg.eig. Les vecteurs propres sont-ils orthogonaux ? Pourquoi ? - Puissances d’une matrice. Avec la matrice symétrique de l’exemple, calcule pour plusieurs vecteurs aléatoires et normalise le résultat. Vers quelle direction convergent-ils tous ? C’est la méthode de la puissance itérée. Explique pourquoi elle fonctionne à partir de la diagonalisation.
- L’échelle compte. Dans la PCA 2D, multiplie la deuxième colonne de
Xpar 100 avant la PCA. Que devient la première composante ? Refais-la aprèsStandardScaler. Laquelle des deux analyses a du sens ? - PCA sur des features. Reprends le dataset de la partie 14 (ou recalcule les 9 features sur les profils de cet article). Applique
StandardScalerpuis une PCA. Combien de composantes faut-il pour 90 % de la variance ? Les périodiques se séparent-ils mieux des rafales que sur les profils bruts ? - Moindres carrés par SVD. Avec
, montre que la solution des moindres carrés est
. Implémente-la et compare-la à
np.linalg.lstsqsur l’exemple de M2.
Indice pour la question 2 : écris dans la base des vecteurs propres, . Que vaut ?
Ressources pour aller plus loin
- 3Blue1Brown, Essence of Linear Algebra, épisode 14 (Eigenvectors and eigenvalues).
- Gilbert Strang, MIT 18.06, cours 21, 25 et 29 (valeurs propres, matrices symétriques, SVD).
- Deisenroth et al., Mathematics for Machine Learning, chapitre 4 (décompositions matricielles) et chapitre 10 (PCA).
- Jonathon Shlens, A Tutorial on Principal Component Analysis (2014), gratuit sur arXiv : la PCA dérivée pas à pas.
Ce que tu dois savoir faire avant de passer à la suite
- Expliquer ce qu’est un vecteur propre avec un dessin, sans formule
- Calculer les valeurs propres d’une matrice à la main
- Énoncer le théorème spectral et dire pourquoi la covariance s’y prête
- Interpréter la SVD comme rotation, étirement, rotation, et utiliser l’approximation de rang
- Recoder une PCA avec
np.linalg.svdet interpréter la variance expliquée - Citer trois limites de la PCA (linéarité, échelle, variance n’est pas pertinence)
Partie suivante : M4 · Dérivées, dérivées partielles et gradient. On ouvre la semaine de calcul différentiel : comment une fonction de perte change quand on bouge les paramètres.