M1 · Vecteurs, produit scalaire et normes
La géométrie derrière la similarité, les distances et la régularisation : le vecteur comme objet central du ML.
Mastering AI · Required Maths · Semaine 1 (algèbre linéaire) · Partie 1
Objectif de l’étape
En ML, tout est vecteur : un exemple, une ligne de features, les poids d’un modèle, un embedding, un gradient. Trois opérations reviennent sans cesse : additionner, mesurer une longueur (la norme) et comparer deux directions (le produit scalaire).
À la fin de cet article, tu sauras :
- lire un vecteur à la fois comme un point et comme une flèche ;
- interpréter un produit scalaire comme une projection et une mesure d’alignement ;
- choisir entre les normes , et , et entre distance euclidienne et similarité cosinus ;
- reconnaître ces objets dans la régression linéaire, le kNN, la régularisation et l’attention.
C’est un rappel : on va vite sur les définitions et on insiste sur l’intuition géométrique, qui sert ensuite partout.
Notions clés
1. Un vecteur : un point et une flèche
Intuition. Une liste de nombres, vue de deux façons : un point dans un espace à dimensions, ou une flèche depuis l’origine (une direction et une longueur).
- Une ligne de ton dataset est un point de , avec le nombre de features. Les 9 features de la partie 14 font de chaque (région, instant) un point de .
- Les poids d’un modèle linéaire sont une flèche dans ce même espace.
Deux opérations de base, qui se font composante par composante :
- addition : , on met les flèches bout à bout ;
- multiplication par un scalaire : , on étire ou on retourne la flèche.
Ces deux opérations sont exactement ce que fait une mise à jour de descente de gradient, (M10).
2. Le produit scalaire : mesurer l’alignement
Intuition. Le produit scalaire répond à la question « à quel point va-t-il dans la même direction que ? ». Grand et positif si elles sont alignées, nul si elles sont perpendiculaires, négatif si elles s’opposent.
Définition algébrique, celle qu’on calcule :
Définition géométrique, celle qu’on comprend :
où est l’angle entre les deux flèches. Les deux définitions sont égales, et c’est ce qui rend le produit scalaire si utile : un calcul bête (multiplier et sommer) donne une information géométrique (un angle).
| Signe de | Interprétation | |
|---|---|---|
| maximal | même direction | |
| nul | orthogonaux : aucune information commune | |
| minimal | directions opposées |
Projection. La part de qui va dans la direction de :
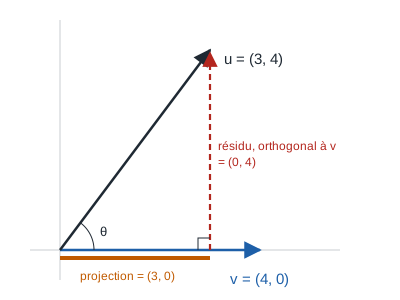
Ce qui reste, , est orthogonal à . Sur la figure, avec et , la projection vaut et le résidu est bien vertical. On reverra cette décomposition « partie expliquée + résidu orthogonal » dans les moindres carrés (M2) et dans la PCA (M3).
Où on le retrouve en ML :
- Modèle linéaire : est un produit scalaire. Le modèle mesure à quel point l’exemple est aligné avec la direction (partie 16).
- Neurone : chaque neurone calcule avant son activation (partie 21).
- Attention : le score entre une requête et une clé est (partie 23).
3. Les normes : mesurer une longueur
Intuition. Une norme mesure la « taille » d’un vecteur. Il existe plusieurs façons raisonnables de le faire, selon ce qu’on veut pénaliser.
- (euclidienne) : la longueur « à vol d’oiseau ». Elle pénalise fortement les grandes composantes, à cause du carré.
- (Manhattan) : la distance en ne se déplaçant que le long des axes, comme dans un quadrillage de rues. Toutes les composantes comptent proportionnellement.
- : seule la plus grande composante compte.
Exemple : pour , on a , et .
Les boules unité. L’ensemble des points de norme 1 a une forme différente selon la norme : un losange pour , un cercle pour , un carré pour .
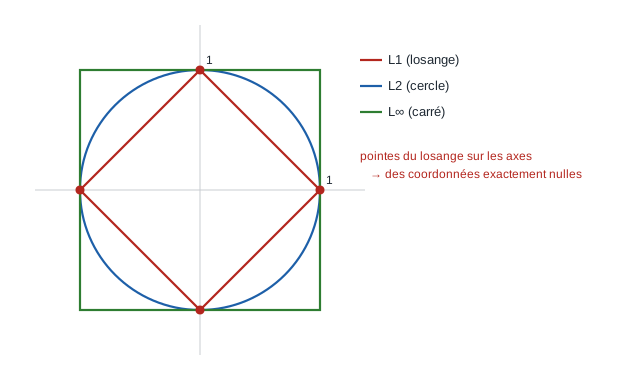
Ce n’est pas un détail esthétique : les pointes du losange sont sur les axes, c’est-à-dire là où certaines coordonnées valent exactement zéro. C’est pour ça que la régularisation (Lasso) met des poids à zéro et sélectionne des features, alors que (Ridge) les réduit sans les annuler. La démonstration complète arrive en M11, et on l’utilisera en partie 16.
4. Distance euclidienne ou similarité cosinus ?
Intuition. Deux questions différentes : « ces deux points sont-ils proches ? » et « ces deux flèches pointent-elles dans la même direction ? ».
- La distance est sensible à l’échelle : un vecteur et son double sont loin l’un de l’autre.
- Le cosinus ignore l’échelle : un vecteur et son double ont un cosinus de 1.
Pour des profils d’accès mémoire, la différence est fondamentale : deux régions qui ont le même rythme mais pas la même intensité sont très différentes au sens euclidien, et identiques au sens du cosinus. Le code ci-dessous le montre en chiffres.
Attention à l’échelle des features. Avec la distance euclidienne, une feature en millisecondes (valeurs autour de 500) écrase une feature entre 0 et 1. C’est pour ça qu’on standardise les features avant un kNN, une régression régularisée ou un réseau de neurones (partie 14).
Exemple de code
Quatre blocs indépendants : les opérations de base, la comparaison euclidienne/cosinus sur des profils d’accès, les boules unité, et un kNN écrit à la main.
Opérations de base
import numpy as np

u = np.array([3.0, 4.0])
v = np.array([4.0, 0.0])

print("u + v      =", u + v)
print("2u         =", 2 * u)
print("<u, v>     =", u @ v)                          # produit scalaire
print("||u||_2    =", np.linalg.norm(u))              # 5.0
print("||u||_1    =", np.linalg.norm(u, ord=1))       # 7.0
print("||u||_inf  =", np.linalg.norm(u, ord=np.inf))  # 4.0

cos_theta = (u @ v) / (np.linalg.norm(u) * np.linalg.norm(v))
print("angle(u,v) =", np.degrees(np.arccos(cos_theta)).round(2), "degrés")

# projection de u sur la direction de v
proj = (u @ v) / (v @ v) * v
print("proj_v(u)  =", proj, "| résidu :", u - proj, "| <résidu, v> =", (u - proj) @ v)
L’angle vaut 53,13°, la projection de sur vaut , et le résidu est bien orthogonal à : leur produit scalaire est nul.
Euclidienne contre cosinus, sur des profils d’accès
On décrit chaque région par ses accès sur les 20 dernières agrégations : un vecteur de .
import numpy as np

t = np.arange(20)
motif = ((t % 5) < 2).astype(float)          # actif 2 agrégations sur 5

profils = {
    "A : périodique, faible":  2 * motif,
    "B : périodique, intense": 8 * motif,             # même rythme, 4x plus d'accès
    "C : chaude, régulière":   np.full(20, 3.0),
    "D : périodique, décalée": 2 * np.roll(motif, 2), # même intensité que A, hors phase
}
noms = list(profils)
X = np.array([profils[n] for n in noms])


def dist_euclid(a, b):
    return np.linalg.norm(a - b)


def sim_cosinus(a, b):
    return (a @ b) / (np.linalg.norm(a) * np.linalg.norm(b))


print("Distance euclidienne / similarité cosinus avec A :")
for n, x in zip(noms[1:], X[1:]):
    print(f"  {n:<26} euclid = {dist_euclid(X[0], x):6.2f} | cosinus = {sim_cosinus(X[0], x):.3f}")
| Comparé à A | Distance euclidienne | Cosinus |
|---|---|---|
| B : même rythme, 4× plus intense | 16,97 (la plus loin) | 1,000 (identique) |
| C : chaude, régulière | 10,77 | 0,632 |
| D : même rythme, décalé de 2 pas | 8,00 (la plus proche) | 0,000 (orthogonal) |
Deux constats importants :
- selon la distance euclidienne, la région décalée D est plus proche de A que la région B, qui a pourtant exactement le même rythme. L’intensité domine tout ;
- le cosinus reconnaît que A et B ont le même motif, mais il trouve D orthogonale à A : les deux régions ne sont jamais actives aux mêmes instants. Aucune de ces deux mesures ne capture le fait que D a le même rythme que A, à un décalage près.
C’est exactement pour ça qu’en partie 14 on ne compare pas les profils bruts : on construit des features invariantes au décalage, comme periode_estimee et phase. L’outil qui mesure la ressemblance d’un signal avec lui-même décalé s’appelle l’autocorrélation (M7).
Les boules unité
Ce script reproduit la figure de la section 3.
import numpy as np
import matplotlib.pyplot as plt

theta = np.linspace(0, 2 * np.pi, 400)
directions = np.stack([np.cos(theta), np.sin(theta)], axis=1)

fig, ax = plt.subplots(figsize=(5, 5))
for p, nom in [(1, "$L_1$"), (2, "$L_2$"), (np.inf, "$L_\\infty$")]:
    normes = np.linalg.norm(directions, ord=p, axis=1)
    pts = directions / normes[:, None]        # on ramène chaque direction à norme 1
    ax.plot(pts[:, 0], pts[:, 1], label=nom)
ax.set_aspect("equal")
ax.axhline(0, c="gray", lw=0.5)
ax.axvline(0, c="gray", lw=0.5)
ax.legend()
ax.set_title("Boules unité : $\\{x : \\|x\\|_p = 1\\}$")
plt.show()
L’astuce : on prend des directions dans toutes les orientations, puis on divise chacune par sa norme . On obtient le losange, le cercle et le carré.
k plus proches voisins, à la main
Le kNN est l’algorithme le plus directement géométrique : pour classer un point, on regarde la classe majoritaire de ses voisins les plus proches. Tout dépend donc de la distance choisie.
On classe des profils périodiques (classe 1) contre des profils aléatoires (classe 0), avec des intensités très variées, de 0,5 à 10.
import numpy as np

rng = np.random.default_rng(0)


def knn_predire(X_train, y_train, x, k=5, distance="l2"):
    if distance == "l2":
        d = np.linalg.norm(X_train - x, axis=1)
    elif distance == "l1":
        d = np.abs(X_train - x).sum(axis=1)
    elif distance == "cosinus":
        d = 1 - (X_train @ x) / (np.linalg.norm(X_train, axis=1) * np.linalg.norm(x) + 1e-12)
    else:
        raise ValueError(distance)
    voisins = np.argsort(d)[:k]
    return np.bincount(y_train[voisins]).argmax()


def generer(n, rng):
    """Profils périodiques (1) ou aléatoires (0), d'intensités variées."""
    Xs, ys = [], []
    for _ in range(n):
        intensite = rng.uniform(0.5, 10)
        if rng.random() < 0.5:
            periode = rng.integers(3, 7)
            x = ((np.arange(20) + rng.integers(0, periode)) % periode == 0) * intensite
            ys.append(1)
        else:
            x = (rng.random(20) < 0.25) * intensite
            ys.append(0)
        Xs.append(x + rng.normal(0, 0.1, 20))
    return np.array(Xs), np.array(ys)


X_tr, y_tr = generer(400, rng)
X_te, y_te = generer(200, rng)
for dist in ("l2", "l1", "cosinus"):
    preds = np.array([knn_predire(X_tr, y_tr, x, k=5, distance=dist) for x in X_te])
    print(f"kNN distance {dist:<8} accuracy = {np.mean(preds == y_te):.3f}")
| Distance | Accuracy |
|---|---|
| 0,745 | |
| 0,745 | |
| cosinus | 0,860 |
Le cosinus gagne nettement, parce que la classe dépend de la forme du profil et pas de son intensité. Avec ou , un profil périodique intense ressemble davantage à un profil aléatoire intense qu’à un profil périodique faible. Le bon choix de distance est un choix de modélisation : il encode ce qu’on considère comme « semblable ».
Exercice pratique
- À la main. Pour et , calcule , , , et l’angle entre et . Vérifie avec NumPy.
- Inégalité de Cauchy-Schwarz. Tire 10 000 paires de vecteurs aléatoires de et vérifie numériquement que . À partir de la définition géométrique, explique pourquoi c’est toujours vrai et quand il y a égalité.
- Normaliser pour réconcilier. Dans le kNN, divise chaque vecteur par sa norme
(pour
X_tretX_te) avant d’utiliser la distance . Que devient l’accuracy ? Montre que pour des vecteurs de norme 1, . - Invariance au décalage. Écris une fonction qui calcule le cosinus maximal entre
et toutes les versions décalées de
(
np.roll(b, s)pour ). Vérifie qu’elle reconnaît enfin A et D comme semblables. Puis intègre-la au kNN : l’accuracy s’améliore-t-elle ? - Fil rouge. Dans les traces de la partie 14, quelle feature serait dominée par les autres en distance euclidienne si on ne standardisait pas ? Regarde les ordres de grandeur de
depuis_dernier(jusqu’à 500) et defrac_active_20(entre 0 et 1).
Indice pour la question 3 : développe par bilinéarité du produit scalaire.
Ressources pour aller plus loin
- 3Blue1Brown, Essence of Linear Algebra, épisodes 1, 2 et 9 (Dot products and duality) : l’intuition visuelle, en vidéo.
- Deisenroth, Faisal, Ong, Mathematics for Machine Learning, chapitre 3 (géométrie analytique), gratuit en ligne.
- Gilbert Strang, Introduction to Linear Algebra, chapitre 1.
- Rappel sur le blog : NumPy : penser en tableaux, pour la vectorisation des calculs.
Ce que tu dois savoir faire avant de passer à la suite
- Calculer à la main normes , , et produit scalaire
- Interpréter un produit scalaire comme une mesure d’alignement et une projection
- Dessiner de mémoire les boules unité , , , et dire où sont les pointes du losange
- Choisir entre distance euclidienne et cosinus selon que l’intensité compte ou non
- Expliquer pourquoi on standardise les features avant un algorithme basé sur des distances
- Reconnaître un produit scalaire dans
Partie suivante : M2 · Les matrices comme transformations. Une matrice applique une transformation à des vecteurs, et une couche de réseau de neurones n’est rien d’autre que ça.