M2 · Les matrices comme transformations
Produit matriciel, rang et inverse : pourquoi une couche de réseau de neurones n'est rien d'autre qu'une matrice.
Mastering AI · Required Maths · Semaine 1 (algèbre linéaire) · Partie 2
Objectif de l’étape
Dans M1, on a manipulé des vecteurs un par un. En ML, on les traite par paquets, et l’outil pour ça est la matrice. Mais une matrice n’est pas seulement un tableau de nombres : c’est une transformation de l’espace. Cette lecture rend évident ce que fait une couche de réseau, pourquoi les activations sont indispensables, et d’où vient la formule de la régression linéaire.
À la fin de cet article, tu sauras :
- lire une matrice comme une transformation, colonne par colonne ;
- interpréter le produit matriciel comme une composition ;
- relier rang, déterminant et inversibilité à une image géométrique ;
- dériver et résoudre les moindres carrés ;
- montrer pourquoi empiler des couches linéaires sans activation ne sert à rien.
Notions clés
1. Une matrice, deux lectures
Intuition. Une matrice de taille prend un vecteur de et en renvoie un de . Elle est linéaire : elle respecte les sommes et les multiplications par un scalaire, . Les droites restent des droites, l’origine reste en place, et un quadrillage régulier reste un quadrillage régulier, éventuellement tordu.
Le produit se lit de deux façons, et il faut maîtriser les deux.
Lecture par lignes : des produits scalaires. Chaque composante du résultat est le produit scalaire d’une ligne de avec (M1) :
C’est la lecture « neurones » : chaque ligne est un neurone qui mesure l’alignement de avec sa direction.
Lecture par colonnes : une combinaison. est une combinaison des colonnes de , pondérée par les coordonnées de :
Conséquence clé : les colonnes de sont les images des vecteurs de base. Pour savoir ce que fait une matrice , il suffit de regarder où elle envoie et . Tout le reste suit par linéarité.
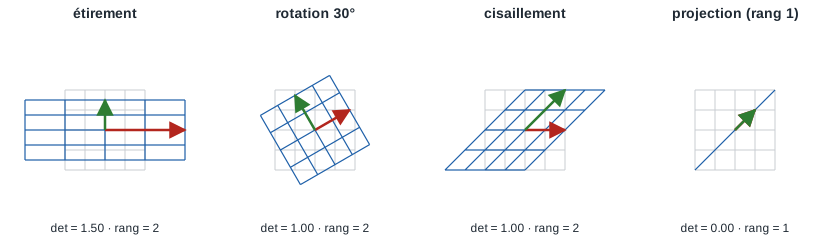
Dans chaque panneau, le quadrillage gris est l’espace de départ et le bleu son image. La flèche rouge est la première colonne de la matrice (l’image de ), la verte la seconde (l’image de ). Le dernier panneau montre une matrice qui écrase tout le plan sur une droite : on y reviendra avec le rang.
2. Produit matriciel = composition
Intuition. Appliquer , puis , c’est appliquer une seule transformation, notée . On lit de droite à gauche, comme .
Deux conséquences :
- les tailles doivent s’emboîter : ;
- l’ordre compte : en général . Tourner puis étirer ne donne pas le même résultat qu’étirer puis tourner.
3. Les données comme matrice
Ton jeu de données est une matrice de taille : une ligne par exemple, une colonne par feature. Pour un modèle linéaire de poids , toutes les prédictions s’obtiennent d’un coup :
C’est la lecture par lignes : chaque prédiction est le produit scalaire d’un exemple avec . C’est aussi pour ça que NumPy et les GPU sont rapides : une seule multiplication matricielle remplace une boucle sur les exemples.
4. Rang, déterminant, inverse
Intuition. Certaines transformations « écrasent » l’espace dans une dimension plus petite. Une fois écrasé, on ne peut plus revenir en arrière.
- Rang : la dimension de l’espace d’arrivée réellement atteint. Une matrice de rang 1 écrase le plan sur une droite.
- Noyau : les vecteurs envoyés sur . Si le noyau contient autre chose que , deux entrées différentes donnent la même sortie, et l’information est perdue.
- Déterminant (matrices carrées) : le facteur de changement d’aire (ou de volume). double les aires ; écrase tout sur une dimension inférieure ; un déterminant négatif retourne l’orientation.
- Inverse : défait , c’est-à-dire . Elle existe si et seulement si , c’est-à-dire si est de rang plein.
Côté ML : si deux features sont parfaitement corrélées (par exemple la même mesure en ms et en s), les colonnes de sont dépendantes, n’est pas inversible, et la régression linéaire n’a pas de solution unique. C’est la multicolinéarité, et c’est une des raisons d’être de la régularisation (M11, partie 16).
5. Les moindres carrés
Intuition. On cherche tel que soit le plus proche possible de . Or est forcément une combinaison des colonnes de (lecture par colonnes). On cherche donc le point de cet espace des colonnes le plus proche de : c’est la projection de sur cet espace (M1).
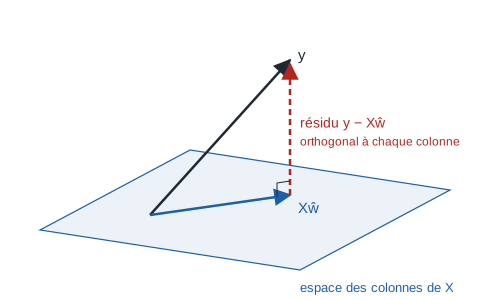
À l’optimum, le résidu est orthogonal à chaque colonne de :
Ce sont les équations normales. On les retrouvera par le calcul différentiel (en annulant le gradient de la MSE, M4), mais l’argument géométrique est plus parlant.
En pratique, on n’inverse jamais
explicitement : c’est lent et numériquement instable. On résout le système (np.linalg.solve), ou mieux, on passe par une décomposition comme la SVD (np.linalg.lstsq, M3).
6. Une couche de réseau = une matrice (+ une non-linéarité)
Une couche dense de entrées vers neurones calcule :
Sans la fonction d’activation , deux couches successives donnent :
c’est-à-dire une seule matrice. Empiler 10 couches linéaires, c’est toujours un modèle linéaire. C’est la non-linéarité (ReLU, sigmoïde…) qui donne au réseau sa capacité à représenter des fonctions complexes (partie 21).
Exemple de code
Voir une matrice transformer le plan
Ce script reproduit la figure de la section 1 : un quadrillage (en gris) et son image par quatre matrices (en bleu). Les flèches rouge et verte sont les images de et , c’est-à-dire les colonnes de la matrice.
import numpy as np
import matplotlib.pyplot as plt

matrices = {
    "étirement": np.array([[2.0, 0.0], [0.0, 0.75]]),
    "rotation 30°": np.array([[np.cos(np.pi / 6), -np.sin(np.pi / 6)],
                              [np.sin(np.pi / 6),  np.cos(np.pi / 6)]]),
    "cisaillement": np.array([[1.0, 1.0], [0.0, 1.0]]),
    "projection (rang 1)": np.array([[1.0, 1.0], [1.0, 1.0]]) / 2,
}

lignes = np.linspace(-1, 1, 9)
fig, axes = plt.subplots(1, 4, figsize=(16, 4))
for ax, (nom, A) in zip(axes, matrices.items()):
    for c in lignes:
        for seg in (np.stack([np.full(50, c), np.linspace(-1, 1, 50)]),
                    np.stack([np.linspace(-1, 1, 50), np.full(50, c)])):
            ax.plot(*seg, c="lightgray", lw=0.6)
            ax.plot(*(A @ seg), c="tab:blue", lw=0.8)
    e1, e2 = A[:, 0], A[:, 1]   # images des vecteurs de base = colonnes
    ax.arrow(0, 0, *e1, color="tab:red", width=0.02, length_includes_head=True)
    ax.arrow(0, 0, *e2, color="tab:green", width=0.02, length_includes_head=True)
    ax.set_title(f"{nom}\ndet = {np.linalg.det(A):.2f}, rang = {np.linalg.matrix_rank(A)}")
    ax.set_aspect("equal")
    ax.set_xlim(-2.5, 2.5)
    ax.set_ylim(-2, 2)
plt.tight_layout()
plt.show()
| Matrice | det | rang | Ce qui se passe |
|---|---|---|---|
| étirement | 1,50 | 2 | aires multipliées par 1,5 |
| rotation 30° | 1,00 | 2 | tout tourne, rien ne change de taille |
| cisaillement | 1,00 | 2 | le carré devient un parallélogramme de même aire |
| projection | 0,00 | 1 | tout le plan est écrasé sur la diagonale : impossible de revenir en arrière |
Le cisaillement est instructif : la forme change complètement, mais l’aire est conservée, et le déterminant le dit.
L’ordre compte
import numpy as np

R = np.array([[np.cos(np.pi / 6), -np.sin(np.pi / 6)],
              [np.sin(np.pi / 6),  np.cos(np.pi / 6)]])   # rotation 30°
S = np.array([[2.0, 0.0], [0.0, 0.75]])                    # étirement
x = np.array([1.0, 1.0])

print("R(Sx) =", R @ (S @ x), "| (RS)x =", (R @ S) @ x)   # identiques : composition
print("RS == SR ?", np.allclose(R @ S, S @ R))            # False : l'ordre compte
Les moindres carrés, trois façons
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)
n, d = 200, 3
X = rng.normal(size=(n, d))
w_vrai = np.array([2.0, -1.0, 0.5])
y = X @ w_vrai + rng.normal(0, 0.3, n)

w_normales = np.linalg.solve(X.T @ X, X.T @ y)          # équations normales
w_lstsq, *_ = np.linalg.lstsq(X, y, rcond=None)         # solveur stable (SVD)
w_sklearn = LinearRegression(fit_intercept=False).fit(X, y).coef_

print("w normales :", w_normales.round(4))
print("w lstsq    :", w_lstsq.round(4))
print("w sklearn  :", w_sklearn.round(4))

residu = y - X @ w_lstsq
print("X^T (y - Xw) =", (X.T @ residu).round(10), "(résidu orthogonal aux colonnes)")
Les trois méthodes donnent , proche des vrais poids ; l’écart vient du bruit. La dernière ligne affiche un vecteur nul : le résidu est bien orthogonal à chaque colonne de , exactement comme le prédit l’argument géométrique.
Deux couches linéaires = une seule
On simule un mini-réseau : 9 features (celles de la partie 14), 16 neurones cachés, 1 sortie, sur 1 000 exemples.
import numpy as np

rng = np.random.default_rng(0)
W1 = rng.normal(size=(16, 9))     # 9 features -> 16 neurones
W2 = rng.normal(size=(1, 16))     # 16 neurones -> 1 sortie
X = rng.normal(size=(9, 1000))    # 1000 exemples, en colonnes

sans_activation = W2 @ (W1 @ X)
une_couche = (W2 @ W1) @ X
print("Deux couches linéaires == une couche W2W1 ?", np.allclose(sans_activation, une_couche))

relu = lambda z: np.maximum(z, 0)
avec_relu = W2 @ relu(W1 @ X)
print("Avec ReLU == une couche W2W1 ?", np.allclose(avec_relu, une_couche))
Sans activation, le réseau à deux couches est exactement égal à une matrice : on a payé 160 paramètres pour un modèle qui en vaut 9. Avec la ReLU entre les deux, l’égalité est cassée : le réseau n’est plus linéaire.
Exercice pratique
- Construire une matrice à partir de ce qu’elle fait. Écris la matrice qui envoie sur et sur . Quelle transformation est-ce ? Calcule son déterminant et vérifie en traçant le quadrillage.
- Écraser l’espace. Pour
, calcule le rang et le déterminant. Trouve un vecteur non nul
tel que
. Que se passe-t-il avec
np.linalg.inv(A)? - Multicolinéarité. Dans le code des moindres carrés, ajoute une 4e colonne égale à
2 * X[:, 0]. Que deviennent le rang de , le conditionnement de (np.linalg.cond), et les coefficients renvoyés parsolveet parlstsq? Lequel des deux solveurs survit ? - Coût de calcul. Mesure avec
time.perf_counterle temps deX @ wpour de taille , puis celui d’une boucle Python qui fait les produits scalaires un par un. Quel facteur ? Rapporte-le au budget d’inférence d’un démon qui score des milliers de régions mémoire toutes les 100 ms. - Fil rouge. Pour une régression logistique sur les 9 features de la partie 14, écris les dimensions de , et si on score 4 096 régions d’un coup. Combien de multiplications cela représente-t-il ?
Indice pour la question 2 : la deuxième colonne est le double de la première, donc les colonnes ne couvrent qu’une droite.
Ressources pour aller plus loin
- 3Blue1Brown, Essence of Linear Algebra, épisodes 3 à 7 (transformations linéaires, multiplication, déterminant, inverse et rang) : l’intuition géométrique de cet article, en animation.
- Gilbert Strang, MIT 18.06 Linear Algebra, cours 1 à 3 et 15 à 16 (projections et moindres carrés), en vidéo gratuite.
- Deisenroth et al., Mathematics for Machine Learning, chapitre 2 (algèbre linéaire) et section 9.2 (moindres carrés).
- Rappel sur le blog : La régression linéaire, en bas niveau.
Ce que tu dois savoir faire avant de passer à la suite
- Lire un produit par lignes (produits scalaires) et par colonnes (combinaison)
- Construire la matrice d’une transformation à partir des images de et
- Expliquer pourquoi en général
- Interpréter rang, noyau et déterminant géométriquement, et savoir quand une matrice est inversible
- Dériver les équations normales à partir de l’orthogonalité du résidu
- Expliquer pourquoi un réseau sans activation est un modèle linéaire
Partie suivante : M3 · Valeurs propres, SVD et PCA. On cherche les directions qu’une matrice ne fait qu’étirer, et on en déduit la PCA et une façon stable de résoudre les moindres carrés.