M4 · Dérivées, dérivées partielles et gradient
De la pente d'une courbe à la direction de plus forte montée d'une fonction à plusieurs variables, et au gradient d'une fonction de perte.
Mastering AI · Required Maths · Semaine 2 (calcul différentiel) · Partie 4
Objectif de l’étape
Entraîner un modèle, c’est chercher les paramètres qui rendent la perte minimale. Pour savoir dans quelle direction bouger les paramètres, on a besoin d’une seule chose : le gradient. Cette semaine de calcul différentiel commence par lui.
À la fin de cet article, tu sauras :
- interpréter une dérivée comme une pente locale et la calculer numériquement ;
- calculer des dérivées partielles et assembler un gradient ;
- expliquer pourquoi le gradient indique la direction de plus forte montée ;
- dériver à la main le gradient de la MSE et de la log-loss, et le vérifier numériquement.
Notions clés
1. La dérivée : une pente locale
Intuition. Zoome assez sur une courbe lisse, elle finit par ressembler à une droite. La pente de cette droite, c’est la dérivée. Elle dit : « si je bouge un tout petit peu, de combien bouge-t-elle ? ».
On l’obtient comme limite des pentes des sécantes :
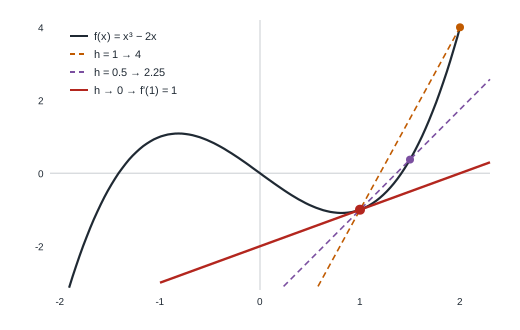
Sur la figure, la sécante entre et a une pente de 4, celle entre et une pente de 2,25. Quand tend vers 0, on obtient la tangente de pente .
Les règles qu’on utilise tout le temps :
| Fonction | Dérivée |
|---|---|
| (règle de la chaîne, voir M5) |
En pratique numérique, on approche la dérivée par des différences finies. La version centrée est bien plus précise que la version « avant » :
L’erreur de la version avant est proportionnelle à , celle de la version centrée à (on le démontrera avec Taylor en M6). Mais attention : si est trop petit, les erreurs d’arrondi des flottants dominent.
2. Dérivées partielles et gradient
Intuition. Une perte dépend de nombreux paramètres . La dérivée partielle mesure l’effet d’un petit changement de seul, tous les autres étant figés. Le gradient range toutes ces dérivées partielles dans un vecteur :
Exemple : pour , on a , donc .
3. Pourquoi le gradient pointe vers la plus forte montée
Intuition. Debout sur une colline, dans quelle direction monter le plus vite ? Le gradient répond.
Si on fait un petit pas dans une direction de norme 1, la fonction varie d’environ :
C’est un produit scalaire (M1) : il est maximal quand est aligné avec , et vaut alors . Il est nul quand est perpendiculaire au gradient : on reste à la même hauteur. Trois conséquences :
- indique la direction de plus forte montée, et la pente dans cette direction ;
- indique la direction de plus forte descente : c’est toute l’idée de la descente de gradient (M10) ;
- le gradient est perpendiculaire aux lignes de niveau (les courbes où est constante).
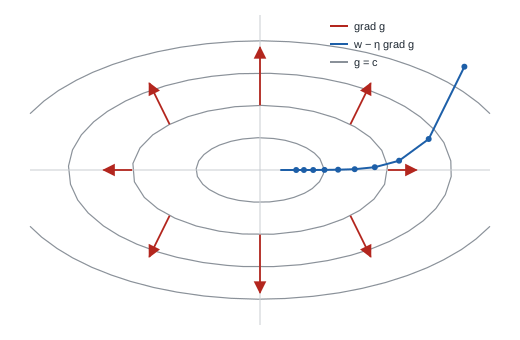
Sur la figure, les ellipses sont les lignes de niveau de . Les flèches rouges (le gradient) traversent chaque ellipse à angle droit. Le chemin bleu applique la règle : il descend vers le minimum, d’abord vite dans la direction verticale (où est plus pentue), puis plus lentement horizontalement.
4. Le gradient des pertes qu’on utilise
MSE de la régression linéaire. Avec :
Annuler ce gradient donne : ce sont exactement les équations normales obtenues géométriquement en M2.
Log-loss de la régression logistique. Avec et , on utilise une propriété remarquable de la sigmoïde :
En dérivant , presque tout se simplifie :
Le gradient est simplement la somme des exemples, pondérés par l’erreur de prédiction . Avec une régularisation , on ajoute . C’est cette formule qu’utilise la régression logistique de la partie 16.
Exemple de code
Différences finies : avant contre centrée
import numpy as np

def f(x):
    return x**3 - 2 * x

def f_prime(x):
    return 3 * x**2 - 2

x0 = 1.0
print("dérivée exacte :", f_prime(x0))
for h in (1e-1, 1e-3, 1e-5, 1e-8, 1e-12):
    avant = (f(x0 + h) - f(x0)) / h
    centree = (f(x0 + h) - f(x0 - h)) / (2 * h)
    print(f"h={h:.0e}  avant: erreur={abs(avant - f_prime(x0)):.2e}   centrée: erreur={abs(centree - f_prime(x0)):.2e}")
| Erreur, version avant | Erreur, version centrée | |
|---|---|---|
La version avant gagne un facteur 100 quand est divisé par 100 (erreur en ). La version centrée gagne un facteur 10 000 (erreur en ). En dessous de , les erreurs d’arrondi reprennent le dessus : à , les deux méthodes sont mauvaises.
Gradient numérique et direction de plus forte pente
import numpy as np

def g(w):
    return w[0] ** 2 / 4 + w[1] ** 2

def grad_g(w):
    return np.array([w[0] / 2, 2 * w[1]])

def grad_numerique(F, w, h=1e-5):
    gr = np.zeros_like(w)
    for i in range(len(w)):
        e = np.zeros_like(w)
        e[i] = h
        gr[i] = (F(w + e) - F(w - e)) / (2 * h)
    return gr

w = np.array([2.0, 1.0])
print("gradient exact     :", grad_g(w))
print("gradient numérique :", grad_numerique(g, w).round(6))

# on teste 360 directions de norme 1 : laquelle fait monter g le plus vite ?
angles = np.linspace(0, 2 * np.pi, 360, endpoint=False)
dirs = np.stack([np.cos(angles), np.sin(angles)], axis=1)
pentes = dirs @ grad_g(w)
best = dirs[np.argmax(pentes)]
print("direction de plus forte pente :", best.round(3),
      "| gradient normalisé :", (grad_g(w) / np.linalg.norm(grad_g(w))).round(3),
      "| pente max :", pentes.max().round(3), "= ||grad|| :", np.linalg.norm(grad_g(w)).round(3))
Le gradient numérique vaut exactement . Parmi 360 directions, la meilleure est , à moins d’un degré du gradient normalisé , et la pente maximale vaut .
Gradient de la log-loss : analytique contre numérique
On vérifie la formule sur des données simulées, puis on suit pour voir la perte baisser.
import numpy as np

rng = np.random.default_rng(0)
n, d = 500, 3
X = rng.normal(size=(n, d))
w_vrai = np.array([1.5, -2.0, 0.5])

def sigmoide(z):
    return 1 / (1 + np.exp(-z))

y = (rng.random(n) < sigmoide(X @ w_vrai)).astype(float)

def log_loss(w, lam=0.0):
    p = sigmoide(X @ w)
    eps = 1e-12
    return -np.mean(y * np.log(p + eps) + (1 - y) * np.log(1 - p + eps)) + lam / 2 * w @ w

def grad_log_loss(w, lam=0.0):
    return X.T @ (sigmoide(X @ w) - y) / n + lam * w

def grad_numerique(F, w, h=1e-5):
    gr = np.zeros_like(w)
    for i in range(len(w)):
        e = np.zeros_like(w)
        e[i] = h
        gr[i] = (F(w + e) - F(w - e)) / (2 * h)
    return gr

w_test = rng.normal(size=d)
for lam in (0.0, 0.1):
    ga = grad_log_loss(w_test, lam)
    gn = grad_numerique(lambda v: log_loss(v, lam), w_test)
    print(f"lambda={lam}: écart max analytique/numérique = {np.abs(ga - gn).max():.1e}")

# suivre -gradient : la perte baisse
w_k = np.zeros(d)
for k in range(201):
    if k in (0, 1, 5, 20, 50, 200):
        print(f"itération {k:>3} : log-loss = {log_loss(w_k):.4f}, w = {w_k.round(3)}")
    w_k = w_k - 1.0 * grad_log_loss(w_k)
L’écart entre gradient analytique et numérique est de l’ordre de : la formule est juste. La descente fait passer la log-loss de (c’est , la perte d’un modèle qui répond toujours 50 %) à en 200 itérations, avec . Les signes et les proportions de sont retrouvés. L’écart restant vient du bruit d’échantillonnage sur 500 exemples.
Cette vérification par différences finies (le gradient check) est un réflexe à garder : dès que tu écris un gradient à la main, compare-le à sa version numérique.
Exercice pratique
- À la main. Calcule pour et (la fonction softplus). Vérifie avec la différence centrée. Que remarques-tu sur la dérivée de softplus ?
- Le gradient de la MSE. Écris
grad_mse(w)pour une régression linéaire, vérifie-le avecgrad_numerique, puis résous avecnp.linalg.solveet compare à la solution de M2. - Lignes de niveau. Pour
, calcule
. Trace quelques lignes de niveau avec
plt.contouret superpose les flèches du gradient avecplt.quiver. Vérifie visuellement l’orthogonalité. - Le piège du pas. Dans la descente de gradient sur la log-loss, essaie un pas de 10 puis de 50 au lieu de 1. Que se passe-t-il ? (On l’expliquera en M6 et M10 avec la courbure.)
- Fil rouge. Pour un modèle logistique sur les 9 features de la partie 14, quelle est la dimension du gradient ? Combien d’opérations coûte son calcul pour exemples ? Compare avec le coût d’une prédiction.
Indice pour la question 1 : la dérivée de softplus est une fonction que tu connais déjà très bien.
Ressources pour aller plus loin
- 3Blue1Brown, Essence of Calculus, épisodes 1 à 4 : la dérivée comme pente, en animation.
- Khan Academy, Multivariable calculus, chapitre Gradient and directional derivatives.
- Deisenroth et al., Mathematics for Machine Learning, chapitre 5 (calcul vectoriel), sections 5.1 à 5.3.
- CS231n (Stanford), notes sur le gradient checking.
Ce que tu dois savoir faire avant de passer à la suite
- Expliquer une dérivée comme une pente locale, avec un dessin
- Calculer une dérivée numériquement et choisir un raisonnable
- Calculer un gradient à la main pour une fonction de plusieurs variables
- Expliquer pourquoi on suit pour faire baisser , avec le produit scalaire
- Retrouver comme gradient de la log-loss
- Faire un gradient check systématique
Partie suivante : M5 · Règle de la chaîne et rétropropagation. Dériver une composition de fonctions, c’est exactement ce que fait un réseau de neurones à l’entraînement.