Modèles de séquences : RNN, LSTM et attention
Fenêtres sans fuite, RNN, LSTM, convolutions dilatées et attention face au MLP sur features, à budget égal : qui gagne avant et après un changement de régime, et pour quelle latence.
Mastering AI · Phase technique · Semaine 3 · Partie 23
Objectif de l’étape
Depuis la partie 14, chaque modèle voit le passé d’une région à travers 9 features choisies à la main : moyennes glissantes, temps depuis le dernier accès, période estimée. C’est un résumé. Un modèle de séquences reçoit au contraire la suite brute des accès et construit lui-même sa mémoire. C’est l’hypothèse H2 du mémoire : un LSTM sur l’historique brut fait-il mieux que LightGBM ou un MLP sur des features ?
On va répondre avec la recette de la partie 22 appliquée à tous les modèles, avec le même budget, puis regarder ce que chaque gain coûte en latence.
À la fin de cet article, tu sauras :
- transformer une trace en fenêtres prêtes pour PyTorch, sans fuite ;
- expliquer pourquoi un RNN oublie vite, avec la règle de la chaîne de M5, et ce que changent les portes d’un LSTM ;
- utiliser une convolution 1D dilatée comme alternative rapide à la récurrence ;
- écrire une tête d’attention et relier son score au produit scalaire de M1 ;
- décider, chiffres à l’appui, quand un modèle de séquences vaut son coût.
Notions clés
1. Mettre une série en forme : des fenêtres
Intuition. Pour prédire si une région sera accédée dans la prochaine seconde, on lui montre la vidéo de ses dernières agrégations, au lieu de la fiche résumé des 9 features.
Pour chaque ligne (région , instant ) du dataset, l’entrée devient une matrice : à chaque instant de à , le nombre d’accès de la région et la moyenne de ses deux voisines (la localité de la partie 14). Le label ne change pas : si la région est accédée entre et , avec .
Les trois règles anti-fuite de la partie 14 s’appliquent telles quelles :
- la fenêtre s’arrête à : jamais un instant postérieur ;
- le
log1pet la standardisation utilisent des statistiques calculées sur la seule période d’entraînement ; - le découpage reste celui de la partie 15 : entraînement , validation , test . Les trous de 10 agrégations sont la purge.
Côté PyTorch, un batch de séquences est un tenseur de forme (batch, L, canaux). Le choix de
est un vrai choix de modélisation : une fenêtre plus courte que la période d’une région ne peut pas voir son cycle.
2. Le RNN : une mémoire qui s’efface
Intuition. Un RNN lit la fenêtre de gauche à droite, comme toi un texte, en mettant à jour un résumé (l’état caché) à chaque instant. Les mêmes poids servent à chaque pas.
Pour savoir comment l’entrée d’il y a pas influence la sortie, on applique la règle de la chaîne de M5 le long de la récurrence :
C’est un produit de
matrices. Si leur « taille » est inférieure à 1, il décroît géométriquement avec
: c’est le gradient qui disparaît, la même chaîne de multiplications que les 16 couches de la partie 22, sauf que la profondeur est maintenant la longueur de la fenêtre. Le RNN ne peut pas apprendre une dépendance à 40 pas si le signal d’erreur qui remonte 40 pas vaut
. Si la taille dépasse 1, il explose : c’est pour ça qu’on garde clip_grad_norm_ dans la boucle.
3. LSTM et GRU : des portes pour décider quoi garder
Intuition. Le LSTM ajoute une seconde mémoire, la cellule , qu’on ne multiplie pas par une matrice à chaque pas : on y ajoute de l’information, et on décide par des portes ce qu’on oublie.
Le long de la cellule, la dérivée est simplement (en négligeant les chemins qui passent par ). Après pas, il reste le produit des portes d’oubli : si , l’information et le gradient traversent la fenêtre presque intacts. Le réseau apprend quand oublier.
Détail qui compte, et qu’on va mesurer : à l’initialisation, PyTorch met tous les biais à des petites valeurs centrées sur 0, donc , et . Un LSTM tout neuf oublie aussi vite qu’un RNN. D’où l’astuce classique (Jozefowicz et al., 2015) : initialiser le biais de la porte d’oubli à 1 ou plus.
Le GRU (Cho et al., 2014) fusionne cellule et état caché et n’a que deux portes : 25 % de paramètres en moins, des résultats souvent proches.
4. La convolution 1D : regarder toute la fenêtre d’un coup
Intuition. Au lieu de lire la fenêtre pas à pas, on fait glisser de petits filtres le long du temps, comme une moyenne glissante dont les poids seraient appris. Tous les instants sont traités en parallèle.
Un filtre de taille 3 ne voit que 3 instants. Pour voir loin sans empiler 30 couches, on dilate : la couche regarde des instants espacés de . Avec un noyau et des dilatations , le champ réceptif vaut
Avec et : . Cinq couches suffisent pour voir 63 instants. Pas de récurrence, donc pas de produit de jacobiennes : le gradient d’un instant lointain traverse 5 couches, pas 63.
5. L’attention : la requête choisit qui écouter
Intuition. Pour décider maintenant, l’instant présent pose une question (la requête). Chaque instant passé présente une étiquette (sa clé) et un contenu (sa valeur). On écoute surtout les instants dont l’étiquette ressemble à la question.
Chaque instant est d’abord projeté en un vecteur de dimension (ici 32), auquel on ajoute un vecteur de position appris. Puis :
Le score est le produit scalaire de M1 : il est grand quand les deux vecteurs pointent dans la même direction. La division par garde les scores à une échelle raisonnable (la variance d’une somme de produits indépendants, M7), sinon le softmax saturerait. Les poids sont positifs et somment à 1 : on peut les lire, c’est l’un des rares modèles qui dit où il regarde.
Sans les vecteurs de position, l’attention ne connaîtrait pas l’ordre : permuter la fenêtre ne changerait rien. C’est le cœur des Transformers ; ici, une seule tête et une seule couche suffisent pour voir l’idée.
6. Quand un modèle de séquences vaut-il son coût ?
Intuition. Un modèle de séquences n’apprend que ce que la fenêtre contient. Si de bonnes features résument déjà ce passé, il doit faire mieux qu’elles, et pas seulement aussi bien, pour justifier un coût bien plus élevé.
| Critère | Features + MLP / boosting | Modèle de séquences |
|---|---|---|
| Ce qu’il voit | ce que tu as pensé à calculer, sur des horizons longs (moy_100, depuis_dernier jusqu’à 500) |
tout ce que contient la fenêtre, rien au-delà de |
| Coût d’inférence | quelques dizaines de µs | fois plus de calcul au minimum (récurrence : pas séquentiels) |
| Données nécessaires | modérées | plus de paramètres, plus sensible au réglage |
| Quand il gagne | motifs simples à résumer | motifs que personne n’a su résumer : ordre précis, interactions temporelles |
La question honnête n’est donc pas « le LSTM est-il bon ? » mais « que gagne-t-on par rapport au MLP de la partie 22, à réglage égal, et combien de microsecondes ça coûte ? ».
Exemple de code
Comme en parties 15 à 22, on reprend tel quel le script de la partie 14 (simulation et dataset), puis le premier bloc de la partie 22 (découpage, entrées des 9 features, mlp, evaluer, ajuster, test d’amplitude), et on ajoute les quatre blocs ci-dessous à la suite. L’ensemble tourne en environ une demi-heure sur un CPU à deux cœurs (numpy 2.5, pandas 3.0, scikit-learn 1.9, torch 2.14).
Des features aux séquences
On construit une seule fois les deux canaux (accès de la région, moyenne des deux voisines), on applique log1p et la standardisation avec les statistiques des instants
, puis on découpe les fenêtres avec sliding_window_view, qui ne copie rien : chaque fenêtre est une vue sur la même mémoire.
# 1. Des features aux séquences : la fenêtre brute des L dernières agrégations
from numpy.lib.stride_tricks import sliding_window_view

# Deux canaux par instant : les accès de la région, et la moyenne de ses deux voisines (r-1, r+1)
voisines = np.stack([acces[[v for v in (r - 1, r + 1) if 0 <= v < N_REGIONS]].mean(0)
                     for r in range(N_REGIONS)])
canaux = np.log1p(np.stack([acces, voisines], axis=-1)).astype(np.float32)   # (régions, temps, 2)
moy = canaux[:, :1390].reshape(-1, 2).mean(0)          # statistiques du seul entraînement (partie 14)
ecart = canaux[:, :1390].reshape(-1, 2).std(0)
canaux = (canaux - moy) / ecart


def sequences(d, L):
    """Pour chaque ligne (région, t) : les L instants t-L+1 .. t inclus, jamais au-delà de t."""
    fenetres = sliding_window_view(canaux, L, axis=1)      # (régions, T-L+1, 2, L), sans copie
    X = fenetres[d.region.to_numpy(), d.t.to_numpy() - L + 1].transpose(0, 2, 1)
    return torch.tensor(np.ascontiguousarray(X))           # (n, L, 2)


S = {L: (sequences(tr, L), sequences(va, L), sequences(te, L)) for L in (20, 64)}
print(tuple(S[64][0].shape), tuple(S[64][1].shape), tuple(S[64][2].shape))
# Contrôle anti-fuite : le dernier pas de la fenêtre est bien l'instant t de la ligne
r0, t0_ = int(tr.region.iloc[5000]), int(tr.t.iloc[5000])
print("dernier pas = accès en t :", np.isclose(np.expm1(S[64][0][5000, -1, 0].item() * ecart[0] + moy[0]),
                                                acces[r0, t0_], atol=1e-3))
Sortie : (123840, 64, 2) (37440, 64, 2) (114240, 64, 2), puis dernier pas = accès en t : True. Mêmes lignes que les 9 features de la partie 22, mêmes labels : seule la représentation de l’entrée change. Le contrôle vérifie la règle la plus importante : le dernier instant de la fenêtre est exactement l’instant
de la ligne, jamais
.
Quatre façons de lire une séquence, et la mémoire à l’initialisation
Les quatre modèles prennent un tenseur (batch, L, 2) et rendent un logit. Avant tout entraînement, on mesure la sensibilité de la sortie à l’entrée d’il y a
pas : la norme de
sur 512 fenêtres, divisée par celle de
. C’est la formule de la section 2, mesurée.
# 2. Quatre façons de lire une séquence
class Recurrent(nn.Module):
    """RNN, LSTM ou GRU : on lit la fenêtre dans l'ordre, et on prédit à partir du dernier état caché."""
    def __init__(self, cellule="lstm", d_in=2, cachee=32, biais_oubli=None):
        super().__init__()
        self.rnn = {"rnn": nn.RNN, "lstm": nn.LSTM, "gru": nn.GRU}[cellule](d_in, cachee, batch_first=True)
        self.tete = nn.Linear(cachee, 1)
        if biais_oubli is not None:              # LSTM : les biais sont rangés par portes [i, f, g, o]
            with torch.no_grad():
                self.rnn.bias_ih_l0[cachee:2 * cachee].fill_(biais_oubli)
                self.rnn.bias_hh_l0[cachee:2 * cachee].zero_()

    def forward(self, x):                        # x : (batch, L, 2)
        etats, _ = self.rnn(x)                   # (batch, L, cachee) : un état caché par instant
        return self.tete(etats[:, -1])           # le dernier résume toute la fenêtre -> un logit


class Conv1D(nn.Module):
    """Convolutions dilatées 1, 2, 4, 8, 16 (noyau 3) : champ réceptif de 63 instants, sans récurrence."""
    def __init__(self, d_in=2, c=32, dilatations=(1, 2, 4, 8, 16)):
        super().__init__()
        couches, a = [], d_in
        for dil in dilatations:
            couches += [nn.Conv1d(a, c, kernel_size=3, dilation=dil), nn.ReLU()]
            a = c
        self.convs = nn.Sequential(*couches)
        self.tete = nn.Linear(c, 1)

    def forward(self, x):                        # Conv1d attend (batch, canaux, L)
        z = self.convs(x.transpose(1, 2))        # sans padding : il reste L - 62 positions
        return self.tete(z[:, :, -1])            # la dernière voit les 63 derniers instants


class Attention(nn.Module):
    """Une tête d'attention : l'instant présent (la requête) choisit quels instants passés (les clés) écouter."""
    def __init__(self, d_in=2, d=32, L=64):
        super().__init__()
        self.entree = nn.Linear(d_in, d)
        self.position = nn.Parameter(0.1 * torch.randn(L, d))     # sans elle, l'ordre serait perdu
        self.attn = nn.MultiheadAttention(d, num_heads=1, batch_first=True)
        self.tete = nn.Sequential(nn.Linear(2 * d, d), nn.ReLU(), nn.Linear(d, 1))

    def forward(self, x):
        z = self.entree(x) + self.position                      # (batch, L, d)
        q = z[:, -1:]                                           # requête : l'instant t
        contexte, self.poids = self.attn(q, z, z)               # poids : (batch, 1, L), somme 1
        return self.tete(torch.cat([contexte[:, 0], q[:, 0]], dim=-1))


def n_params(m):
    return sum(p.numel() for p in m.parameters())


# Mémoire à l'initialisation : de combien la sortie dépend-elle de l'entrée d'il y a k pas ?
xb = S[64][0][:512].clone().requires_grad_()
for nom, fabrique in [("RNN", lambda: Recurrent("rnn")), ("LSTM", lambda: Recurrent("lstm")),
                      ("LSTM, biais d'oubli 1", lambda: Recurrent("lstm", biais_oubli=1.0)),
                      ("LSTM, biais d'oubli 3", lambda: Recurrent("lstm", biais_oubli=3.0))]:
    torch.manual_seed(0)
    m = fabrique()
    xb.grad = None
    m(xb).sum().backward()
    g = xb.grad.norm(dim=(0, 2))                                # une norme par position
    print(f"{nom:>21} | {n_params(m)} paramètres | |d sortie / d x_(t-k)| relatif à k = 0 : "
          + " ".join(f"k={k}: {(g[-1 - k] / g[-1]).item():.1e}" for k in (1, 5, 10, 20, 40, 63)))
| Modèle (initialisation) | ||||||
|---|---|---|---|---|---|---|
| RNN (1 185 paramètres) | 0,16 | 0,10 | ||||
| LSTM (4 641 paramètres) | 0,59 | |||||
| LSTM, biais d’oubli 1 | 0,86 | 0,24 | ||||
| LSTM, biais d’oubli 3 | 0,65 | 0,73 | 0,51 | 0,29 | 0,40 | 0,58 |
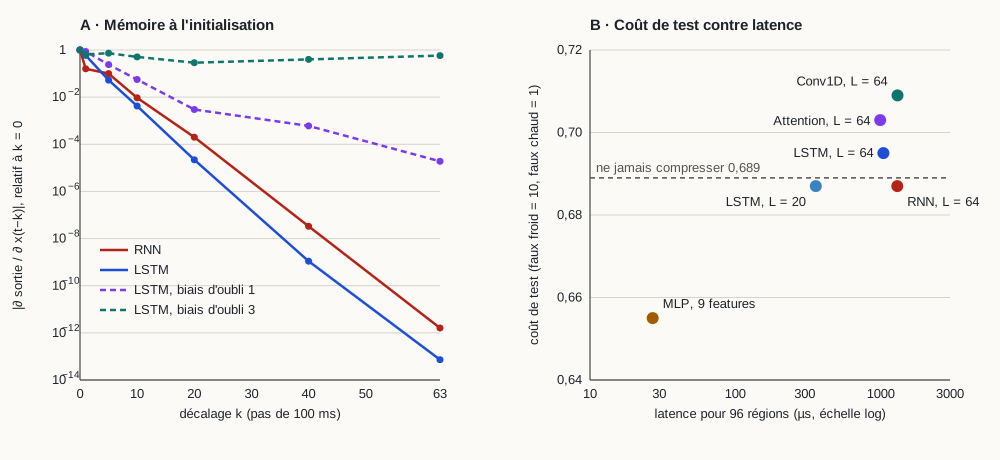
- La disparition est géométrique. Pour le RNN, on perd environ un facteur 10 tous les 5 à 10 pas : à 63 pas, il reste . Le panneau A de la figure trace ces courbes en échelle logarithmique : ce sont à peu près des droites, la signature d’un produit de facteurs semblables.
- Un LSTM neuf n’est pas mieux loti. Avec , sa cellule oublie aussi vite que le RNN, et même plus vite au-delà de 20 pas. Les portes ne servent qu’une fois apprises.
- Le biais d’oubli change tout. À 1, on gagne environ huit ordres de grandeur à 63 pas ; à 3 ( ), la sensibilité ne décroît presque plus : le réseau voit toute la fenêtre dès le départ.
La recette de la partie 22, à budget égal
Pour une comparaison honnête, chaque modèle reçoit exactement le même traitement : AdamW, one-cycle sur 20 époques, clip_grad_norm_ à 1, meilleure époque sur la validation, seuil choisi sur la validation avec le coût de la partie 15. On commence par le test d’amplitude, avec deux graines.
# 3. La recette de la partie 22 pour chaque modèle : test d'amplitude, one-cycle, clipping, meilleure époque
def predire(modele, X, lot=8192):
    """Probabilités par lots, en mode eval() et sans graphe (la mémoire reste raisonnable)."""
    modele.eval()
    with torch.no_grad():
        return np.concatenate([torch.sigmoid(modele(X[i:i + lot]).squeeze(-1)).numpy()
                               for i in range(0, len(X), lot)])


def test_amplitude(fabrique, X, y, lr_min=1e-5, lr_max=1e3, clip=1.0, graine=0):
    """Le test de la partie 22, pour n'importe quel modèle : une époque, pas multiplié à chaque batch."""
    torch.manual_seed(graine)
    modele = fabrique()
    opt = torch.optim.AdamW(modele.parameters(), lr=lr_min, weight_decay=1e-4)
    chargeur = DataLoader(TensorDataset(X, y), batch_size=512, shuffle=True)
    facteur = (lr_max / lr_min) ** (1 / (len(chargeur) - 1))
    perte_fn, lrs, pertes, lisse = nn.BCEWithLogitsLoss(), [], [], 0.0
    for i, (xb, yb) in enumerate(chargeur):
        for g in opt.param_groups:
            g["lr"] = lr_min * facteur ** i
        opt.zero_grad()
        perte = perte_fn(modele(xb).squeeze(-1), yb)
        perte.backward()
        nn.utils.clip_grad_norm_(modele.parameters(), clip)
        opt.step()
        lisse = 0.9 * lisse + 0.1 * perte.item()
        lrs.append(lr_min * facteur ** i)
        pertes.append(lisse / (1 - 0.9 ** (i + 1)))
        if not np.isfinite(pertes[-1]) or pertes[-1] > 4 * min(pertes):
            break
    return lrs[int(np.argmin(pertes))]


def entrainer(fabrique, Xtr, ytr, Xva, yva, lr_max, epoques=20, clip=1.0, graine=0):
    """ajuster (partie 22) avec one-cycle, plus clip_grad_norm_ entre backward() et step()."""
    torch.manual_seed(graine)
    modele = fabrique()
    opt = torch.optim.AdamW(modele.parameters(), lr=lr_max, weight_decay=1e-4)
    chargeur = DataLoader(TensorDataset(Xtr, ytr), batch_size=512, shuffle=True)
    planning = torch.optim.lr_scheduler.OneCycleLR(opt, max_lr=lr_max, epochs=epoques,
                                                   steps_per_epoch=len(chargeur))
    perte_fn = nn.BCEWithLogitsLoss()
    meilleure, etat, hist = np.inf, None, []
    for epoque in range(1, epoques + 1):
        modele.train()
        for xb, yb in chargeur:
            opt.zero_grad()
            perte_fn(modele(xb).squeeze(-1), yb).backward()
            if clip is not None:
                nn.utils.clip_grad_norm_(modele.parameters(), clip)   # la norme totale du gradient <= clip
            opt.step()
            planning.step()
        ll_va = log_loss(yva.numpy(), predire(modele, Xva), labels=[0, 1])
        hist.append(ll_va)
        if ll_va < meilleure:
            meilleure, etat = ll_va, {k: v.clone() for k, v in modele.state_dict().items()}
    modele.load_state_dict(etat)
    return modele, hist


def cout_moyen(y, p, seuil, c_fn=10, c_fp=1):
    return (c_fn * np.sum((y == 1) & (p < seuil)) + c_fp * np.sum((y == 0) & (p >= seuil))) / len(y)


def latence(modele, X, n=200):
    """Temps médian pour scorer 96 régions d'un coup (une agrégation de la trace), en µs."""
    modele.eval()
    with torch.no_grad():
        mesures = []
        for _ in range(n):
            t0 = time.perf_counter()
            modele(X[:96])
            mesures.append(time.perf_counter() - t0)
    return 1e6 * np.median(mesures)


candidats = {
    "MLP, 9 features":    (lambda: mlp([9, 32, 32, 1]), (Xtr, Xva, Xte)),
    "RNN, L = 64":        (lambda: Recurrent("rnn"), S[64]),
    "LSTM, L = 20":       (lambda: Recurrent("lstm"), S[20]),
    "LSTM, L = 64":       (lambda: Recurrent("lstm"), S[64]),
    "Conv1D, L = 64":     (lambda: Conv1D(), S[64]),
    "Attention, L = 64":  (lambda: Attention(), S[64]),
}
# (a) Le test d'amplitude, avec deux graines : il situe la zone utile, mais ne tranche pas à un facteur 3 près
for nom, (fabrique, (A_tr, _, _)) in candidats.items():
    print(f"{nom:>18} | minimum du test d'amplitude, graines 0 et 1 : "
          + " et ".join(f"{test_amplitude(fabrique, A_tr, ytr, graine=g):.2g}" for g in (0, 1)))

# (b) À budget égal : trois pas maximaux par modèle, choisis sur la log-loss de validation, puis le test une fois
seuils = np.linspace(0.01, 0.99, 99)
y_va, y_te = va.y.to_numpy(), te.y.to_numpy()
print(f"ne jamais compresser : coût test {cout_moyen(y_te, np.ones(len(te)), 0.5):.3f}")
modeles, probas = {}, {}
for nom, (fabrique, (A_tr, A_va, A_te)) in candidats.items():
    essais = {}
    for lr_max in (1e-3, 3e-3, 1e-2):
        t0 = time.perf_counter()
        essais[lr_max] = entrainer(fabrique, A_tr, ytr, A_va, yva, lr_max) + (time.perf_counter() - t0,)
    lr_max = min(essais, key=lambda k: min(essais[k][1]))
    modele, hist, duree = essais[lr_max]
    p_va, p_te = predire(modele, A_va), predire(modele, A_te)
    s = seuils[np.argmin([cout_moyen(y_va, p_va, s) for s in seuils])]
    modeles[nom], probas[nom] = modele, (p_va, p_te)
    print(f"{nom:>18} | {n_params(modele):>5} param. | val selon le pas : "
          + " / ".join(f"{min(e[1]):.4f}" for e in essais.values())
          + f" | pas retenu {lr_max:g} | {duree:3.0f} s | meilleure ép. {int(np.argmin(hist)) + 1:>2} | "
          f"log-loss val {min(hist):.4f} | AUC val {roc_auc_score(y_va, p_va):.3f} | "
          f"AUC test {roc_auc_score(y_te, p_te):.3f} | seuil {s:.2f} | coût test {cout_moyen(y_te, p_te, s):.3f} | "
          f"{latence(modele, A_te):.0f} µs / 96 régions")
Le test d’amplitude d’abord :
| Modèle | Minimum, graine 0 | Minimum, graine 1 |
|---|---|---|
| MLP, 9 features | 0,12 | 0,44 |
| RNN, | 0,024 | 0,077 |
| LSTM, | 0,44 | 0,41 |
| LSTM, | 0,066 | 0,096 |
| Conv1D, | 0,1 | 0,061 |
| Attention, | 0,021 | 0,028 |
Le même modèle donne un minimum jusqu’à 3,7 fois différent d’une graine à l’autre (MLP : 0,12 contre 0,44). Le test d’amplitude est un bon outil pour situer la zone utile (ici entre et quelques pour tous), pas pour trancher à un facteur 3 près. D’où la deuxième partie du bloc : trois pas maximaux, , et , pour chaque modèle, et on garde le meilleur sur la validation. Six modèles, dix-huit entraînements, le même budget pour tous.
| Modèle | Paramètres | Pas retenu | Entraînement | Log-loss val | AUC val | AUC test | Seuil (val) | Coût test | Latence, 96 régions |
|---|---|---|---|---|---|---|---|---|---|
| MLP, 9 features (partie 22) | 1 409 | 16 s | 0,2772 | 0,916 | 0,873 | 0,11 | 0,655 | 27 µs | |
| RNN, | 1 185 | 96 s | 0,3920 | 0,854 | 0,823 | 0,09 | 0,687 | 1 302 µs | |
| LSTM, | 4 641 | 49 s | 0,4003 | 0,835 | 0,793 | 0,05 | 0,687 | 358 µs | |
| LSTM, | 4 641 | 122 s | 0,2751 | 0,911 | 0,867 | 0,11 | 0,695 | 1 045 µs | |
| Conv1D, | 12 673 | 120 s | 0,2734 | 0,913 | 0,855 | 0,09 | 0,709 | 1 305 µs | |
| Attention, | 8 481 | 116 s | 0,3961 | 0,851 | 0,817 | 0,07 | 0,703 | 993 µs | |
| Ne jamais compresser | 0,689 |
- La longueur de la fenêtre décide de tout. Le même LSTM passe d’une AUC de validation de 0,835 avec
à 0,911 avec
. Les régions périodiques ont des périodes de 15 à 60 agrégations : une fenêtre de 20 ne contient souvent que des zéros, et le modèle ne sait pas où il en est du cycle. Les 9 features, elles, regardent jusqu’à 100 (
moy_100) et 500 (depuis_dernier) instants en arrière. - Le RNN confirme la section 2. Avec la même fenêtre de 64 que le LSTM, il reste à 0,854 : il ne sait exploiter que la fin de la fenêtre.
- Sur la validation, LSTM et Conv1D égalent le MLP, et le battent même légèrement en log-loss (0,2751 et 0,2734 contre 0,2772). À partir des seuls accès bruts, ils ont réappris ce que les 9 features résumaient. C’est déjà un résultat : ces features étaient bien choisies. (Le MLP fait 0,2772 ici contre 0,2759 en partie 22 : le clipping et l’ordre des tirages diffèrent, un écart de l’ordre du bruit entre graines. Son coût de test, 0,655 contre 0,626, rappelle surtout combien le coût dépend du seuil, choisi ici à 0,11 au lieu de 0,07.)
- Sur le test, aucun ne bat le MLP, et les deux meilleurs en validation coûtent plus que « ne jamais compresser » (0,695 et 0,709 contre 0,689). On y revient au bloc 4.
- L’attention seule, à une tête et une couche, déçoit (0,851). Pour savoir où l’on en est d’un cycle, il faut repérer le dernier début d’activité puis compter : une seule moyenne pondérée des instants passés n’y suffit pas. Les Transformers empilent plusieurs couches pour ça.
- La latence est 13 à 48 fois plus élevée. 27 µs pour scorer 96 régions avec le MLP, 358 µs à 1,3 ms pour les modèles de séquences, toujours sur CPU et sans optimisation. Pour un démon qui décide toutes les 100 ms, 1 ms reste acceptable ; pour des millions de pages, c’est un autre sujet (partie 26, servir un modèle).
- Le meilleur pas est au bord de la grille pour cinq modèles sur six ( ). La grille aurait dû aller un cran plus haut : c’est l’exercice 5.
Ce que les modèles ont appris à regarder
# 4. Ce que les modèles ont appris à regarder
# (a) Après entraînement : sensibilité de la sortie à l'entrée d'il y a k pas, RNN contre LSTM
xb = S[64][0][:2048].clone().requires_grad_()
for nom in ["RNN, L = 64", "LSTM, L = 64"]:
    xb.grad = None
    m = modeles[nom]
    m.eval()
    m(xb).sum().backward()
    g = xb.grad.norm(dim=(0, 2))
    print(f"{nom:>13} entraîné | relatif à k = 0 : "
          + " ".join(f"k={k}: {(g[-1 - k] / g[-1]).item():.1e}" for k in (1, 5, 10, 20, 40, 63)))

# (b) Où regarde l'attention ? Poids moyens par décalage, sur la validation
att = modeles["Attention, L = 64"]
att.eval()
with torch.no_grad():
    att(S[64][1][:8192])
poids = att.poids[:, 0].mean(0).numpy()[::-1]              # poids[k] : décalage k (0 = instant t)
print("attention : poids moyen des décalages 0..4 :", np.round(poids[:5], 3),
      "| masse sur les 10 derniers pas :", round(float(poids[:10].sum()), 3),
      "| décalages les plus écoutés :", np.argsort(poids)[::-1][:5])

# (c) Avant et après le changement de régime de t = 2100 : où chaque modèle gagne ou perd
avant = (te.t < 2100).to_numpy()
for nom, (p_va, p_te) in probas.items():
    s = seuils[np.argmin([cout_moyen(y_va, p_va, s) for s in seuils])]
    print(f"{nom:>18} | AUC test avant 2100 {roc_auc_score(y_te[avant], p_te[avant]):.3f}, "
          f"après {roc_auc_score(y_te[~avant], p_te[~avant]):.3f} | coût avant {cout_moyen(y_te[avant], p_te[avant], s):.3f}, "
          f"après {cout_moyen(y_te[~avant], p_te[~avant], s):.3f}")
print(f"ne jamais compresser | coût avant {cout_moyen(y_te[avant], np.ones(avant.sum()), 0.5):.3f}, "
      f"après {cout_moyen(y_te[~avant], np.ones((~avant).sum()), 0.5):.3f}")
La mémoire après entraînement. Même mesure qu’au bloc 2, sur 2 048 fenêtres, avec les modèles entraînés :
| Modèle entraîné | ||||||
|---|---|---|---|---|---|---|
| RNN, | 0,95 | 0,14 | ||||
| LSTM, | 0,24 |
L’entraînement n’a rien changé pour le RNN : au-delà de 20 pas, la fenêtre est invisible. Le LSTM, lui, a appris à garder ses portes d’oubli ouvertes : la sensibilité à l’entrée d’il y a 63 pas (0,059) est du même ordre que celle d’il y a 5 pas. Il a appris à se servir de toute la fenêtre, alors qu’il partait du même point que le RNN.
Où regarde l’attention. En moyenne sur 8 192 fenêtres de validation, le poids de l’instant présent est pratiquement nul (moins de 0,001) : la tête reçoit déjà l’instant directement, elle n’a pas besoin de l’écouter. Les 10 derniers pas reçoivent 28,5 % du poids, et les décalages les plus écoutés sont 27, 38, 28, 7 et 29 instants en arrière, dans la plage des périodes simulées. Lisible, mais pas assez pour bien prédire.
Avant et après le changement de régime. Le test commence à et contient le changement de workload de (partie 14). On sépare les deux périodes :
| Modèle | AUC test avant 2100 | AUC test après | Coût avant | Coût après |
|---|---|---|---|---|
| MLP, 9 features | 0,896 | 0,865 | 0,605 | 0,671 |
| RNN, | 0,838 | 0,818 | 0,674 | 0,692 |
| LSTM, | 0,826 | 0,782 | 0,649 | 0,699 |
| LSTM, | 0,896 | 0,857 | 0,633 | 0,716 |
| Conv1D, | 0,897 | 0,839 | 0,607 | 0,743 |
| Attention, | 0,842 | 0,809 | 0,673 | 0,712 |
| Ne jamais compresser | 0,697 | 0,686 |
C’est la vraie leçon de l’article. Avant le changement, Conv1D et LSTM font exactement aussi bien que le MLP (AUC 0,897 et 0,896 contre 0,896). Après, ils perdent plus : 0,839 et 0,857 contre 0,865, et leur coût passe au-dessus de « ne jamais compresser ». Les 9 features sont des grandeurs relatives et génériques (temps depuis le dernier accès, période estimée) qui gardent leur sens quand une région change de nature. Les filtres et les portes appris sur les accès bruts ont collé plus finement aux motifs d’avant le changement. Plus de capacité, plus de dépendance au régime d’entraînement.
Fil rouge : ce que ça change pour le mémoire
- H2 a maintenant un protocole. Même découpage, même purge, même recette (one-cycle, clipping, meilleure époque), même grille de pas pour chaque modèle, seuil choisi sur la validation, coût de la partie 15. Le LSTM est la référence haute de H2 ; sur cette simulation, il n’est pas au-dessus du MLP sur features. C’est un résultat publiable tel quel, à condition de le montrer avant et après un changement de régime.
- La fenêtre est un hyperparamètre de premier ordre. doit couvrir les plus longues périodes attendues. Sur les vraies traces DAMON (agrégations de 100 ms, cycles du GC JVM de plusieurs secondes), cela peut vouloir dire de plusieurs centaines, donc des LSTM plus lents, ou une Conv1D plus dilatée.
- Les features ne sont pas une béquille. Sur la validation, LSTM et Conv1D ont réappris les 9 features à partir des accès bruts ; sur le test, les features généralisent mieux. Le chapitre Discussion peut l’écrire comme ça : le gain d’un modèle de séquences doit venir de motifs que les features ne capturent pas, et les vraies traces sont l’endroit où le chercher (accès irréguliers, interactions entre régions).
- Le modèle hybride est le candidat naturel : un LSTM sur la fenêtre brute, dont l’état final est concaténé aux 9 features avant la tête. C’est l’exercice 3.
- La latence entre dans le tableau de résultats. 27 µs contre 1 ms pour 96 régions : à mesurer sur la machine cible, avec le même protocole (médiane sur 200 appels), dans le chapitre Expériences.
Exercice pratique
- LSTM ou GRU ? Remplace
Recurrent("lstm")parRecurrent("gru")avec et un pas maximal de . Compare le nombre de paramètres, la log-loss de validation, l’AUC et le coût de test, le temps d’entraînement et la latence. - Le biais d’oubli, une fois entraîné. Le bloc 2 a montré qu’un biais d’oubli à 3 garde toute la fenêtre visible à l’initialisation. Entraîne
Recurrent("lstm", biais_oubli=3.0)avec (pas maximal ). Ce gain de mémoire au départ se traduit-il en performance à la fin ? - Le modèle hybride. Écris un module qui passe les 2 canaux de la fenêtre dans un LSTM, concatène son dernier état caché (32 valeurs) aux 9 features standardisées de la ligne, puis applique une tête
Linear(41, 32) → ReLU → Linear(32, 1). Astuce : pour réutiliserentrainersans la modifier, colle les 9 features à chaque pas de la fenêtre (un tenseur(n, 64, 11)) et sépare-les dansforward. Compare au MLP et au LSTM seuls, avant et après . - Une fenêtre plus longue. Refais le LSTM avec
(la fenêtre de
moy_100). Note le temps d’entraînement et la latence : sont-ils proportionnels à ? - Étendre la grille. Pour cinq modèles sur six, le meilleur pas était le plus grand de la grille. Ajoute et regarde si le classement change.
- Fil rouge. Écris le protocole de H2 pour le chapitre Méthodologie (modèles, fenêtre, grille de pas, nombre d’époques, graines, métriques, latence), puis mesure sur une vraie trace DAMON la plus longue période d’accès que tu observes. Quelle valeur de en déduis-tu ?
Indices. Question 1 : le GRU a 3 489 paramètres, 25 % de moins que le LSTM dans la partie récurrente. Meilleure époque 12, log-loss de validation 0,2725, AUC de validation 0,911, AUC de test 0,871, seuil 0,03, coût de test 0,623 : le meilleur coût de l’article, mais avec un seuil si bas qu’un léger décalage de calibration le ferait basculer, à confirmer sur plusieurs graines. Entraînement 193 s et latence 2 918 µs : sur ce CPU, l’implémentation du GRU est plus lente que celle du LSTM malgré moins de calcul. Mesure toujours la latence, ne la déduis pas du nombre de paramètres. Question 2 : meilleure époque 8, log-loss de validation 0,2769, AUC de validation 0,913, AUC de test 0,863, coût 0,682 : pas mieux que le LSTM par défaut (0,2751). Avec 123 840 fenêtres et 20 époques, le LSTM apprend tout seul à ouvrir ses portes (bloc 4) ; le biais d’oubli compte surtout pour des fenêtres plus longues ou des données plus rares. Question 3 : 5 985 paramètres, meilleure époque 17, log-loss de validation 0,2642 (la meilleure de l’article), AUC de validation 0,913, AUC de test 0,862 (0,892 avant 2100, 0,850 après), seuil 0,04, coût 0,629. L’hybride est le mieux calibré sur la validation, mais il perd lui aussi plus que le MLP après le changement de régime : la partie séquence ajoute de la dépendance au régime d’entraînement.
Ressources pour aller plus loin
- Christopher Olah, Understanding LSTM Networks (2015) : les schémas qui rendent les portes évidentes.
- Hochreiter & Schmidhuber, Long Short-Term Memory (Neural Computation, 1997) ; Pascanu, Mikolov & Bengio, On the difficulty of training recurrent neural networks (ICML 2013) : le gradient qui disparaît ou explose, et le clipping.
- Jozefowicz, Zaremba & Sutskever, An Empirical Exploration of Recurrent Network Architectures (ICML 2015) : le biais d’oubli à 1, et GRU contre LSTM.
- Bai, Kolter & Koltun, An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling (2018) : les convolutions dilatées (TCN) face aux LSTM.
- Vaswani et al., Attention Is All You Need (NeurIPS 2017) : requêtes, clés, valeurs et le facteur .
- Hashemi et al., Learning Memory Access Patterns (ICML 2018) : des LSTM pour prédire des accès mémoire, le travail le plus proche de ton mémoire.
- Dive into Deep Learning, chapitres Réseaux de neurones récurrents et Mécanismes d’attention.
- Rappels : M1 · Vecteurs et produit scalaire, M5 · Règle de la chaîne, partie 22 · Bien entraîner un réseau.
Ce que tu dois savoir faire avant de passer à la suite
- Transformer une trace en fenêtres
(batch, L, canaux)sans fuite : fenêtre qui s’arrête à , statistiques du seul entraînement - Expliquer avec la règle de la chaîne pourquoi un RNN oublie géométriquement, et mesurer cette mémoire avec
- Écrire un LSTM en PyTorch, et initialiser son biais d’oubli
- Calculer le champ réceptif d’une Conv1D dilatée
- Écrire une tête d’attention, et lire ses poids
- Comparer un modèle de séquences à un modèle sur features à budget égal, avant et après un changement de régime, latence comprise
- Choisir en fonction des périodes que le modèle doit voir
Partie suivante : Projet fil rouge : cette page est-elle chaude ou froide ? (partie 24). On assemble tout dans un projet complet et reproductible, face aux baselines LRU, CLOCK et à l’oracle de Belady, avec plusieurs graines, et on trace le front de Pareto « faux froids contre coût d’inférence » où le LSTM de cet article prendra sa place.