Bien entraîner un réseau de neurones
Test d'amplitude du pas, SGD, momentum et Adam, initialisation, LayerNorm, dropout et weight decay : on casse exprès l'entraînement d'un MLP, on lit les courbes, puis on le répare.
Mastering AI · Phase technique · Semaine 3 · Partie 22
Objectif de l’étape
Dans la partie 21, on a écrit une boucle d’entraînement PyTorch qui marche, avec les réglages par défaut : AdamW, pas de , 20 époques. Le réseau n’a jamais surappris, et on n’a jamais eu à se demander si le pas était le bon. Ce confort ne durera pas : les modèles de séquences de la partie 23 sont plus profonds, plus lents à entraîner, et beaucoup plus sensibles à ces réglages.
Cet article est une boîte à outils de diagnostic. On va volontairement casser l’entraînement de plusieurs façons, regarder à quoi ressemble chaque panne sur les courbes, puis la réparer.
À la fin de cet article, tu sauras :
- choisir un pas d’apprentissage de départ avec un test d’amplitude (LR range test) au lieu de le deviner ;
- comparer SGD, momentum et Adam et expliquer leurs différences avec les maths de M10 ;
- expliquer pourquoi l’initialisation décide si un réseau profond apprend, et ce que corrige une normalisation ;
- provoquer un surapprentissage, puis le combattre avec early stopping, weight decay et dropout ;
- lire une courbe de perte : divergence, plateau, surapprentissage, sous-apprentissage.
Notions clés
1. Le pas d’apprentissage, le réglage qui compte le plus
Intuition. Tu descends une vallée dans le brouillard. Avec des pas de fourmi, tu n’arrives jamais en bas. Avec des pas de géant, tu sautes par-dessus le fond et tu te retrouves sur l’autre versant, de plus en plus haut. Entre les deux, il existe une plage de pas où l’on descend vite et sans osciller.
En M6, on a vu que sur une quadratique, la descente de gradient converge seulement si , où est la plus grande courbure. Sur un réseau, on ne connaît pas , et elle change pendant l’entraînement. D’où une méthode empirique, le test d’amplitude du pas (Leslie Smith, 2017) :
- on part d’un pas minuscule ( ) ;
- à chaque mini-batch, on le multiplie par un facteur constant, pour atteindre un pas énorme ( ) en une seule époque ;
- on trace la perte (lissée) en fonction du pas, en échelle logarithmique.
La perte ne bouge pas tant que le pas est trop petit, puis descend, puis explose. On choisit un pas environ dix fois plus petit que celui du minimum : assez grand pour avancer, avec une marge avant l’instabilité.
2. SGD, momentum, Adam : trois façons de faire un pas
Intuition. SGD suit la pente du moment. Le momentum ajoute de l’inertie : une bille qui roule accumule de la vitesse dans les directions constantes et amortit les zigzags. Adam donne en plus à chaque paramètre sa propre taille de pas.
Deux conséquences directes, qu’on va vérifier dans le code :
- avec un momentum , un gradient constant produit une vitesse : le pas effectif est dix fois plus grand. SGD momentum avec doit donc se comporter à peu près comme SGD sans momentum avec ;
- Adam divise le gradient moyen par sa propre amplitude . Chaque paramètre avance donc d’environ par pas, quelle que soit la taille de son gradient, tant que celle-ci dépasse nettement . C’est très pratique (moins de réglages), mais ça peut aussi masquer un problème, on le verra avec l’initialisation.
AdamW est Adam avec un weight decay découplé : à chaque pas, , appliqué à part, au lieu d’ajouter à la perte. C’est la pénalité L2 de M11, écrite pour qu’elle ne soit pas renormalisée par Adam.
3. L’initialisation : garder le signal à la bonne taille
Intuition. Un réseau profond est une chaîne de multiplications. Si chaque couche multiplie la taille du signal par 0,5, après 16 couches il reste du signal. Par 2, il est multiplié par 65 536. Le gradient, qui remonte la même chaîne (M5), subit le même sort : il disparaît ou il explose.
Avec les variances de M7, pour une couche de entrées, des poids indépendants de variance et une ReLU (qui annule la moitié du signal) :
Pour que le signal garde sa taille, il faut que ce facteur vaille 1, c’est-à-dire
: c’est l’initialisation de He (2015), conçue pour la ReLU. L’initialisation de Xavier (Glorot, 2010),
, a été pensée pour des activations symétriques comme tanh ; avec une ReLU et des couches de 64, elle donne un facteur
en variance, soit environ 0,7 en écart-type par couche. L’initialisation par défaut de nn.Linear donne
, soit un facteur d’environ 0,4 par couche : très bien pour 2 couches, pas pour 16.
4. La normalisation : remettre le signal à l’échelle à chaque couche
Intuition. Plutôt que de compter sur une initialisation parfaite, on remet le signal à moyenne 0 et variance 1 à chaque couche, puis on laisse le réseau choisir l’échelle qui lui convient.
- LayerNorm calcule et sur les neurones d’un seul exemple. Elle se comporte pareil à l’entraînement et en production, quelle que soit la taille du batch. C’est la normalisation des LSTM et des Transformers (partie 23).
- BatchNorm calcule
et
sur les exemples du mini-batch, et garde des moyennes mobiles pour l’évaluation. C’est la raison pour laquelle
model.eval()change son comportement (partie 21). Elle domine en vision ; on ne l’utilise pas ici.
5. Régulariser : early stopping, weight decay, dropout
Intuition. Un réseau assez grand pour apprendre le bruit finira par l’apprendre. Trois freins, du plus simple au plus subtil :
| Technique | Ce qu’elle fait | Lien avec les maths |
|---|---|---|
| Early stopping | on s’arrête quand la validation ne s’améliore plus depuis patience époques, et on garde la meilleure époque |
limiter le nombre de pas limite la distance parcourue depuis l’initialisation, un effet proche de L2 |
| Weight decay | chaque poids est tiré vers 0 à chaque pas | la pénalité L2 de M11, la contrainte |
| Dropout | à l’entraînement, chaque neurone est éteint avec probabilité , les survivants sont multipliés par ; à l’évaluation, rien n’est éteint | le réseau ne peut plus compter sur un neurone précis : c’est une moyenne sur de nombreux sous-réseaux |
6. Faire varier le pas pendant l’entraînement
Intuition. Au début, on veut des grands pas pour traverser le paysage ; à la fin, des petits pas pour se poser au fond sans rebondir. Un planning (scheduler) fait varier au fil des itérations. Le one-cycle (Smith, 2018) monte d’abord le pas de à pendant 30 % des itérations, puis le redescend en cosinus jusqu’à presque 0. On prend dans la zone donnée par le test d’amplitude.
Exemple de code
Comme en parties 15 à 21, on reprend tel quel le script de la partie 14 (simulation et dataset), puis on ajoute les cinq blocs ci-dessous à la suite. On réutilise le découpage de la partie 15 et les entrées de la partie 21 (log1p puis standardisation avec les statistiques du seul entraînement). L’ensemble tourne en environ quatre minutes sur un CPU à deux cœurs (numpy 2.5, pandas 3.0, scikit-learn 1.9, torch 2.14).
Les outils, et le test d’amplitude du pas
La fonction ajuster est la boucle de la partie 21, avec trois ajouts : un planning de pas optionnel, l’arrêt si la perte devient infinie, et l’early stopping. Elle garde toujours la meilleure époque sur la validation.
import time
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.metrics import log_loss

torch.set_num_threads(2)

# Le découpage de la partie 15 : entraînement t < 1390, validation 1400 <= t < 1790, test t >= 1800
tr = df[df.t < 1390]
va = df[(df.t >= 1400) & (df.t < 1790)]
te = df[df.t >= 1800]


def tenseurs(d):
    """log1p, puis standardisation avec les statistiques du seul entraînement (partie 21)."""
    A, R = np.log1p(d[FEATURES]), np.log1p(tr[FEATURES])
    A = (A - R.mean()) / R.std()
    return (torch.tensor(A.to_numpy(), dtype=torch.float32),
            torch.tensor(d.y.to_numpy(), dtype=torch.float32))


Xtr, ytr = tenseurs(tr)
Xva, yva = tenseurs(va)
Xte, yte = tenseurs(te)


def mlp(largeurs, p_dropout=0.0, norm=False):
    """largeurs = [9, 32, 32, 1] -> pile Linear/ReLU ; LayerNorm et Dropout optionnels après chaque couche cachée."""
    couches = []
    for a, b in zip(largeurs[:-2], largeurs[1:-1]):
        couches += [nn.Linear(a, b)] + ([nn.LayerNorm(b)] if norm else []) + [nn.ReLU()]
        couches += [nn.Dropout(p_dropout)] if p_dropout > 0 else []
    couches.append(nn.Linear(largeurs[-2], largeurs[-1]))
    return nn.Sequential(*couches)


def evaluer(modele, X, y):
    modele.eval()
    with torch.no_grad():
        p = torch.sigmoid(modele(X).squeeze(-1)).numpy()
    return roc_auc_score(y.numpy(), p), log_loss(y.numpy(), p, labels=[0, 1])


def ajuster(modele, opt, Xtr, ytr, Xva, yva, epoques=20, batch=512, planning=None, patience=None, graine=0):
    """La boucle de la partie 21 + trois ajouts : planning par pas, détection de divergence, early stopping."""
    torch.manual_seed(graine)
    perte_fn = nn.BCEWithLogitsLoss()
    chargeur = DataLoader(TensorDataset(Xtr, ytr), batch_size=batch, shuffle=True)
    meilleure, etat, hist, attente = np.inf, None, [], 0
    for epoque in range(1, epoques + 1):
        modele.train()
        somme = 0.0
        for xb, yb in chargeur:
            opt.zero_grad()
            perte = perte_fn(modele(xb).squeeze(-1), yb)
            perte.backward()
            opt.step()
            if planning is not None:
                planning.step()                   # one-cycle : le pas change à chaque batch
            somme += perte.item() * len(yb)
        if not np.isfinite(somme):                # divergence : la perte est devenue inf ou nan
            hist.append((epoque, np.nan, np.nan, np.nan))
            break
        auc_va, ll_va = evaluer(modele, Xva, yva)
        hist.append((epoque, somme / len(ytr), ll_va, auc_va))
        if ll_va < meilleure:
            meilleure, etat, attente = ll_va, {k: v.clone() for k, v in modele.state_dict().items()}, 0
        else:
            attente += 1
            if patience is not None and attente >= patience:
                break                             # early stopping
    if etat is not None:
        modele.load_state_dict(etat)              # on garde la meilleure époque sur la validation
    return hist


# 1. Le test d'amplitude du pas (LR range test, Smith 2017) : une seule époque, pas multiplié à chaque batch
def test_amplitude(fabrique_opt, lr_min=1e-5, lr_max=1e3, graine=0):
    torch.manual_seed(graine)
    modele = mlp([9, 32, 32, 1])
    opt = fabrique_opt(modele.parameters(), lr_min)
    chargeur = DataLoader(TensorDataset(Xtr, ytr), batch_size=512, shuffle=True)
    facteur = (lr_max / lr_min) ** (1 / (len(chargeur) - 1))
    perte_fn, lrs, pertes, lisse = nn.BCEWithLogitsLoss(), [], [], 0.0
    for i, (xb, yb) in enumerate(chargeur):
        lr = lr_min * facteur ** i
        for g in opt.param_groups:
            g["lr"] = lr
        opt.zero_grad()
        perte = perte_fn(modele(xb).squeeze(-1), yb)
        perte.backward()
        opt.step()
        lisse = 0.9 * lisse + 0.1 * perte.item()             # moyenne mobile exponentielle...
        lrs.append(lr)
        pertes.append(lisse / (1 - 0.9 ** (i + 1)))          # ...avec correction de biais (comme Adam)
        if not np.isfinite(pertes[-1]) or pertes[-1] > 4 * min(pertes):
            break                                            # la perte explose : on s'arrête
    i_min = int(np.argmin(pertes))
    return lrs, pertes, lrs[i_min], lrs[-1]


for nom, fabrique_opt in [("AdamW", lambda p, lr: torch.optim.AdamW(p, lr=lr, weight_decay=1e-4)),
                          ("SGD momentum 0.9", lambda p, lr: torch.optim.SGD(p, lr=lr, momentum=0.9))]:
    lrs, pertes, lr_min_perte, lr_explose = test_amplitude(fabrique_opt)
    print(f"{nom:>16} | perte lissée min {min(pertes):.3f} à lr = {lr_min_perte:.2g} | "
          f"explose à lr = {lr_explose:.2g} | lr conseillé ~ {lr_min_perte / 10:.1g}")
Sortie :
           AdamW | perte lissée min 0.396 à lr = 0.12 | explose à lr = 69 | lr conseillé ~ 0.01
SGD momentum 0.9 | perte lissée min 0.396 à lr = 3 | explose à lr = 7 | lr conseillé ~ 0.3
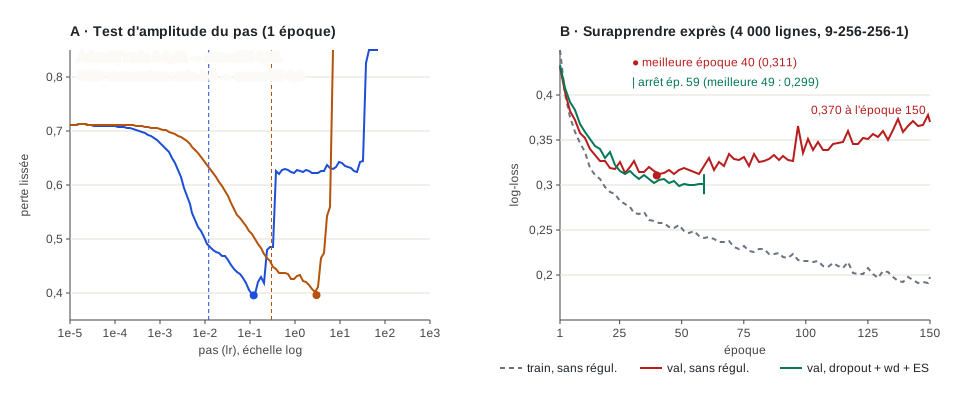
Le panneau A de la figure montre les deux courbes. Pour AdamW, la perte commence à descendre vers , atteint son minimum à 0,12, puis remonte d’un coup vers 0,62 et y reste avant d’exploser. Le pas conseillé est donc , dix fois plus que le utilisé par défaut. Pour SGD momentum, toute la courbe est décalée d’un facteur 25 environ vers la droite : le minimum est à 3, le pas conseillé à 0,3. Un même nombre « lr » n’a pas du tout le même sens d’un optimiseur à l’autre.
Trois optimiseurs, douze réglages, une même grille
On vérifie ces prédictions en entraînant le même MLP 9-32-32-1, avec la même graine, pendant 8 époques pour chaque réglage.
# 2. Le même MLP, trois optimiseurs, plusieurs pas, 8 époques chacun
configs = [("SGD", 0.01), ("SGD", 0.1), ("SGD", 1.0),
           ("SGD momentum", 0.01), ("SGD momentum", 0.1), ("SGD momentum", 1.0), ("SGD momentum", 10.0),
           ("AdamW", 1e-4), ("AdamW", 1e-3), ("AdamW", 1e-2), ("AdamW", 1e-1), ("AdamW", 1.0)]
taux = yva.mean().item()
print(f"référence : prédire toujours le taux de positifs {taux:.3f} donne une log-loss val de "
      f"{log_loss(yva.numpy(), np.full(len(yva), taux)):.4f}")
courbes = {}
for nom_opt, lr in configs:
    torch.manual_seed(0)
    modele = mlp([9, 32, 32, 1])
    if nom_opt == "AdamW":
        opt = torch.optim.AdamW(modele.parameters(), lr=lr, weight_decay=1e-4)
    else:
        opt = torch.optim.SGD(modele.parameters(), lr=lr, momentum=0.9 if "momentum" in nom_opt else 0.0)
    t0 = time.perf_counter()
    hist = ajuster(modele, opt, Xtr, ytr, Xva, yva, epoques=8)
    courbes[(nom_opt, lr)] = hist
    val = [h[2] for h in hist]
    print(f"{nom_opt:>12} lr={lr:<6g} | log-loss val ép. 1 {val[0]:.4f} -> ép. {len(val)} {val[-1]:.4f} | "
          f"meilleure {np.nanmin(val):.4f} | train {hist[-1][1]:.4f} | {time.perf_counter() - t0:.0f} s")
La référence d’abord : prédire toujours le taux de positifs de la validation (0,301) donne une log-loss de 0,6116. Retiens ce nombre, il revient.
| Optimiseur | Pas | Log-loss val, époque 1 | Époque 8 | Meilleure |
|---|---|---|---|---|
| SGD | 0,01 | 0,5624 | 0,4464 | 0,4464 |
| SGD | 0,1 | 0,4368 | 0,3314 | 0,3314 |
| SGD | 1 | 0,3514 | 0,2884 | 0,2884 |
| SGD momentum | 0,01 | 0,4404 | 0,3331 | 0,3331 |
| SGD momentum | 0,1 | 0,3344 | 0,2939 | 0,2895 |
| SGD momentum | 1 | 0,3027 | 0,2874 | 0,2856 |
| SGD momentum | 10 | 0,6949 | 0,6524 | 0,6116 |
| AdamW | 0,0001 | 0,6003 | 0,4154 | 0,4154 |
| AdamW | 0,001 | 0,4107 | 0,2978 | 0,2978 |
| AdamW | 0,01 | 0,3107 | 0,2869 | 0,2832 |
| AdamW | 0,1 | 0,3000 | 0,2853 | 0,2853 |
| AdamW | 1 | 0,6118 | 0,6116 | 0,6116 |
- Le momentum multiplie bien le pas par dix. SGD momentum à 0,01 (0,3331) fait presque exactement comme SGD sans momentum à 0,1 (0,3314). C’est la formule de la section 2.
- Le test d’amplitude avait raison. Le meilleur AdamW est à (0,2832), le pas qu’il conseillait. Avec le par défaut, après 8 époques on est encore à 0,2978 : le réglage par défaut n’est pas faux, il est lent.
- Trop petit, c’est lent ; trop grand, c’est cassé. AdamW à et SGD à 0,01 descendent encore à l’époque 8. Ce sont des plateaux de sous-apprentissage, pas des minima.
- Ici, la divergence ne produit pas de
nan: elle produit une constante. SGD momentum à 10 et AdamW à 1 finissent à 0,6116, exactement la log-loss de « toujours prédire 0,301 ». Dans les deux cas (on l’a vérifié après coup), un pas trop grand a poussé les 32 ReLU de la deuxième couche cachée dans la zone négative pour toutes les entrées : elles renvoient 0, leur gradient est nul, et elles ne se réveilleront jamais. Seul le biais de sortie apprend encore, et il apprend le taux de base. C’est la panne qu’on reproduit à l’exercice 1.
Initialisation et normalisation dans un réseau profond
Pour voir les gradients disparaître, il faut de la profondeur : on empile 16 couches cachées de 64 ReLU. Pour chaque initialisation, on mesure la taille du signal à la dernière couche cachée et la norme du gradient de la première et de la seizième couche, sur un batch de 512 lignes, avant tout entraînement. Puis on entraîne 3 époques avec AdamW.
# 3. Initialisation et circulation du gradient dans un réseau profond : 16 couches cachées de 64 ReLU
def reseau_profond(init, norm=False, profondeur=16, largeur=64):
    torch.manual_seed(0)
    modele = mlp([9] + [largeur] * profondeur + [1], norm=norm)
    for m in modele:
        if isinstance(m, nn.Linear):
            nn.init.zeros_(m.bias)
            if init == "N(0, 0.01)":
                nn.init.normal_(m.weight, std=0.01)
            elif init == "Xavier":
                nn.init.xavier_normal_(m.weight)          # Var(w) = 2 / (n_in + n_out)
            elif init == "He":
                nn.init.kaiming_normal_(m.weight, nonlinearity="relu")   # Var(w) = 2 / n_in
    return modele


xb, yb = Xtr[:512], ytr[:512]
for init, norm in [("N(0, 0.01)", False), ("Xavier", False), ("He", False), ("défaut PyTorch", False),
                   ("défaut PyTorch", True)]:
    modele = reseau_profond(init, norm)
    lineaires = [m for m in modele if isinstance(m, nn.Linear)]
    h = xb
    for m in modele[:-1]:
        h = m(h)
    nn.BCEWithLogitsLoss()(modele(xb).squeeze(-1), yb).backward()
    g_premiere, g_derniere = lineaires[0].weight.grad.norm().item(), lineaires[-2].weight.grad.norm().item()
    hist = ajuster(modele, torch.optim.AdamW(modele.parameters(), lr=1e-3, weight_decay=1e-4),
                   Xtr, ytr, Xva, yva, epoques=3)
    nom = init + (" + LayerNorm" if norm else "")
    print(f"{nom:>26} | écart-type dernière couche cachée {h.std().item():.1e} | grad. couche 1 {g_premiere:.1e} "
          f"/ couche 16 {g_derniere:.1e} | log-loss val après 3 époques {hist[-1][2]:.4f}")
| Initialisation | Écart-type, couche cachée 16 | Gradient couche 1 | Gradient couche 16 | Log-loss val après 3 époques |
|---|---|---|---|---|
| 0,6116 | ||||
| Xavier | 0,2916 | |||
| He | 0,48 | 0,37 | 1,1 | 0,2858 |
| Défaut PyTorch | 0,2866 | |||
| Défaut PyTorch + LayerNorm | 0,58 | 0,73 | 2,3 | 0,2912 |
- La formule de la section 3 se vérifie. Avec , chaque couche multiplie l’écart-type par : en 16 couches, le signal tombe à . Avec le défaut PyTorch, le facteur est d’environ 0,4 par couche : à la fin. Avec He, le signal garde une taille d’ordre 1.
- Adam rattrape presque tout, et c’est trompeur. Avec le défaut PyTorch, les gradients sont de l’ordre de , et pourtant le réseau apprend (0,2866) : Adam divise par , donc un gradient de donne le même pas qu’un gradient de 1. Avec , les gradients de sont noyés sous : le pas vaut environ , et le réseau reste à 0,6116, la constante. Avec SGD, il n’y a pas ce filet de sécurité : c’est l’exercice 2.
- LayerNorm répare le signal sans toucher à l’initialisation. Avec la même initialisation par défaut, le signal reste d’ordre 1 (0,58) et les gradients aussi. Dans ce réseau, avec Adam, elle n’améliore pas le résultat final (0,2912 contre 0,2866) ; elle compte surtout quand l’initialisation est mauvaise ou que le réseau est récurrent.
Surapprendre exprès, puis régulariser
Le MLP de la partie 21 ne surapprenait pas : 1 409 paramètres pour 123 840 exemples. Pour étudier la régularisation, il faut d’abord un réseau qui surapprend. On le provoque en inversant le rapport : un réseau 9-256-256-1 (68 609 paramètres) sur 4 000 lignes tirées au hasard dans l’entraînement, pendant 150 époques. La validation et le test restent les mêmes.
# 4. Surapprendre exprès : 4 000 lignes d'entraînement, un réseau 9-256-256-1, 150 époques
g = np.random.default_rng(0)
petit = torch.tensor(g.choice(len(Xtr), 4000, replace=False))
Xp, yp = Xtr[petit], ytr[petit]


def regularisation(nom, wd=0.0, p_dropout=0.0, patience=None, epoques=150):
    torch.manual_seed(0)
    modele = mlp([9, 256, 256, 1], p_dropout=p_dropout)
    opt = torch.optim.AdamW(modele.parameters(), lr=1e-3, weight_decay=wd)
    hist = ajuster(modele, opt, Xp, yp, Xva, yva, epoques=epoques, batch=128, patience=patience)
    best = min(hist, key=lambda r: r[2])
    print(f"{nom:>26} | meilleure ép. {best[0]:>3} / {len(hist):>3} faites | train {hist[-1][1]:.4f} | "
          f"val à la meilleure {best[2]:.4f}, à la fin {hist[-1][2]:.4f} | AUC test {evaluer(modele, Xte, yte)[0]:.3f}")
    return hist


n_params = sum(p.numel() for p in mlp([9, 256, 256, 1]).parameters())
print(f"{n_params} paramètres pour {len(yp)} exemples")
surappr = {
    "sans régularisation": regularisation("sans régularisation"),
    "early stopping (10)": regularisation("early stopping (10)", patience=10),
    "weight decay 0.1": regularisation("weight decay 0.1", wd=0.1),
    "dropout 0.3": regularisation("dropout 0.3", p_dropout=0.3),
    "dropout 0.3 + wd 0.1 + ES": regularisation("dropout 0.3 + wd 0.1 + ES", wd=0.1, p_dropout=0.3, patience=10),
}
| Réglage (68 609 paramètres, 4 000 exemples) | Meilleure époque / faites | Log-loss train (fin) | Val à la meilleure | Val à la fin | AUC test |
|---|---|---|---|---|---|
| Sans régularisation | 40 / 150 | 0,1977 | 0,3106 | 0,3700 | 0,859 |
| Early stopping (patience 10) | 40 / 50 | 0,2480 | 0,3106 | 0,3190 | 0,859 |
| Weight decay 0,1 | 52 / 150 | 0,2178 | 0,3083 | 0,3305 | 0,862 |
| Dropout 0,3 | 73 / 150 | 0,2420 | 0,2983 | 0,3117 | 0,867 |
| Dropout 0,3 + weight decay 0,1 + early stopping | 49 / 59 | 0,2766 | 0,2991 | 0,3009 | 0,868 |
Le panneau B de la figure montre la signature du surapprentissage : la perte d’entraînement descend sans fin (jusqu’à 0,19), la validation touche son minimum à l’époque 40 (0,311), puis remonte jusqu’à 0,370.
- L’early stopping ne change pas le modèle, il économise le calcul.
ajustergarde toujours la meilleure époque : sans régularisation comme avec early stopping, on obtient le même modèle (0,3106, AUC 0,859). La différence, c’est 50 époques au lieu de 150. Sans cette sauvegarde de la meilleure époque, on aurait gardé le modèle de l’époque 150 (0,3700). - Le weight decay aide un peu ; le dropout aide le plus. Le weight decay 0,1 décale le minimum (époque 52) et l’abaisse légèrement (0,3083). Le dropout 0,3 l’abaisse vraiment (0,2983) : le réseau ne peut plus apprendre par cœur en s’appuyant sur quelques neurones précis.
- Combinés, on retrouve presque le réseau entraîné sur tout. Avec 31 fois moins de données, la combinaison atteint une AUC de test de 0,868, celle du MLP de la partie 21 entraîné sur les 123 840 lignes. Tout le gain vient d’un frein à l’apprentissage du bruit.
- La perte d’entraînement n’est pas un objectif. La meilleure validation correspond à une perte d’entraînement plus haute (0,2766 contre 0,1977). Un modèle qui colle trop bien à l’entraînement est exactement ce qu’on veut éviter.
Retour à toutes les données : le one-cycle
On revient aux 123 840 lignes et au réseau 9-32-32-1 de la partie 21, avec le pas conseillé par le test d’amplitude comme pas maximal d’un one-cycle.
# 5. Retour à toutes les données : pas constant (partie 21) contre one-cycle
def cout_moyen(y, p, seuil, c_fn=10, c_fp=1):
    return (c_fn * np.sum((y == 1) & (p < seuil)) + c_fp * np.sum((y == 0) & (p >= seuil))) / len(y)


seuils = np.linspace(0.01, 0.99, 99)
for nom in ["lr constant 1e-3", "one-cycle max 1e-2"]:
    torch.manual_seed(0)
    modele = mlp([9, 32, 32, 1])
    opt = torch.optim.AdamW(modele.parameters(), lr=1e-3, weight_decay=1e-4)
    planning = None
    if nom.startswith("one-cycle"):
        planning = torch.optim.lr_scheduler.OneCycleLR(opt, max_lr=1e-2, epochs=20,
                                                       steps_per_epoch=int(np.ceil(len(ytr) / 512)))
    t0 = time.perf_counter()
    hist = ajuster(modele, opt, Xtr, ytr, Xva, yva, epoques=20, planning=planning)
    best = min(hist, key=lambda r: r[2])
    modele.eval()
    with torch.no_grad():
        p_va, p_te = (torch.sigmoid(modele(X).squeeze(-1)).numpy() for X in (Xva, Xte))
    s = seuils[np.argmin([cout_moyen(va.y.to_numpy(), p_va, s) for s in seuils])]
    print(f"{nom:>18} | meilleure ép. {best[0]:>2} | log-loss val {best[2]:.4f} | AUC val {best[3]:.3f} | "
          f"AUC test {roc_auc_score(te.y, p_te):.3f} | seuil {s:.2f} | coût test "
          f"{cout_moyen(te.y.to_numpy(), p_te, s):.3f} | {time.perf_counter() - t0:.0f} s")
| Pas, 20 époques | Meilleure époque | Log-loss val | AUC val | AUC test | Seuil (val) | Coût test |
|---|---|---|---|---|---|---|
| Constant (partie 21) | 19 | 0,2907 | 0,906 | 0,869 | 0,08 | 0,645 |
| One-cycle, max | 20 | 0,2759 | 0,915 | 0,872 | 0,07 | 0,626 |
| Ne jamais compresser | 0,689 |
- Même réseau, même nombre d’époques, meilleur partout. Le one-cycle gagne 0,015 de log-loss de validation, 0,9 point d’AUC de validation, et fait baisser le coût de test (un faux froid coûte 10, un faux chaud 1, comme en partie 15) de 0,645 à 0,626, toujours sous « ne jamais compresser » (0,689).
- Le pas constant ne reproduit pas exactement la partie 21 (0,2907 ici contre 0,2901) : le réseau est construit par
mlpau lieu de la classeMLP, et la graine est réinitialisée avant le mélange des batchs. L’ordre des tirages change, les conclusions non. C’est aussi un rappel : une différence de 0,001 entre deux graines n’est pas un résultat. - Prudence sur le test. Une graine, un seul découpage : comme en partie 21, le gain de coût doit être confirmé sur plusieurs graines avant d’être cité. L’exercice 5 fait varier le pas maximal.
Lire une courbe de perte
Ce tableau résume les pannes rencontrées dans cet article. C’est la première chose à regarder quand un entraînement déçoit.
| Ce que tu vois | Diagnostic probable | Premier remède |
|---|---|---|
La perte devient nan ou inf |
pas beaucoup trop grand, ou perte instable (sigmoïde puis log au lieu de BCEWithLogitsLoss) |
diviser le pas par 10 ; perte sur les logits |
| La perte se fige à la valeur de la constante (ici 0,6116) | divergence silencieuse : ReLU mortes après un pas trop grand, ou gradient noyé à l’initialisation | test d’amplitude, puis pas 10 fois plus petit ; vérifier la norme des gradients couche par couche |
| Train et val descendent ensemble, lentement, encore à la fin | pas trop petit, ou pas assez d’époques | test d’amplitude, one-cycle |
| Train et val stagnent ensemble trop haut | sous-apprentissage : réseau trop petit ou features insuffisantes | réseau plus large, meilleures features (partie 19) |
| Train descend, val remonte | surapprentissage | garder la meilleure époque, dropout, weight decay, plus de données |
| Val oscille fortement d’une époque à l’autre | pas trop grand en fin d’entraînement, ou validation trop petite | planning qui fait décroître le pas ; plus de validation |
Une règle de méthode, empruntée à Karpathy : avant d’entraîner sur tout, vérifie que ton réseau sait surapprendre un tout petit échantillon. S’il n’arrive même pas à apprendre 4 000 lignes par cœur, le problème est dans le code (perte, données, pas), pas dans la régularisation.
Fil rouge : ce que ça change pour le mémoire
- Le protocole d’entraînement devient une recette écrite. Pour chaque réseau du chapitre Expériences (MLP, puis LSTM en partie 23) : test d’amplitude, pas = minimum / 10, one-cycle, meilleure époque sur la validation, early stopping. C’est court à écrire dans la Méthodologie et ça évite le reproche « vous avez réglé le LSTM mieux que le MLP » (ou l’inverse).
- Le pas est un hyperparamètre comme les autres. Il doit être choisi sur la validation, avec le même budget pour chaque modèle comparé, comme le nombre de feuilles du LightGBM en partie 18. Le one-cycle a fait gagner autant que bien des changements d’architecture.
- Les vraies traces DAMON seront plus petites que la simulation. Quelques minutes de trace par workload, c’est peut-être quelques milliers de lignes utiles : exactement la situation du bloc 4. Dropout et early stopping ne seront pas optionnels.
- Surveille la norme des gradients. Pour le LSTM, qui multiplie la même matrice à chaque pas de temps, la disparition et l’explosion du gradient sont le problème central. On réutilisera la mesure du bloc 3, et
clip_grad_norm_.
Exercice pratique
- Faire diverger, puis réparer. Entraîne le MLP 9-32-32-1 avec
torch.optim.SGD(..., lr=10, momentum=0.9)pendant 8 époques. Après l’entraînement, compte les neurones de la deuxième couche cachée qui valent 0 pour toutes les lignes de validation, et regarde l’écart-type des logits. Essaie ensuite de réparer de deux façons : en ajoutantnn.utils.clip_grad_norm_(modele.parameters(), 1.0)entrebackward()etstep(), puis en prenant le pas conseillé par le test d’amplitude (0,3). Laquelle marche, et pourquoi ? - Ce qu’Adam cache. Entraîne le réseau profond du bloc 3 avec l’initialisation par défaut, mais avec
SGD(lr=0.1, momentum=0.9), pendant 3 époques. Recommence avec l’initialisation de He. Compare avec le tableau du bloc 3. - La patience. Refais le bloc 4 avec early stopping, patience 3 puis 30. À quelle époque s’arrête-t-on, et quelle est l’AUC de test ? Pourquoi une patience trop courte est-elle dangereuse sur une courbe bruitée ?
- La force du weight decay. Refais le bloc 4 avec
weight_decayà 0,01 puis à 1. Que se passe-t-il pour la meilleure époque et pour l’écart entre la meilleure validation et la validation finale ? - Le pas maximal du one-cycle. Refais le bloc 5 avec
max_lrà puis à . Le test d’amplitude avait-il bien choisi ? - Fil rouge. Écris en dix lignes la recette d’entraînement de ton mémoire (pas, planning, régularisation, critère d’arrêt, graines), puis applique le test d’amplitude à ton propre réseau sur une vraie trace DAMON.
Indices. Question 1 : à la fin de ajuster à lr = 10, les 32 neurones de la deuxième couche cachée sont morts, les logits valent tous −0,844 (écart-type
), soit
, le taux de base : la log-loss reste à 0,6116. Le clipping ne sauve rien (0,6116) : il limite la norme du gradient à 1, mais un pas de 10 fois un gradient de norme 1 reste énorme. Le pas de 0,3 donne 0,2827, mieux que tous les réglages de la grille. Question 2 : avec SGD et l’initialisation par défaut, 0,6117, 0,6116, 0,6116 sur les trois époques : le réseau ne quitte jamais la constante. Avec He, 0,2993, 0,2901, 0,2882. Question 3 : patience 3, arrêt à l’époque 20 (meilleure 17, val 0,3263, AUC de test 0,856) : un creux passager de la courbe a été pris pour la fin ; patience 30, arrêt à l’époque 70, même modèle qu’avec 10 (meilleure 40, 0,3106, AUC 0,859). Question 4 : 0,01 ne change presque rien (meilleure 40, 0,3110, puis 0,3606 à la fin) ; 1 retarde la meilleure époque à 138, avec 0,3078 et seulement 0,3127 à la fin, AUC de test 0,864. Question 5 : max
donne 0,2836 (AUC val 0,910, test 0,871), max
donne 0,2776 (AUC val 0,904, test 0,864) ;
(0,2759, 0,915, 0,872) reste le meilleur des trois.
Ressources pour aller plus loin
- Andrej Karpathy, A Recipe for Training Neural Networks (2019) : la méthode « surapprendre d’abord, régulariser ensuite », et les pièges les plus courants.
- Leslie N. Smith, Cyclical Learning Rates for Training Neural Networks (2017) et A disciplined approach to neural network hyper-parameters (2018) : le test d’amplitude et le one-cycle.
- He et al., Delving Deep into Rectifiers (2015) et Glorot & Bengio, Understanding the difficulty of training deep feedforward neural networks (2010) : les deux initialisations, avec le calcul de variance.
- Loshchilov & Hutter, Decoupled Weight Decay Regularization (2019) : pourquoi AdamW plutôt qu’Adam + L2.
- Srivastava et al., Dropout: A Simple Way to Prevent Neural Networks from Overfitting (JMLR, 2014) ; Ba et al., Layer Normalization (2016).
- Dive into Deep Learning, chapitres Optimisation et Perceptrons multicouches (initialisation, dropout).
- Rappels : M10 · Descente de gradient, M11 · Contraintes et régularisation.
Ce que tu dois savoir faire avant de passer à la suite
- Lancer un test d’amplitude du pas et en déduire un pas de départ
- Expliquer pourquoi le momentum multiplie le pas effectif et pourquoi Adam est peu sensible à l’échelle du gradient
- Calculer l’effet d’une initialisation sur la taille du signal, et choisir He pour des ReLU
- Mesurer la norme des gradients couche par couche pour repérer une disparition ou une explosion
- Provoquer un surapprentissage sur un petit échantillon, puis le réduire avec early stopping, weight decay et dropout
- Utiliser un planning de pas (one-cycle) avec
scheduler.step()à chaque batch - Lire une courbe de perte et nommer la panne : divergence, constante, plateau, surapprentissage, sous-apprentissage
Partie suivante : Modèles de séquences : RNN, LSTM et attention (partie 23). Jusqu’ici, le réseau ne voit qu’un résumé du passé (les 9 features). On va lui donner la séquence brute des accès et le laisser construire lui-même sa mémoire, en appliquant cette recette d’entraînement.